Fonctionnalités
Tout est dans la version 3.21.0, gratuite, sans fonctionnalité payante. Chaque section renvoie à sa page de documentation.
Audit et score de santé
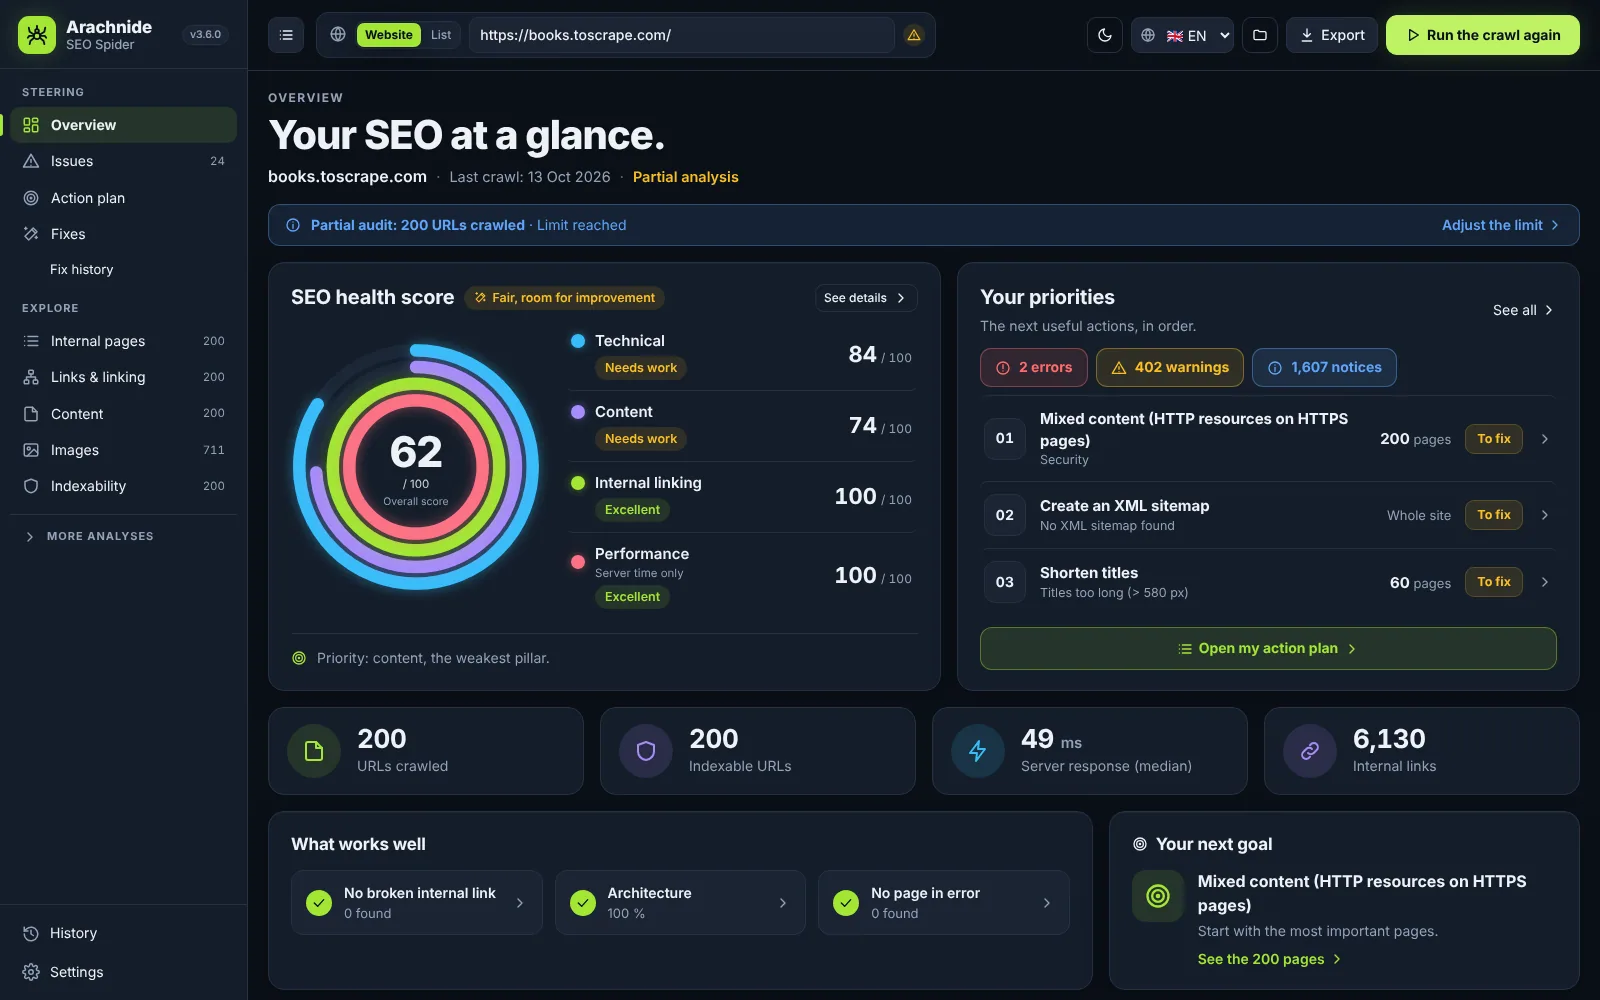
Un crawl vous donne un score de santé sur 100 avec une note A–F, quatre scores de pilier (technique, contenu, maillage interne, performance), vos priorités comptées en pages uniques, des indicateurs clés, ce qui fonctionne bien et votre prochain objectif. Un pilier sans données est affiché « non mesuré », jamais comme un bon score.
- Environ 95 contrôles en 14 familles : codes de réponse, redirections, titres et metas, titres Hn, contenu, images, indexation, architecture, sitemaps, international, données structurées, JavaScript, performance et sécurité, URL, IA et GEO.
- Link Score (PageRank interne), profondeur de clic, pages orphelines, quasi-doublons (simhash), cannibalisation de mots-clés, largeur des titres et descriptions en pixels avec aperçu SERP Google.
- Rendu JavaScript avec le Chrome ou Edge déjà installé : HTML brut contre page rendue, erreurs JS, LCP et CLS.
Problèmes SEO et plan d’action
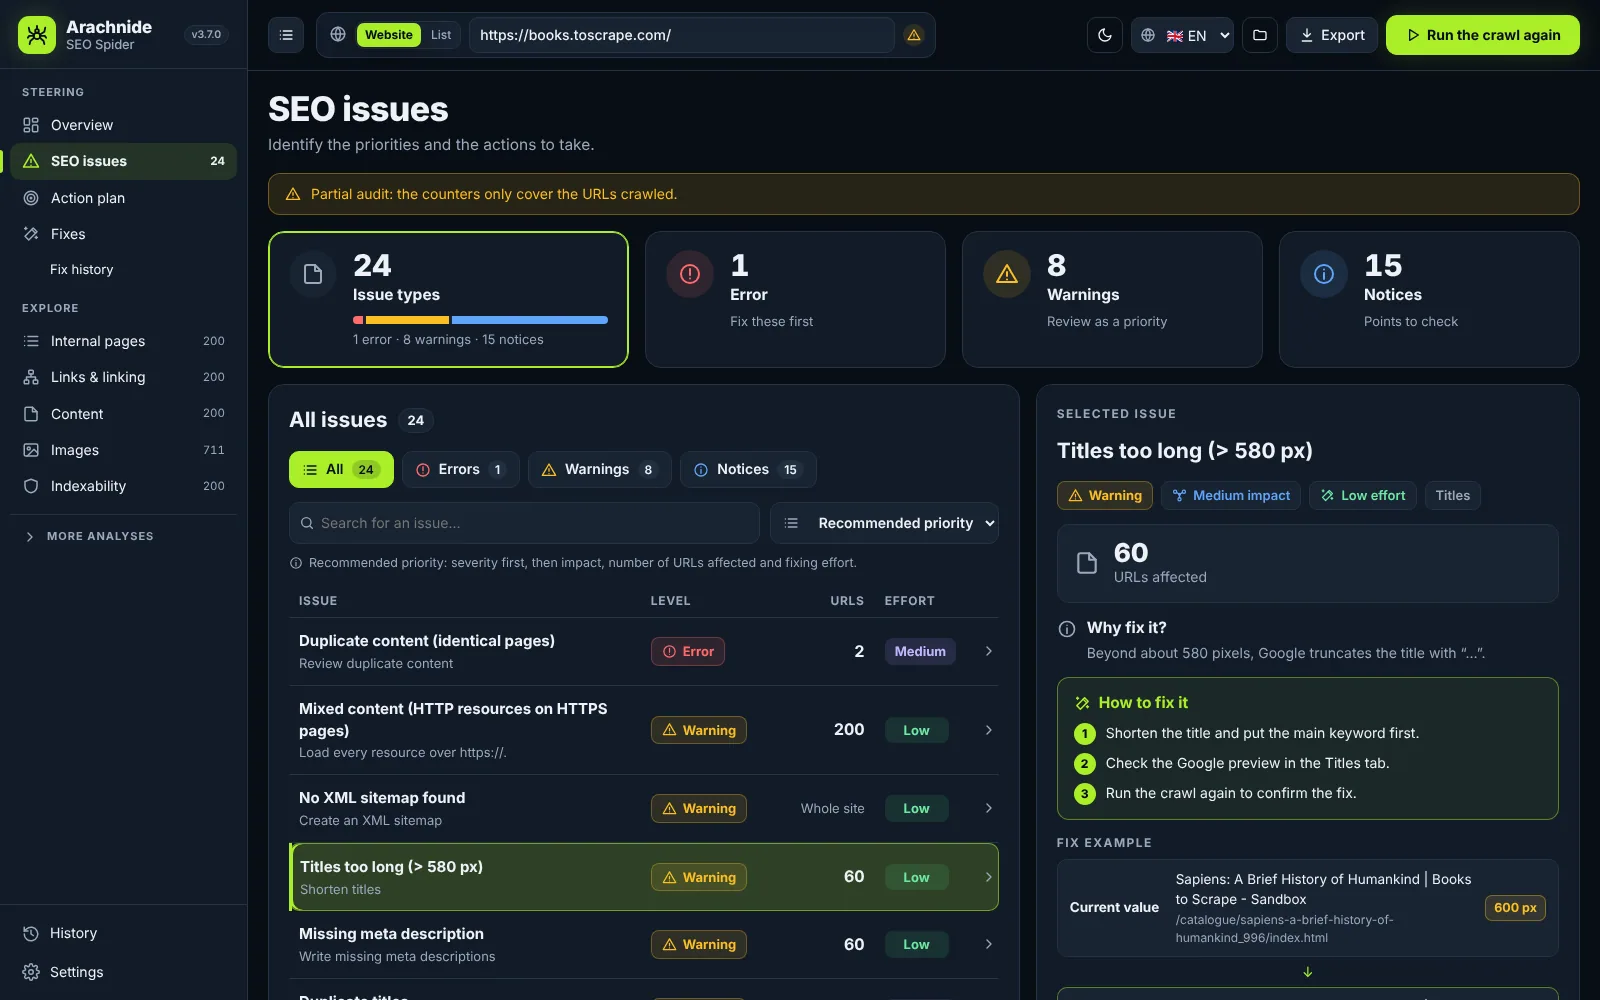
La page Problèmes montre ce qui a été trouvé, sa gravité, le nombre d’URL uniques concernées et l’effort nécessaire, avec un panneau de correction : pourquoi c’est important, des étapes numérotées, un exemple avant / après pris sur une page réelle, et la liste des URL à exporter.
- Priorité recommandée : les erreurs d’abord, puis les avertissements, puis les notices, classés par gravité × impact × URL ÷ effort.
- Le plan d’action transforme chaque problème en action avec un verbe, un rang, un critère « terminé quand », un statut (à faire, en cours, à valider) et des notes enregistrées dans votre navigateur par site.
- Seul un nouveau crawl qui ne détecte plus le problème le marque comme résolu.
Corriger en 1 clic et connecteurs
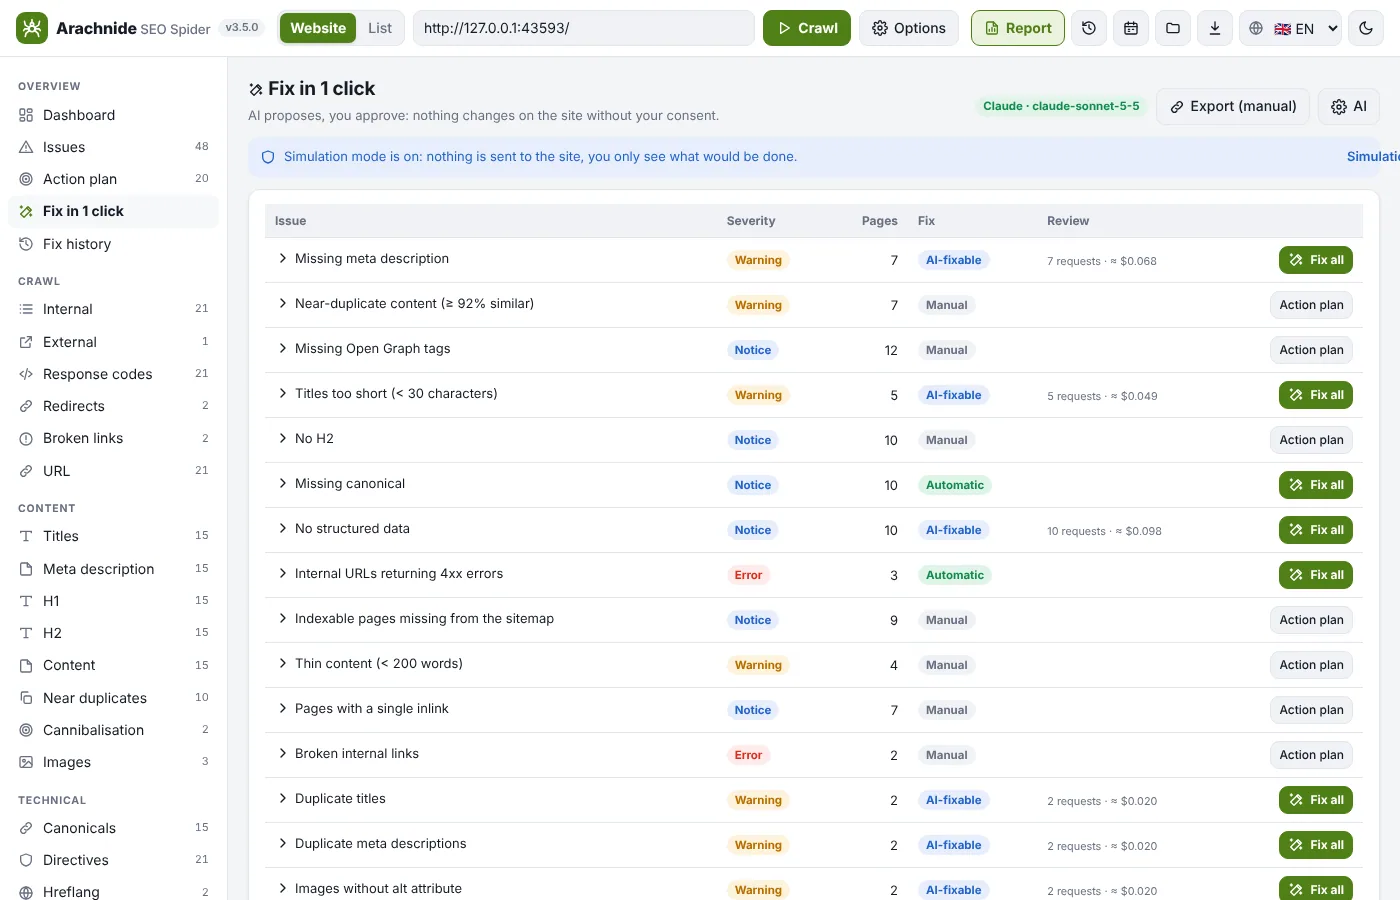
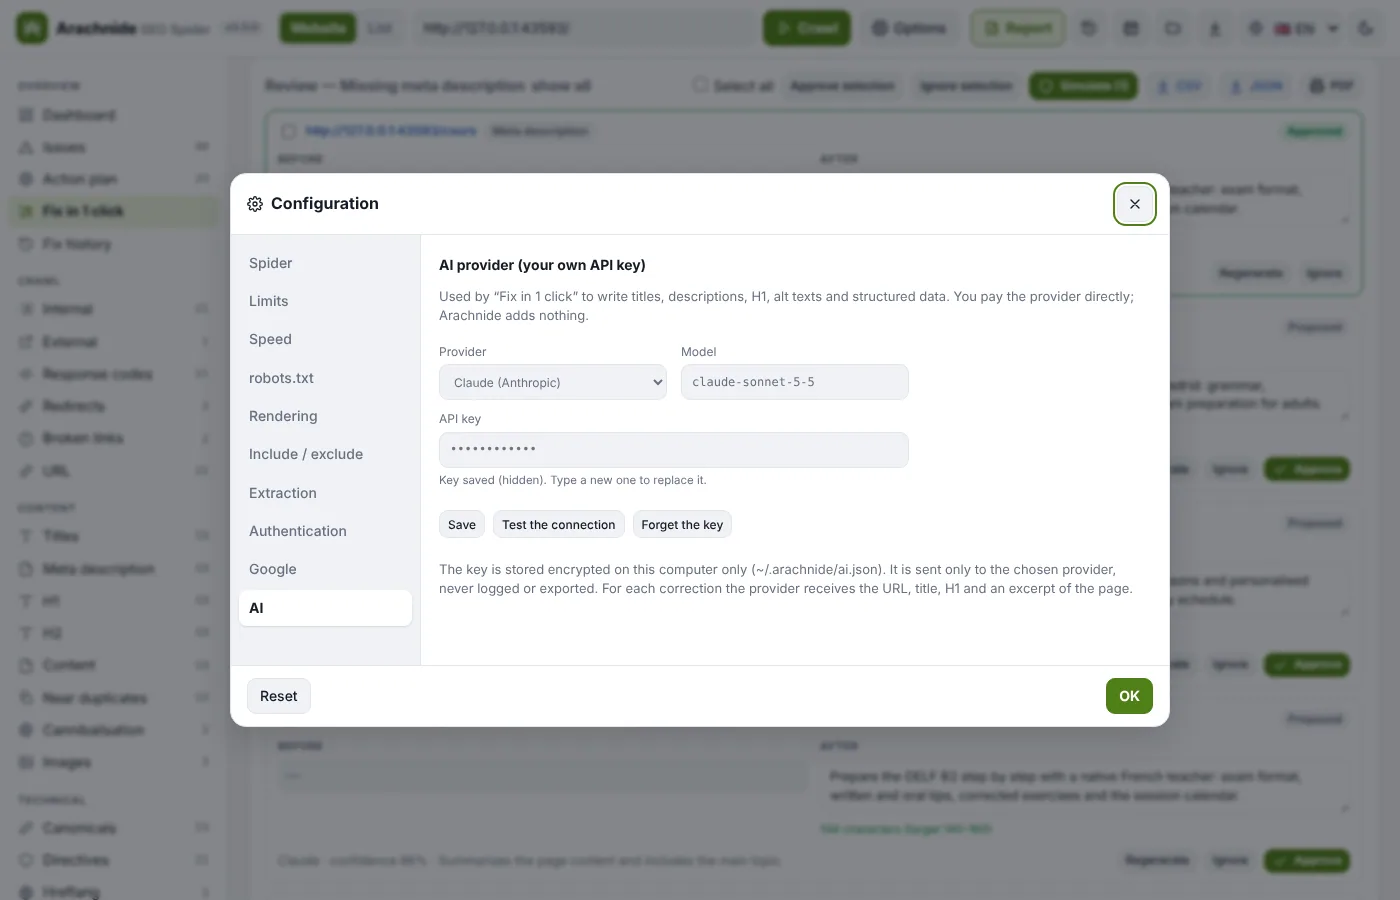
Depuis la 3.5, Claude (Anthropic) ou ChatGPT (OpenAI) rédigent titres, meta descriptions, H1, textes alternatifs et JSON-LD à partir du contenu réel de chaque page, avec votre propre clé API. Redirections 301, canonicals, noindex accidentels et liens vers des redirections sont calculés sans IA. Vous relisez, approuvez, et un connecteur applique le changement.
- Connecteurs : WordPress (plugin compagnon), Drupal, Joomla, PrestaShop, Shopify, Webflow, Wix, fichiers (HTML statique plus _redirects, .htaccess, nginx ou vercel.json), Cloudflare Worker, pull request GitHub, et un mode manuel avec le chemin de clics exact.
- Détection automatique du CMS, mode simulation par défaut, politique par site (champs autorisés, taille des lots, lecture seule), historique et annulation d’une correction ou d’un lot, PDF « corrections appliquées ».
- Clés et identifiants sont stockés chiffrés sur votre ordinateur et envoyés uniquement au fournisseur ou au CMS concerné.
Cartographie 2D et 3D
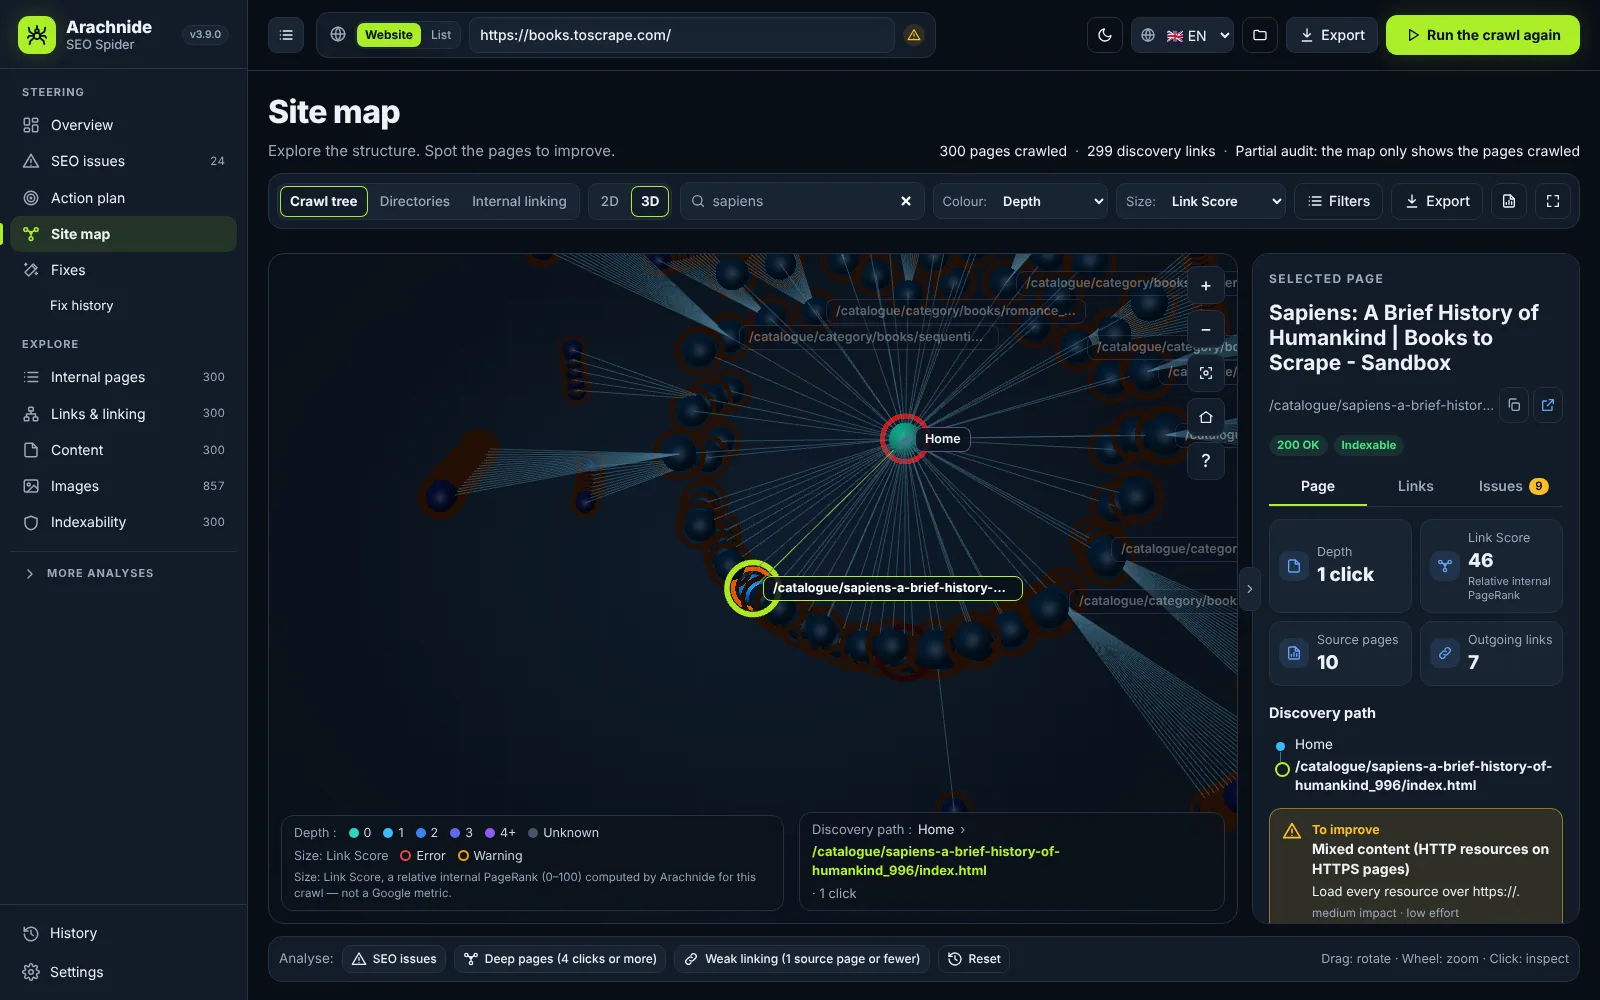
Deux vues complémentaires partagent les mêmes données, filtres, recherche et inspecteur. La cartographie est l’arbre horizontal classique façon Screaming Frog sur fond blanc, fait pour les captures et les rapports clients. La visualisation 2D / 3D est la vue d’exploration : style sombre, disposition radiale, colorée par problèmes SEO par défaut.
- Trois représentations : arbre de crawl (plus court chemin de clics depuis l’accueil), répertoires (structure des URL) et maillage interne (les vrais liens orientés).
- Filtres par dossier, motifs d’URL (texte, joker ou regex), problèmes, profondeur, statut, indexabilité, maillage entrant faible, plage de Link Score ; surligner ou isoler.
- Inspecteur de page avec statut, profondeur, Link Score, pages sources, chemin de découverte et problèmes ; exports PNG et PDF avec en-tête, légende et contexte.
Segments
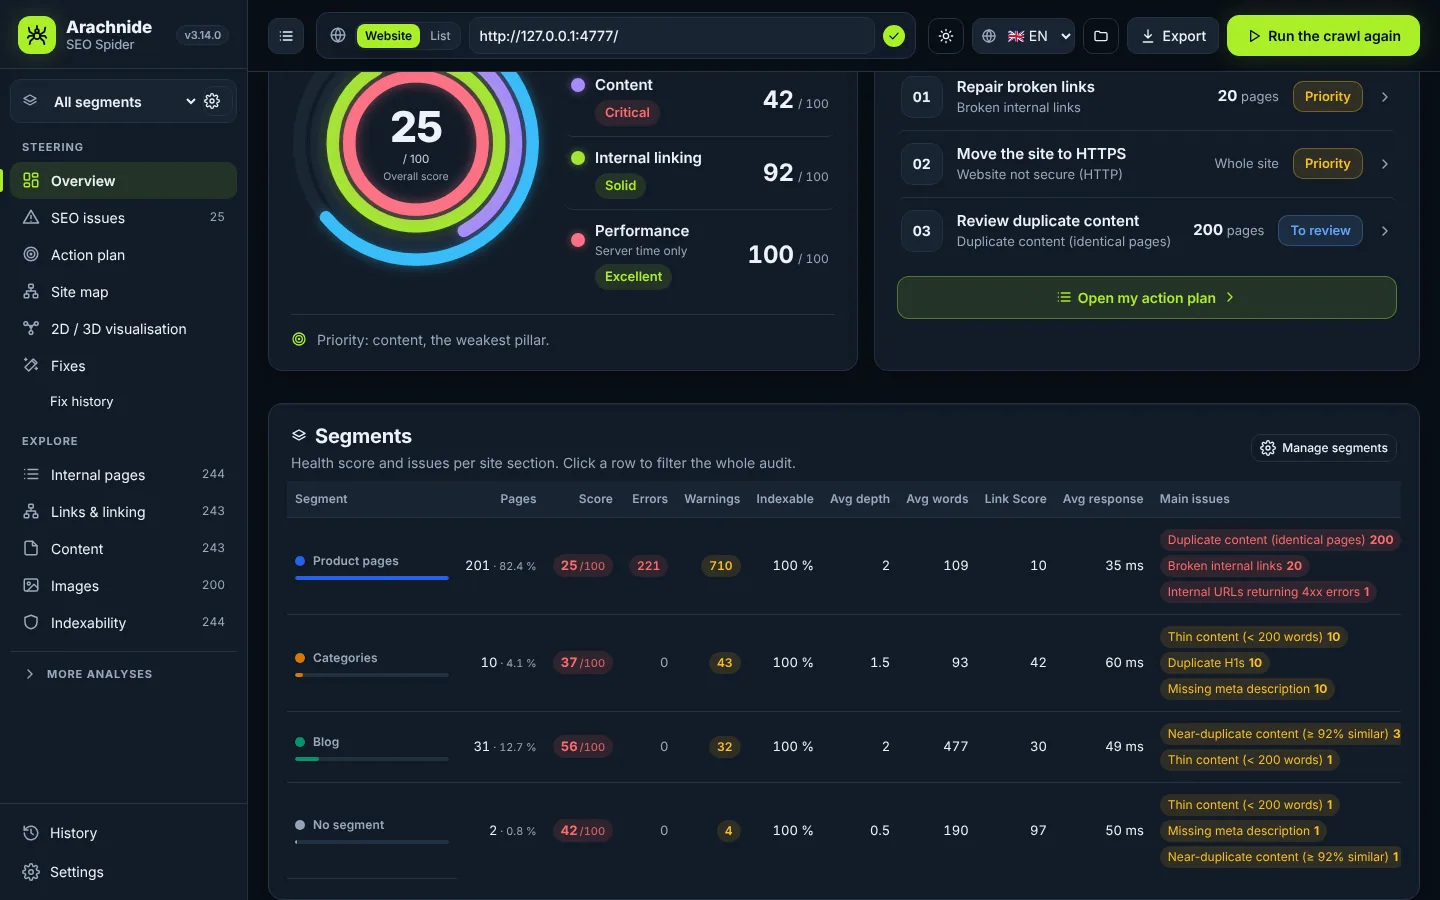
Sur un gros site, un score global cache où sont vraiment les problèmes. Les segments (3.14) découpent l’audit en sections nommées, exactement comme les segments de Screaming Frog : fiches produit, catégories, blog, une langue, pages sans trafic.
- Règles sur 20 champs (chemin, URL, title, H1, statut, indexabilité, profondeur, mots, liens entrants, Link Score, temps de réponse, type de données structurées, langue, clics Search Console, sessions GA4, extractions personnalisées) avec opérateurs texte, nombre et booléens, combinés en ET / OU.
- Premier segment gagnant ; « créer depuis les répertoires » construit un segment par dossier de premier niveau en un clic.
- Appliqués après le crawl sans recrawler ; un filtre global recalcule tableau de bord, score, problèmes, plan d’action, tables, exports CSV et rapport PDF pour cette section.
Données Google
Connectez les données Google qu’un crawler ne voit pas : PageSpeed Insights et Core Web Vitals d’utilisateurs Chrome réels (CrUX), clics, impressions, CTR et position Search Console par URL, et sessions Google Analytics 4.
- Search Console par compte de service en lecture seule ou par import CSV ; Google Analytics 4 par API ou CSV (3.15).
- Trouve les pages que Google voit mais que vos liens n’atteignent pas, les pages orphelines qui reçoivent encore du trafic, les pages à CTR faible et les pages non indexables avec du trafic.
- Crawls planifiés (quotidien, hebdomadaire, mensuel) avec alertes e-mail quand le score baisse ou que des erreurs apparaissent, comparés au crawl précédent, rapport complet joint.
Rapports clients
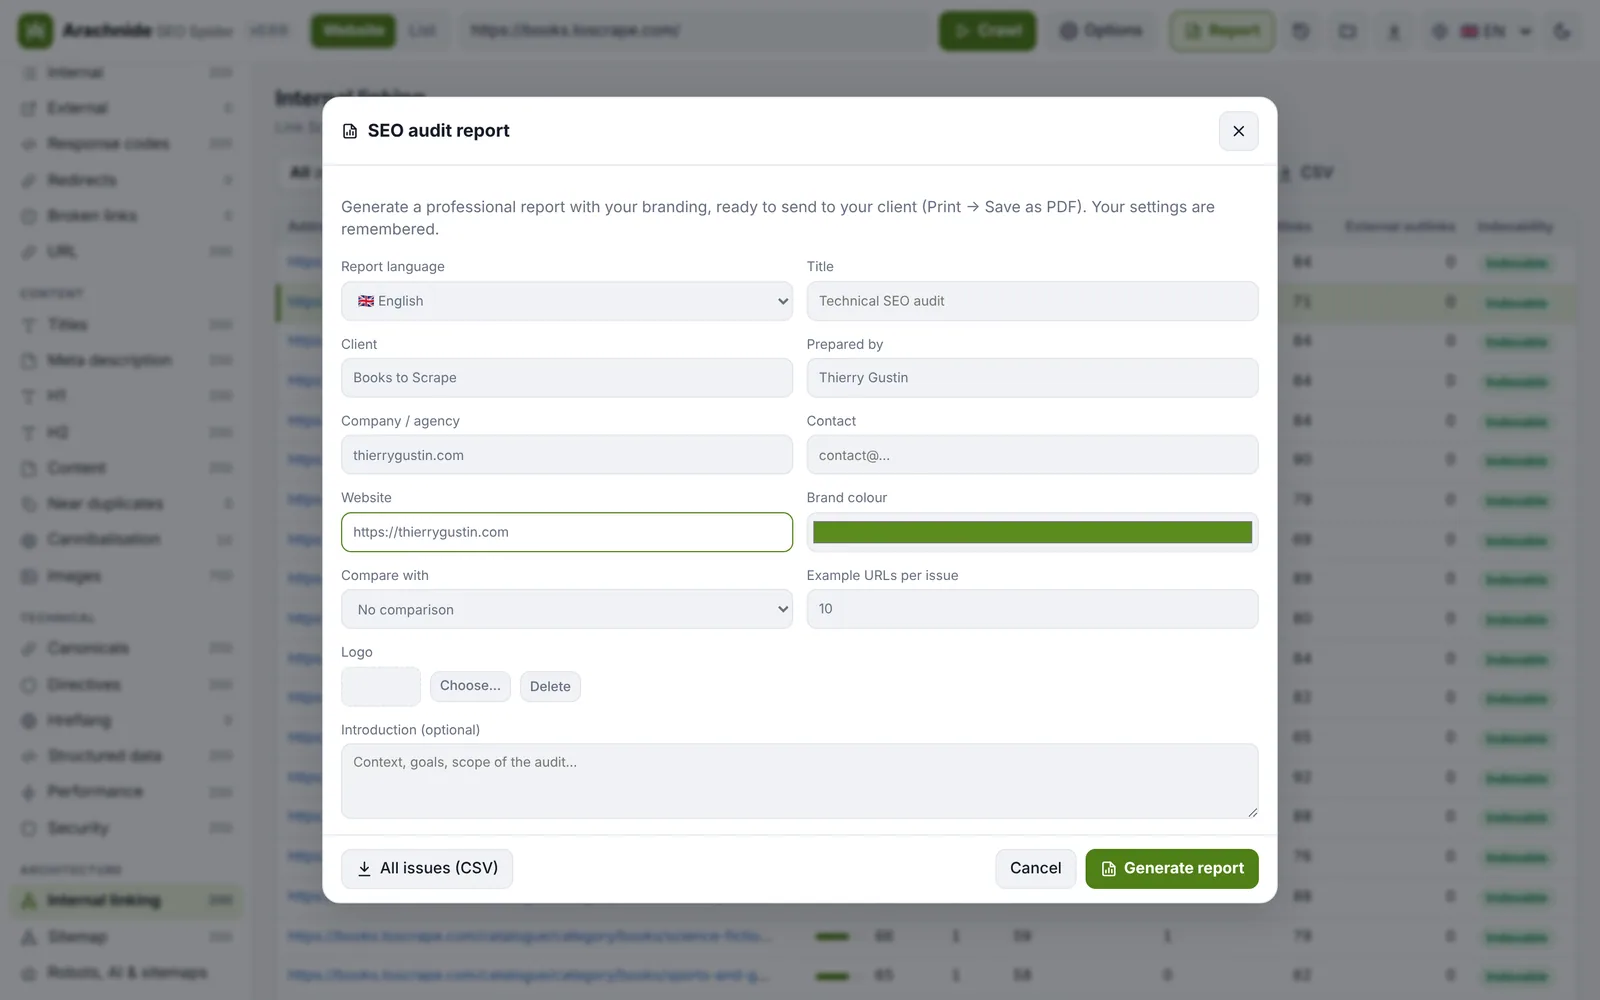
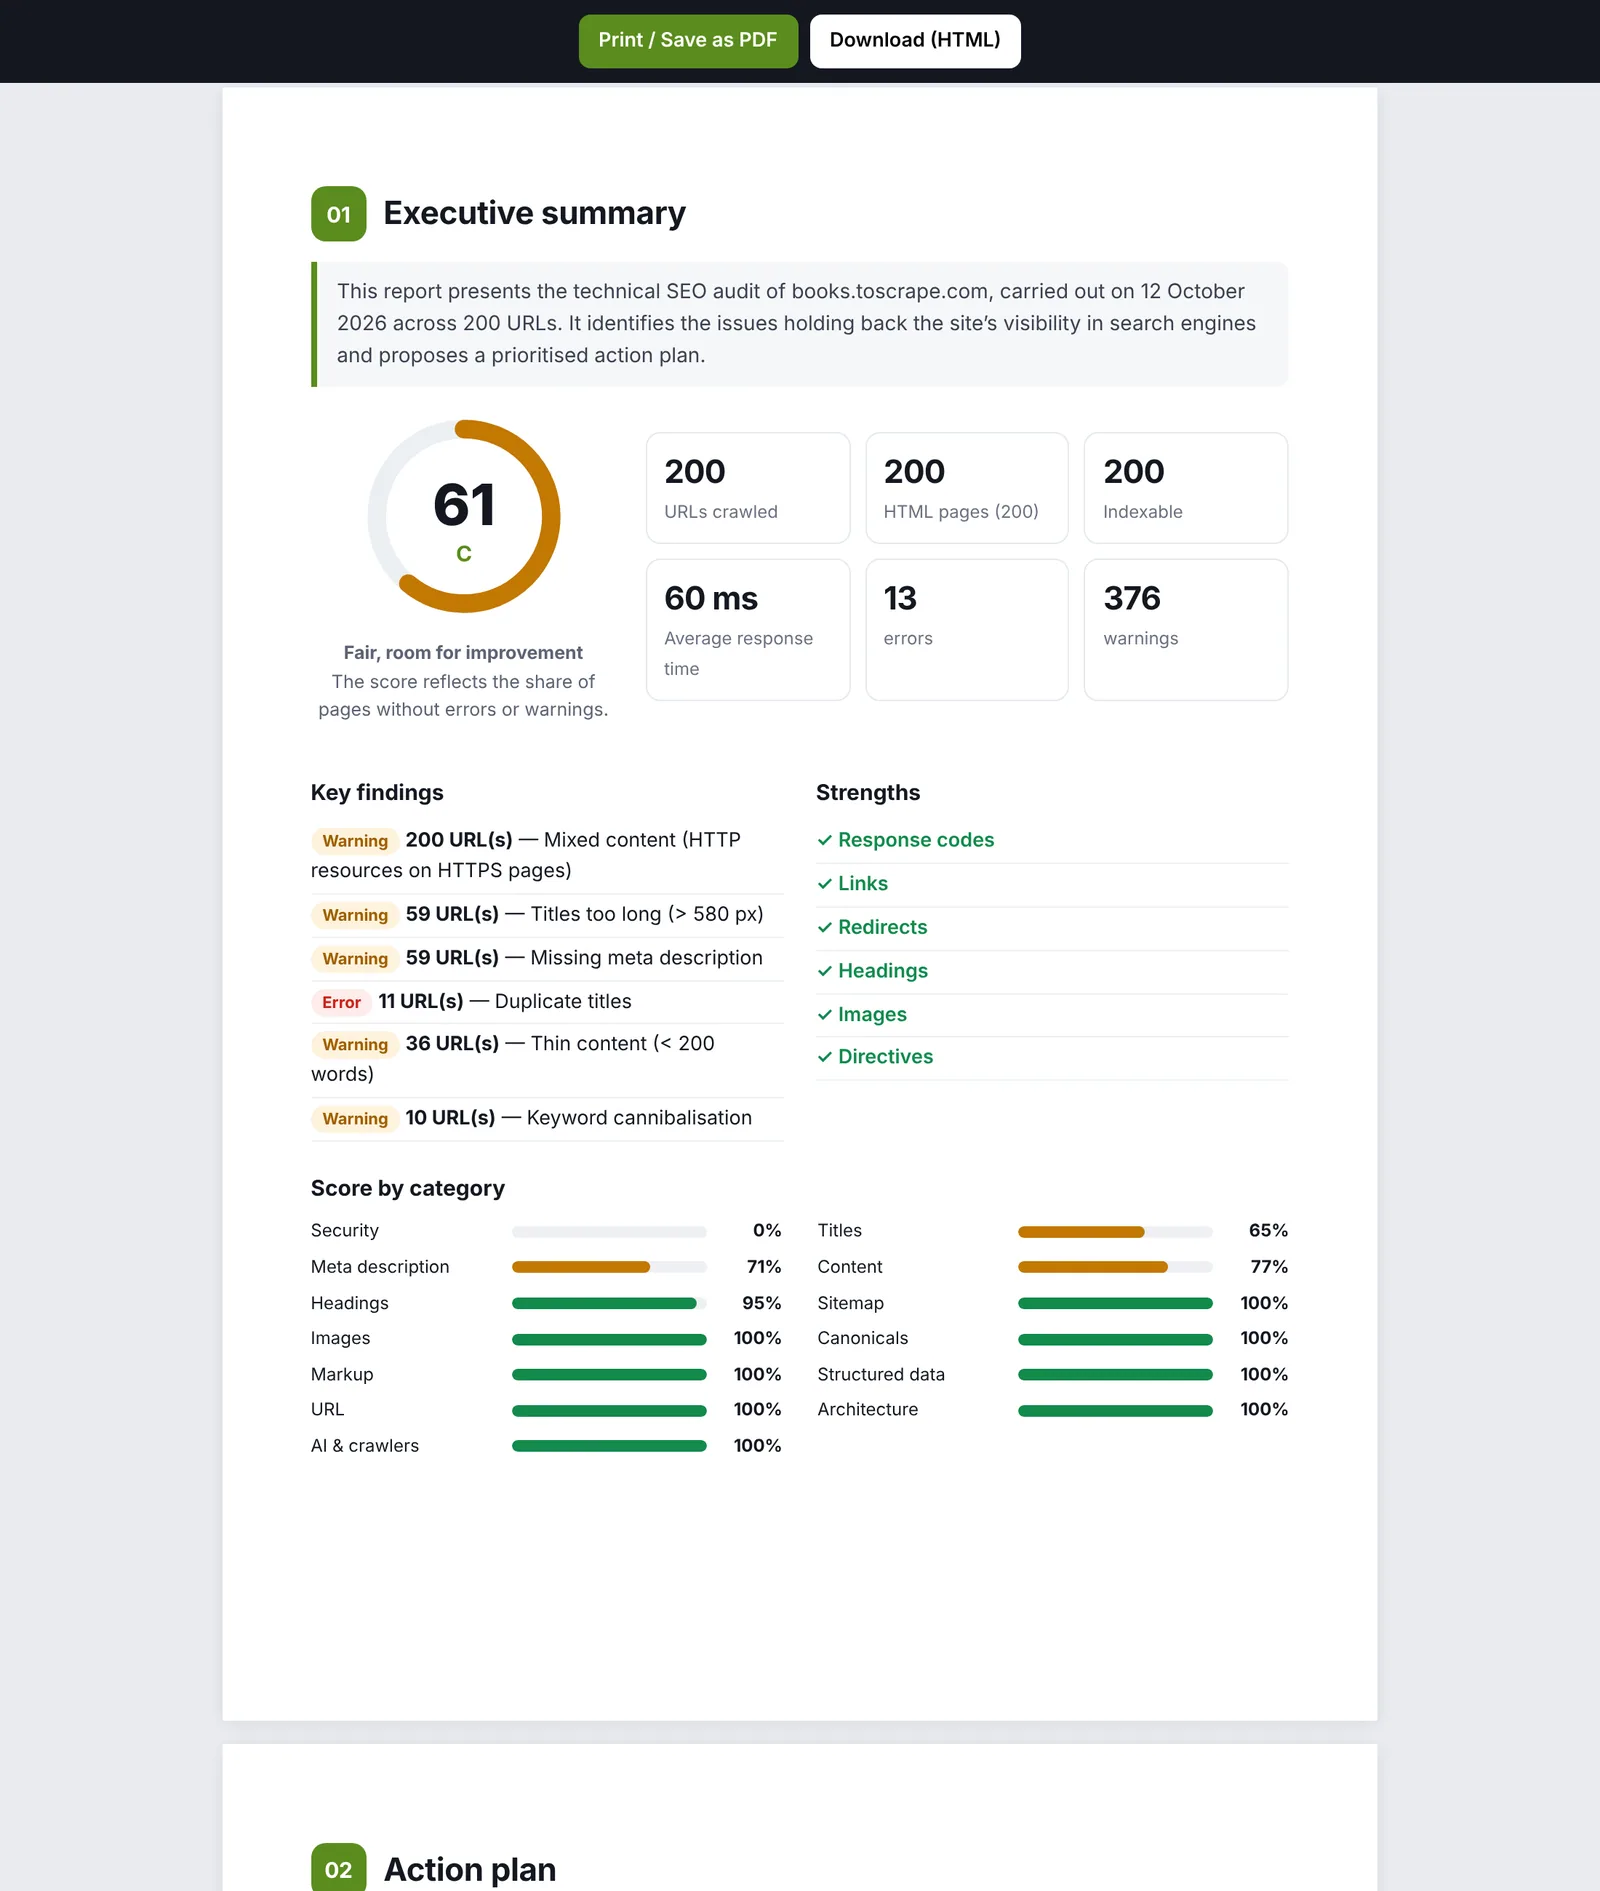
Un rapport HTML en marque blanche qui s’imprime en PDF, en six langues : votre logo, votre couleur, le nom du client et vos coordonnées, une synthèse exécutive, les constats clés, les scores par catégorie, un plan d’action en trois niveaux de priorité, une analyse détaillée avec exemples d’URL et la méthodologie.
- Comparaison avec un crawl précédent du même site : évolution du score, problèmes corrigés, nouveaux ou aggravés, URL par URL.
- Résultats par segment quand des segments sont définis ; un rapport pour un seul segment le nomme sur la couverture.
- CSV de tous les problèmes et de toutes les pages pour votre client ou votre développeur.
Agents IA et GEO
Depuis la 3.13, Arachnide est conçu pour être piloté par un agent IA : le vôtre, ou tout assistant qui parle MCP (Claude) ou OpenAPI (Actions ChatGPT, LangChain, n8n, Make). Trois portes, un seul jeu de 25 outils définis une fois.
- MCP en stdio (Claude Desktop, Claude Code), MCP en HTTP (connecteurs personnalisés claude.ai, agents hébergés, Claude Agent SDK) et REST + OpenAPI 3.1 importable comme Action ChatGPT en un clic.
- Score de préparation GEO sur 100 : accès des crawlers IA (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended…), llms.txt, couverture des données structurées, profondeur du contenu, hygiène.
- Jeton d’accès créé au premier lancement, 240 requêtes par minute et par IP, journal des derniers appels dans l’application, outils d’écriture marqués comme conséquents.
Extraction personnalisée et recherche
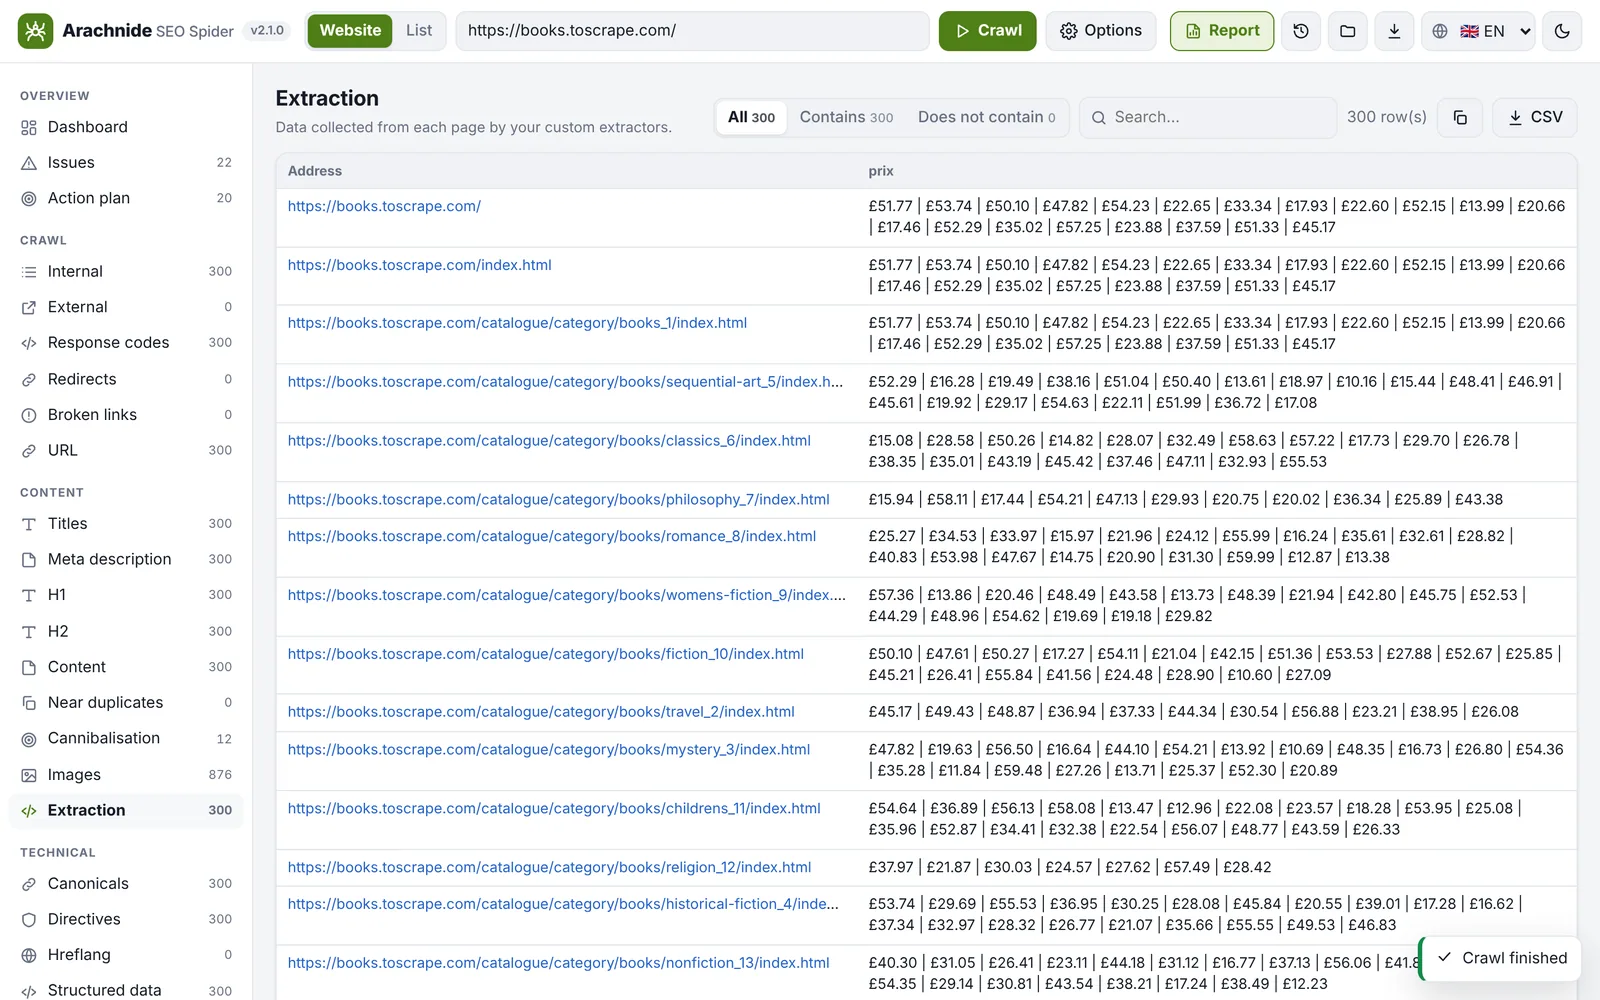
Collectez n’importe quelle donnée sur chaque page : prix, auteur, date, référence, code de suivi. Jusqu’à 20 extracteurs par sélecteur CSS (texte, attribut, HTML ou nombre), XPath (3.21) ou regex, avec un onglet Extraction et une colonne par règle dans l’export CSV.
- Recherche personnalisée : toutes les pages contenant un texte ou une regex, comme un ancien numéro de téléphone ou un code de suivi.
- Les extractions peuvent piloter des segments (extract:Prix) et la ligne de commande accepte les mêmes règles avec --extract.
- Une regex qui s’emballe est interrompue dans un worker au bout de 2 s au lieu de bloquer le crawl.
Ligne de commande
Tout ce que fait l’interface, depuis un terminal ou une tâche cron : node src/cli.mjs <url> [options]. La CLI affiche le score et les problèmes dans votre langue, enregistre le crawl en NDJSON gzip que l’interface peut ouvrir, et exporte le CSV et le rapport HTML.
- JSON (NDJSON gzip), pages.csv et issues.csv, rapport HTML personnalisé, comparaison avec un crawl précédent, segments, alertes e-mail pour cron.
- --resume reprend un crawl interrompu depuis son journal ; --sitemap crawle exactement les URL d’un sitemap ; --extract ajoute une colonne CSV par règle.
- Mêmes options que l’interface : limites, vitesse, modes robots.txt, agents utilisateur, authentification, inclure / exclure, données Google.
Échelle et performances
Les versions 3.16 à 3.21 forment un programme de passage à l’échelle en six étapes : graphe de liens compact en colonnes de tableaux typés (14 octets par lien), NDJSON gzip écrit en flux, journal de reprise, une analyse qui compare toutes les pages pour les quasi-doublons, et un navigateur qui ne reçoit plus jamais le crawl entier.
- Testé sur un site synthétique local de 200 000 pages et 19,9 millions de liens avec npm run bench -- --pages 200000 : crawl et analyse en 2 086 s (environ 96 pages par seconde), sauvegarde en 38 s dans un fichier de 62,5 Mo, mémoire maximale 2,7 Go.
- Garde-fous de crawl : le budget compte les pages téléchargées, les paramètres de suivi sont supprimés, les pièges à facettes sont signalés, un robots.txt injoignable interdit tout comme l’exige la RFC 9309.
- Le budget par défaut est de 500 pages : relevez-le dans Options → Limites pour un gros site.