Configuration du crawl
Toutes les options de crawl avec leur valeur par défaut - limites, vitesse, robots.txt, rendu, périmètre, extraction, authentification, modes liste et sitemap.
Cliquez sur Options (l’engrenage) pour ouvrir la fenêtre Configuration, calquée sur la configuration du spider d’un crawler de bureau. Vos réglages sont mémorisés, sauf le mot de passe HTTP et les en-têtes personnalisés, qui portent souvent un cookie de session ou un jeton.
| Onglet | Réglages |
|---|---|
| Spider | Lire les sitemaps XML, suivre les canonicals, inclure les sous-domaines, vérifier les liens externes et les images |
| Limites | Total du crawl, profondeur de crawl, URLs par niveau de profondeur, profondeur de dossiers, paramètres d’URL, redirections suivies, longueur d’URL, liens par page, poids de page, limites par chemin d’URL (/blog/ = 200, une par ligne) |
| Vitesse | Nombre max. de threads, URLs max par seconde, délai d’attente |
| robots.txt | Respecter / ignorer mais signaler / ignorer, robots.txt personnalisé, testeur d’URL |
| Rendu | Rendu JavaScript, user-agent (Arachnide, Googlebot desktop/smartphone, Chrome), Accept-Language |
| Inclure / exclure | Regex d’inclusion / d’exclusion, suppression de paramètres d’URL (utm_*, gclid), ignorer tous les paramètres, recherche personnalisée |
| Extraction | Jusqu’à 20 extracteurs : sélecteur CSS (texte, attribut, HTML ou nombre) ou regex |
| Authentification | Utilisateur et mot de passe HTTP, en-têtes personnalisés (cookies, jetons) |
Spider
- Lire les sitemaps XML (activé) : les sitemaps déclarés dans
robots.txtou à/sitemap.xmlsont lus, index et fichiers.gzcompris, et leurs URL mises en file. Les sitemaps images et vidéos sont ignorés ; 500 fichiers de sitemap au maximum. - Suivre les canonicals (activé) : une canonical vers une URL non crawlée la met en file.
- Inclure les sous-domaines (désactivé) :
blog.example.comfait partie deexample.comseulement si l’option est active. Un autre port n’est jamais le site audité. - Vérifier les liens externes et vérifier les images (poids, statut, format) sont désactivés par défaut pour garder les crawls clients légers.
Limites
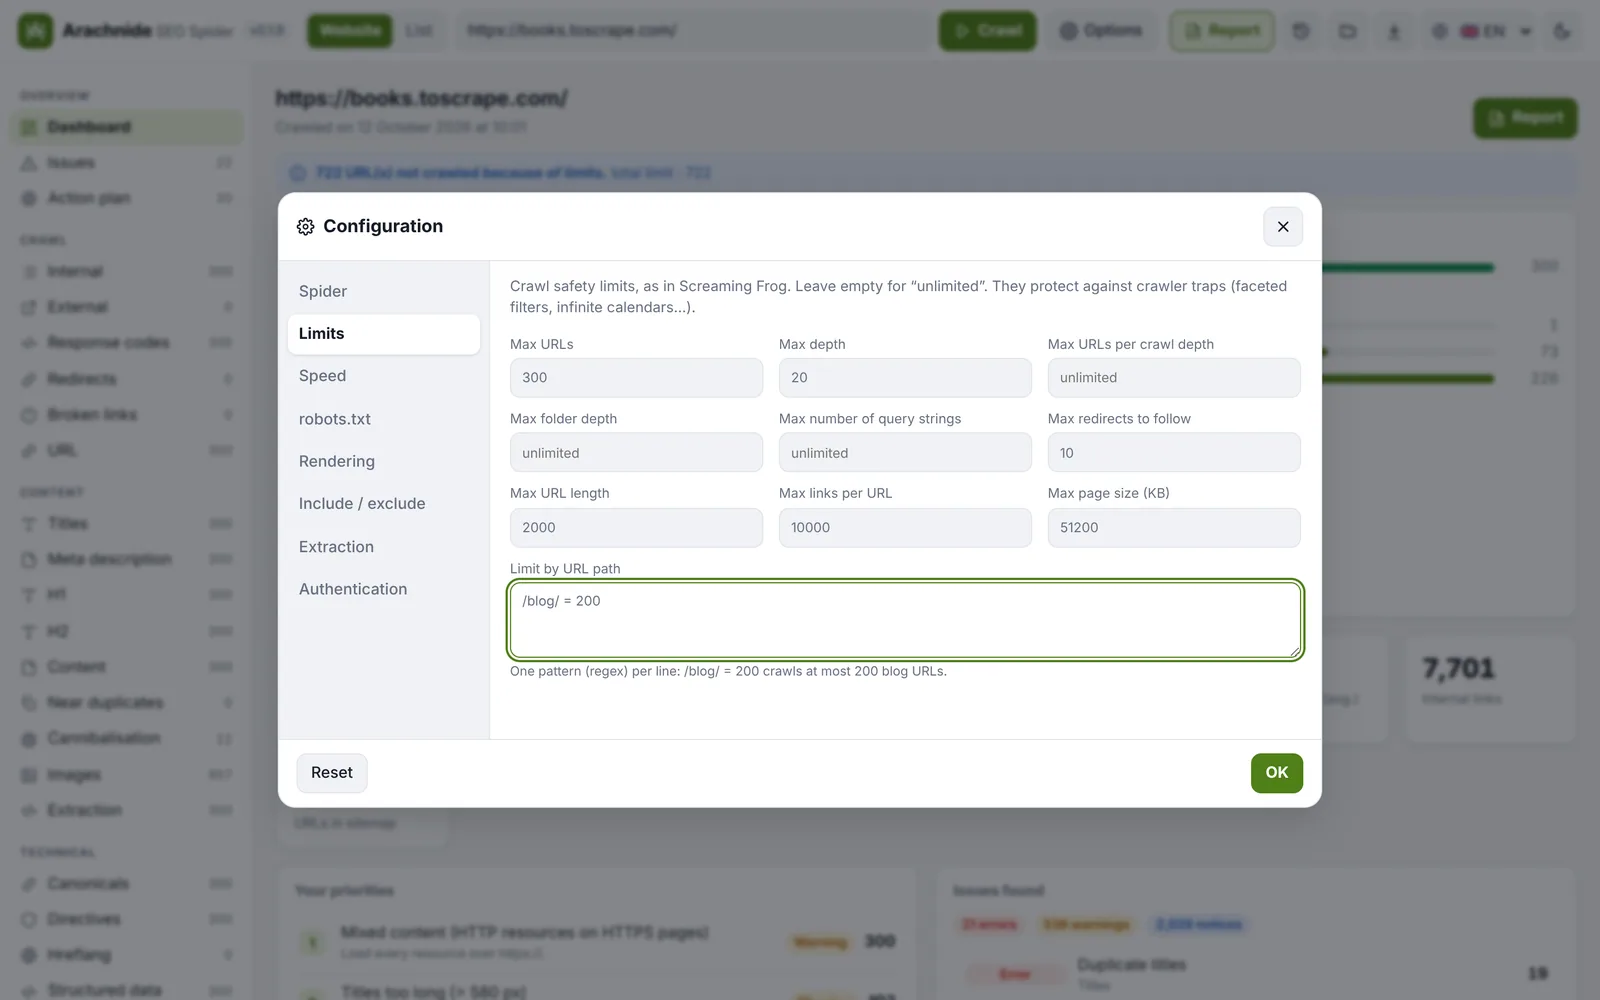
| Réglage | Par défaut | Notes |
|---|---|---|
Total du crawl (maxPages) | 500 | Compte les pages réellement téléchargées ; les URL bloquées par robots.txt ne le consomment pas. Jusqu’à 10 000 000. |
Profondeur (maxDepth) | 20 | Les redirections n’ajoutent pas de profondeur. |
URL par niveau, profondeur de dossier, paramètres, redirections suivies (10), longueur d’URL, liens par page, poids de page (maxPageSizeKb) | — | Les URL ignorées sont comptées par motif sur le tableau de bord. Les corps de réponse sont lus en flux et abandonnés au-delà de la limite. |
| Limites par chemin d’URL | — | Une par ligne, ex. /blog/ = 200. |
Vitesse
- Threads maximum (
concurrency) : 5 par défaut, de 1 à 30. Sur un site client, restez entre 2 et 5. - URL par seconde maximum (
maxUrlPerSec) : un plafond global, utile sur un hébergement mutualisé. - Délai entre les requêtes par worker, et timeout.
Les réponses de limitation (429 et 503 avec Retry-After) sont respectées et réessayées ; 500, 502, 504 et les erreurs de connexion ont droit à un nouvel essai différé en fin de file.
robots.txt
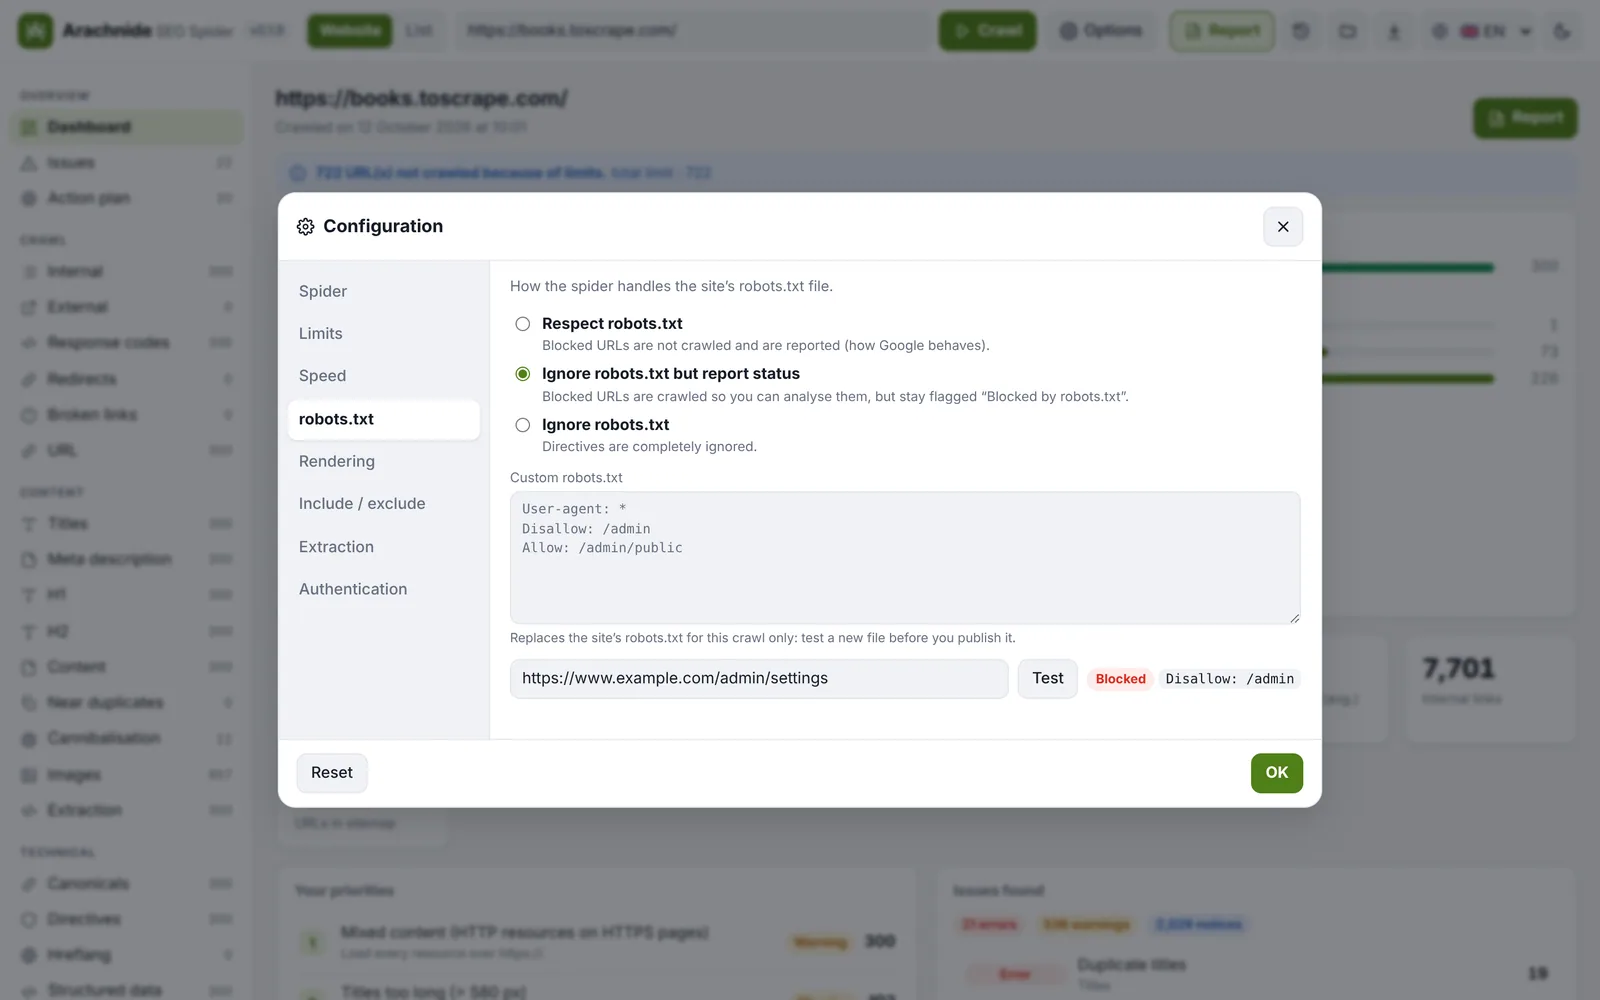
Trois modes : respecter (par défaut), ignorer mais signaler (les URL bloquées sont crawlées et quand même signalées) et ignorer. Vous pouvez coller un robots.txt personnalisé pour tester un fichier avant de le publier, et le testeur intégré dit si une URL est autorisée et quelle règle s’applique. Arachnide suit les règles de Google pour le robots.txt (RFC 9309) :
- un robots.txt qui répond 4xx signifie que tout est autorisé ;
- un robots.txt en 5xx ou injoignable signifie que tout est interdit, avec un avertissement explicite. Deux portes de sortie : l’option robots.txt indisponible → autoriser (
--robots-unavailable allow), ou le mode signaler / ignorer ; - en mode liste et avec les sous-domaines, le robots.txt est lu une fois par hôte.
Rendu
Le rendu JavaScript utilise le Chrome, Edge, Chromium ou Brave déjà installé (via puppeteer-core ; rien n’est téléchargé). Arachnide compare le HTML brut et la page rendue (contenu, liens, title, H1, canonical, noindex), signale les erreurs JS et les redirections JavaScript, et mesure LCP et CLS en laboratoire. Chrome est redémarré toutes les 500 pages rendues pour borner sa mémoire, et redémarré une fois s’il meurt.
Agent utilisateur : Arachnide (par défaut), Googlebot ordinateur, Googlebot smartphone, Chrome, ou une chaîne personnalisée. Comme Googlebot, aucun en-tête Accept-Language n’est envoyé par défaut ; vous pouvez en définir un. Si un site répond 403 à l’agent Arachnide, le crawl bascule automatiquement sur Chrome et le dit.
Inclure / exclure
- Inclure et exclure : une expression régulière par ligne. Une ligne invalide est ignorée et signalée. L’URL de départ est toujours crawlée.
- Rester dans le dossier de départ :
https://example.com/blog/ne crawle que/blog/…. - Supprimer des paramètres d’URL comme
utm_*ougclid(jokers acceptés). Depuis la 3.21, les paramètres sont triés par clé et les paramètres de suivi connus (utm_*,gclid,fbclid,msclkid,mc_cid,srsltid,_ga…) sont supprimés par défaut, si bien que?a=1&b=2et?b=2&a=1sont une seule page ; garder les paramètres tels quels rétablit le comportement brut. - Ignorer tous les paramètres, et recherche personnalisée (un texte ou une
/regex/à trouver dans le code source). - Un chemin qui produit 200 variantes de paramètres est signalé une fois comme piège à facettes, la signature de filtres combinables qui mangent le budget.
Extraction
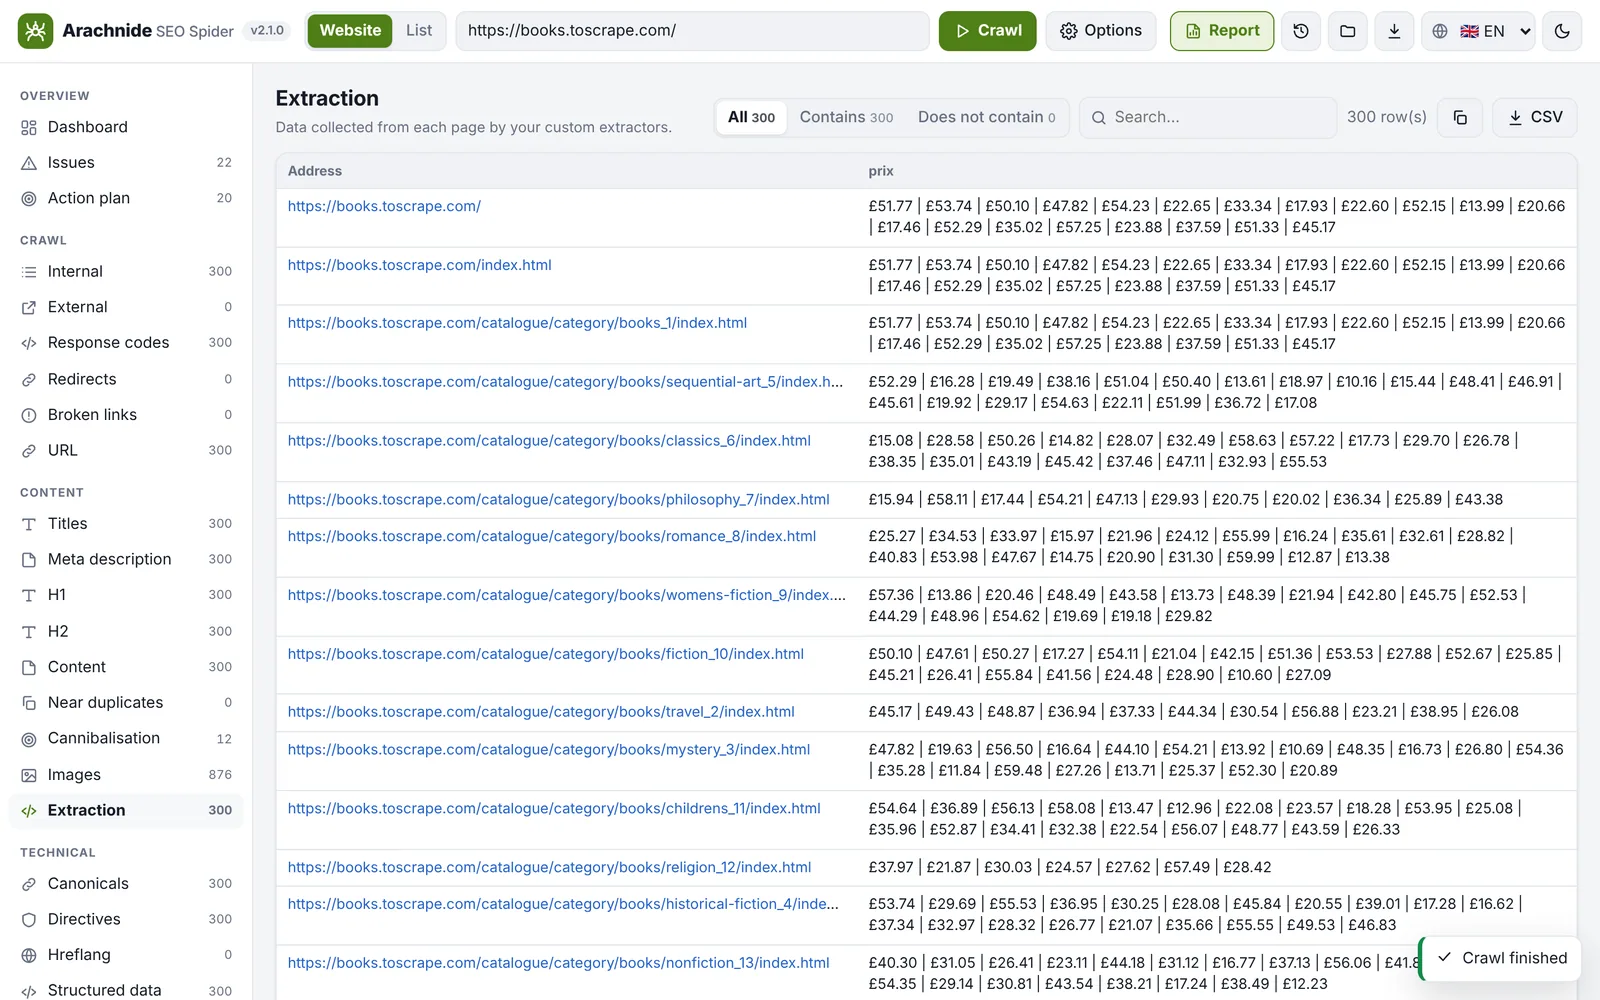
Jusqu’à 20 extracteurs, chacun avec un nom et une règle :
- Sélecteur CSS avec une cible : texte, attribut, HTML interne ou nombre d’occurrences ;
- XPath (3.21) : évalué dans Chrome en mode rendu, ou sur le HTML brut via
jsdom, une dépendance facultative chargée seulement quand une règle XPath existe (npm install jsdomsi vous voyez l’avertissement) ; - Regex, exécutée dans un worker avec un délai de 2 secondes : un motif catastrophique est interrompu pour cette page et le crawl continue.
Les valeurs apparaissent dans l’onglet Extraction, dans une colonne par règle dans pages.csv, et peuvent piloter des segments avec le champ extract:<nom>. La ligne de commande accepte les mêmes règles avec --extract (voir Ligne de commande).
Authentification
Authentification HTTP (utilisateur et mot de passe) et en-têtes personnalisés (cookies, jetons) pour les sites de préproduction. Ils ne sont envoyés qu’au site audité, aussi en mode rendu, et ne sont jamais enregistrés.
Modes site web, liste et sitemap
Le sélecteur à côté du champ d’adresse choisit entre crawler un site web (en suivant les liens) et une liste d’URL que vous collez (jusqu’à 500 000 URL depuis la 3.21 ; les liens ne sont pas suivis, le maillage interne est non mesuré). La ligne de commande ajoute --list urls.txt et --sitemap URL, qui crawle exactement les URL d’un sitemap ou d’un index de sitemaps, dédoublonnées et normalisées. Les agents IA ont les mêmes modes via mode, urls et sitemap_url sur les outils de crawl.
Reprendre un crawl interrompu
Pendant un crawl, Arachnide écrit un journal de reprise (crawls/.en-cours/<id>.ndjson) : chaque URL mise en file, chaque page traitée. Après un plantage ou un arrêt, le journal est listé sur l’écran d’accueil et le crawl peut reprendre là où il s’est arrêté, en ne perdant que les dernières secondes. Le journal est supprimé quand le crawl se termine. En ligne de commande : --resume FICHIER, ou --no-journal pour ne rien écrire.