Funzionalità
Tutto è nella versione 3.21.0, gratuita, senza alcuna funzionalità a pagamento. Ogni sezione rimanda alla sua pagina di documentazione.
Audit e punteggio di salute
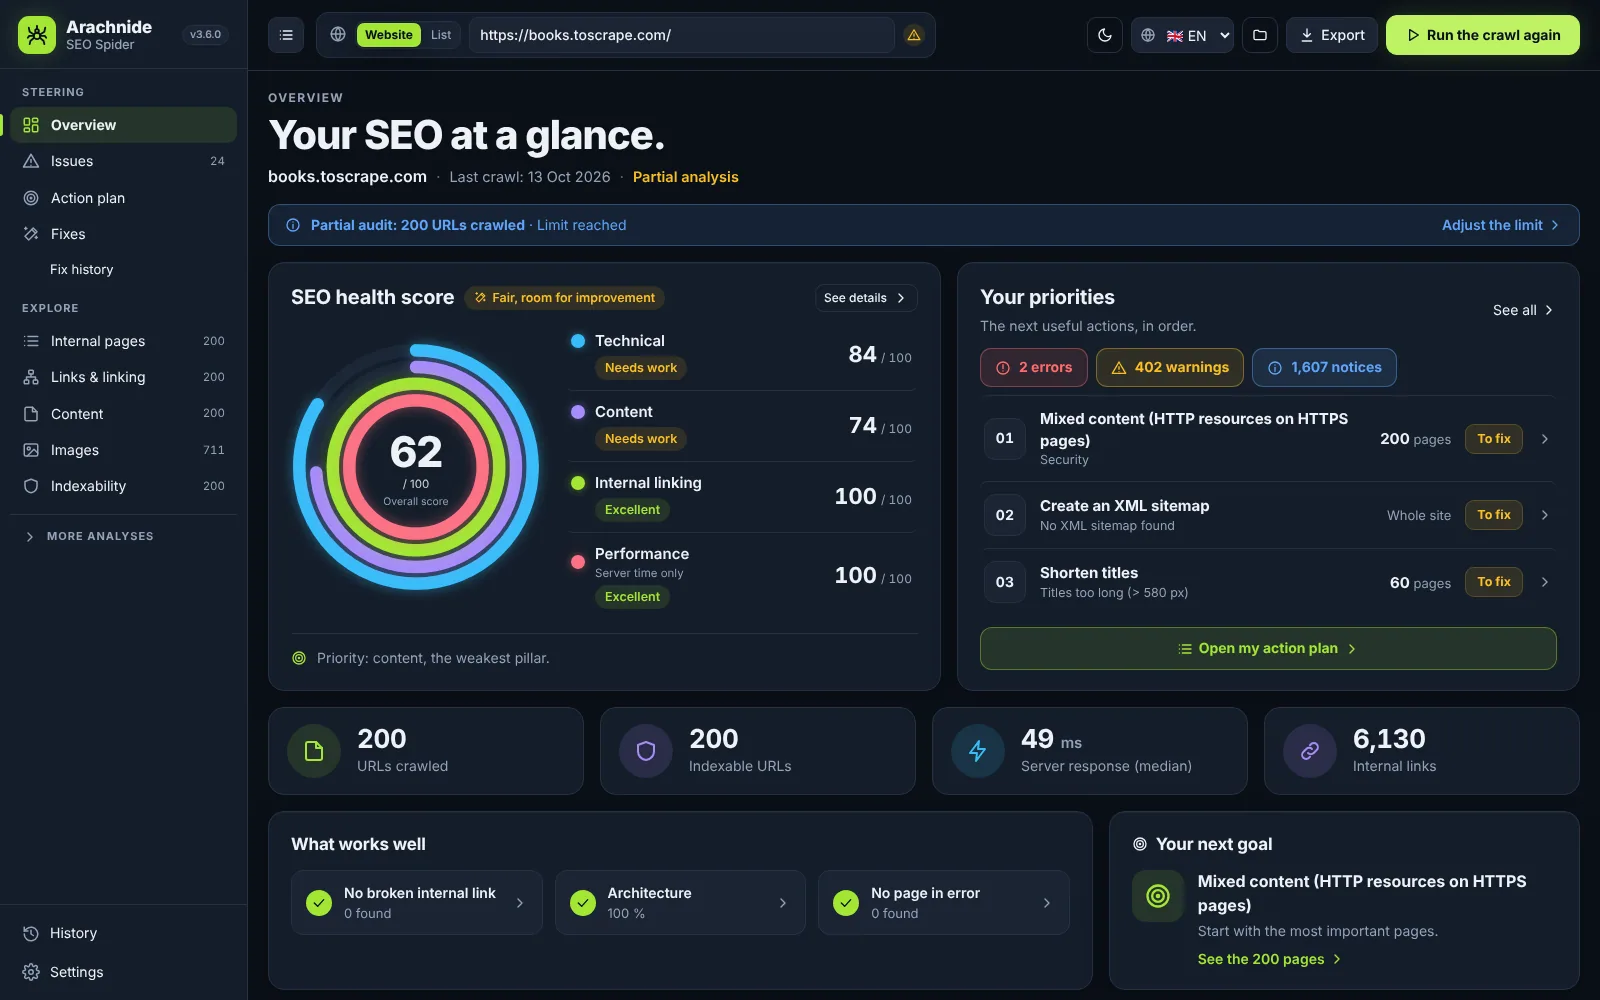
Un crawl ti dà un punteggio di salute su 100 con un voto A–F, quattro punteggi per pilastro (tecnica, contenuto, linking interno, prestazioni), le tue priorità contate in pagine uniche, indicatori chiave, cosa funziona bene e il tuo prossimo obiettivo. Un pilastro senza dati è mostrato come «non misurato», mai come un buon punteggio.
- Circa 95 controlli in 14 famiglie: codici di risposta, reindirizzamenti, title e meta, titoli Hn, contenuto, immagini, indicizzazione, architettura, sitemap, internazionale, dati strutturati, JavaScript, prestazioni e sicurezza, URL, IA e GEO.
- Link Score (PageRank interno), profondità di clic, pagine orfane, quasi duplicati (simhash), cannibalizzazione delle parole chiave, larghezza di title e description in pixel con anteprima SERP di Google.
- Rendering JavaScript con il Chrome o Edge già installato: HTML grezzo contro pagina renderizzata, errori JS, LCP e CLS.
Problemi SEO e piano d’azione
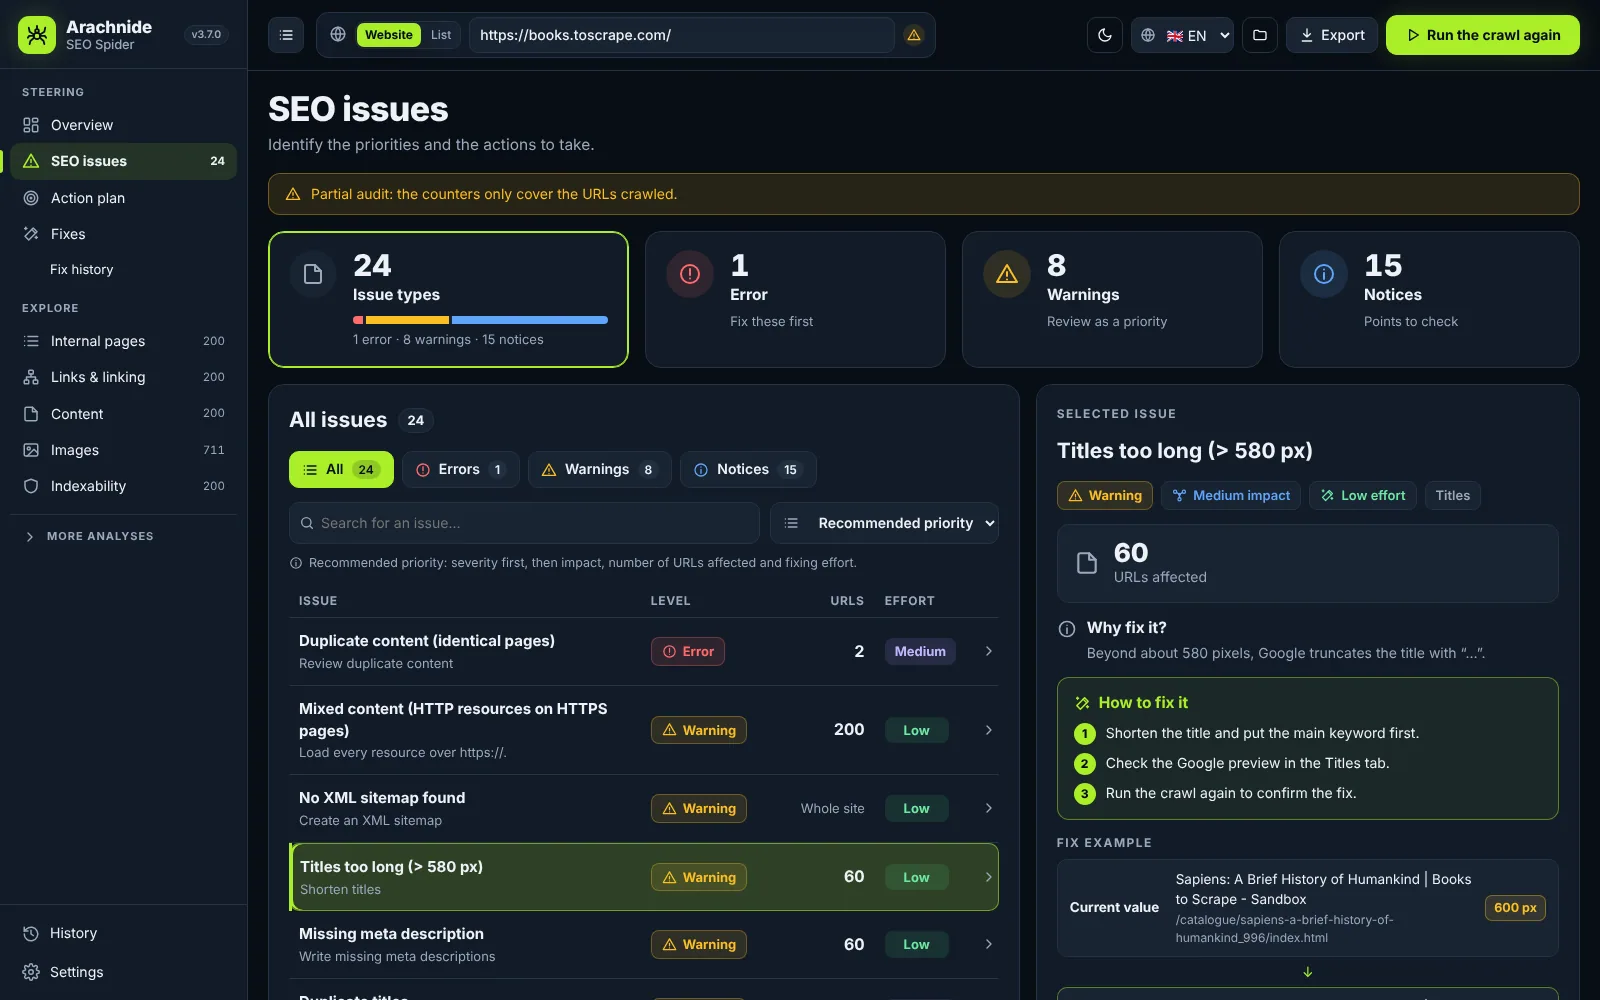
La pagina Problemi mostra cosa è stato trovato, quanto è grave, quanti URL unici riguarda e quanto sforzo richiede, con un pannello di correzione: perché è importante, passaggi numerati, un esempio prima / dopo preso da una pagina reale e l’elenco degli URL da esportare.
- Priorità consigliata: prima gli errori, poi gli avvisi, poi le segnalazioni, ordinati per gravità × impatto × URL ÷ sforzo.
- Il piano d’azione trasforma ogni problema in un’azione con un verbo, un rango, un criterio «fatto quando», uno stato (da fare, in corso, da convalidare) e note salvate nel tuo browser per ogni sito.
- Solo un nuovo crawl che non rileva più il problema lo segna come risolto.
Correggi in 1 clic e connettori
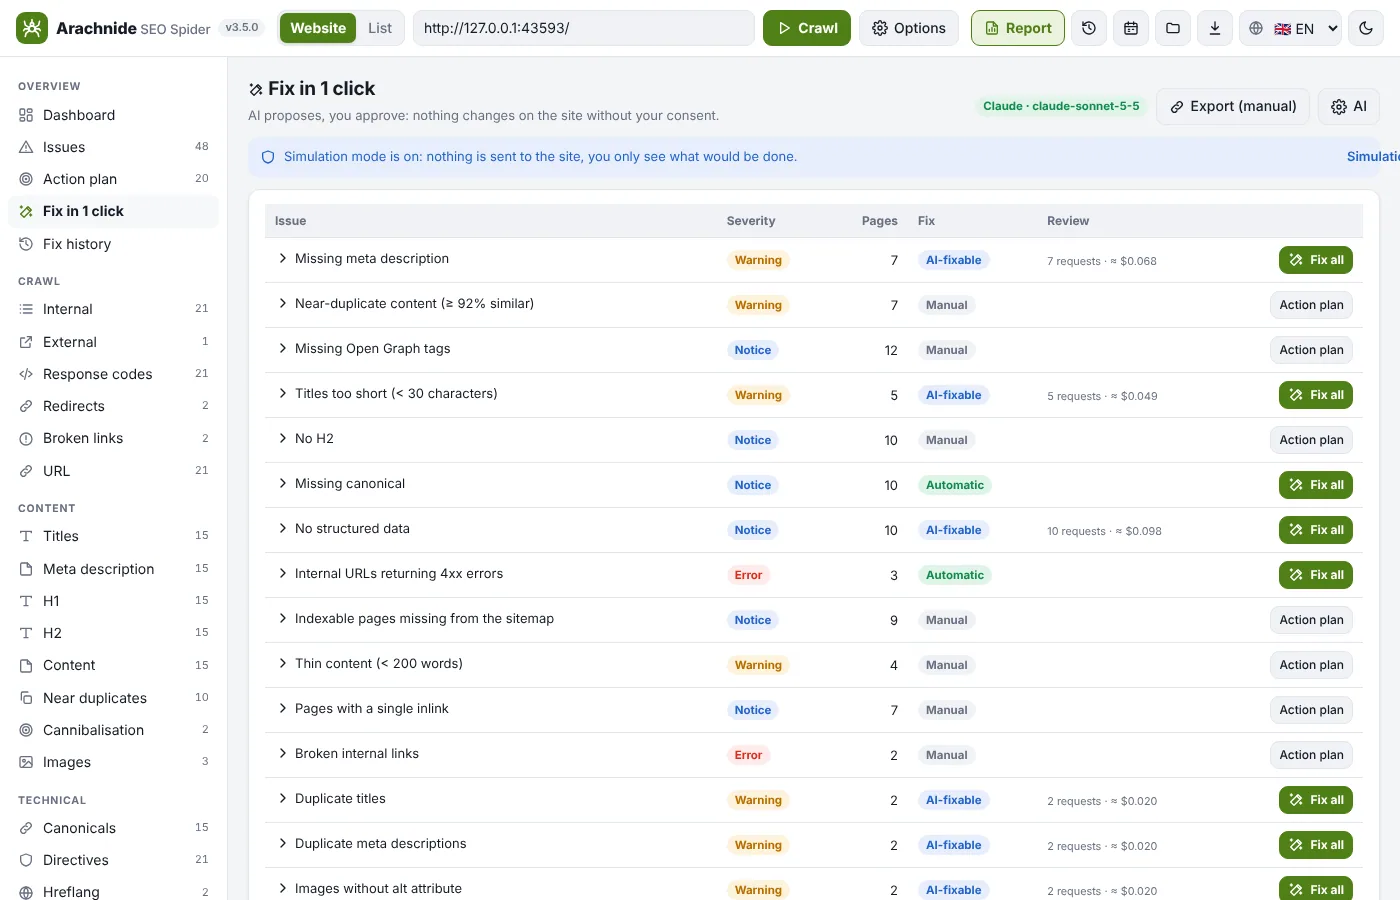
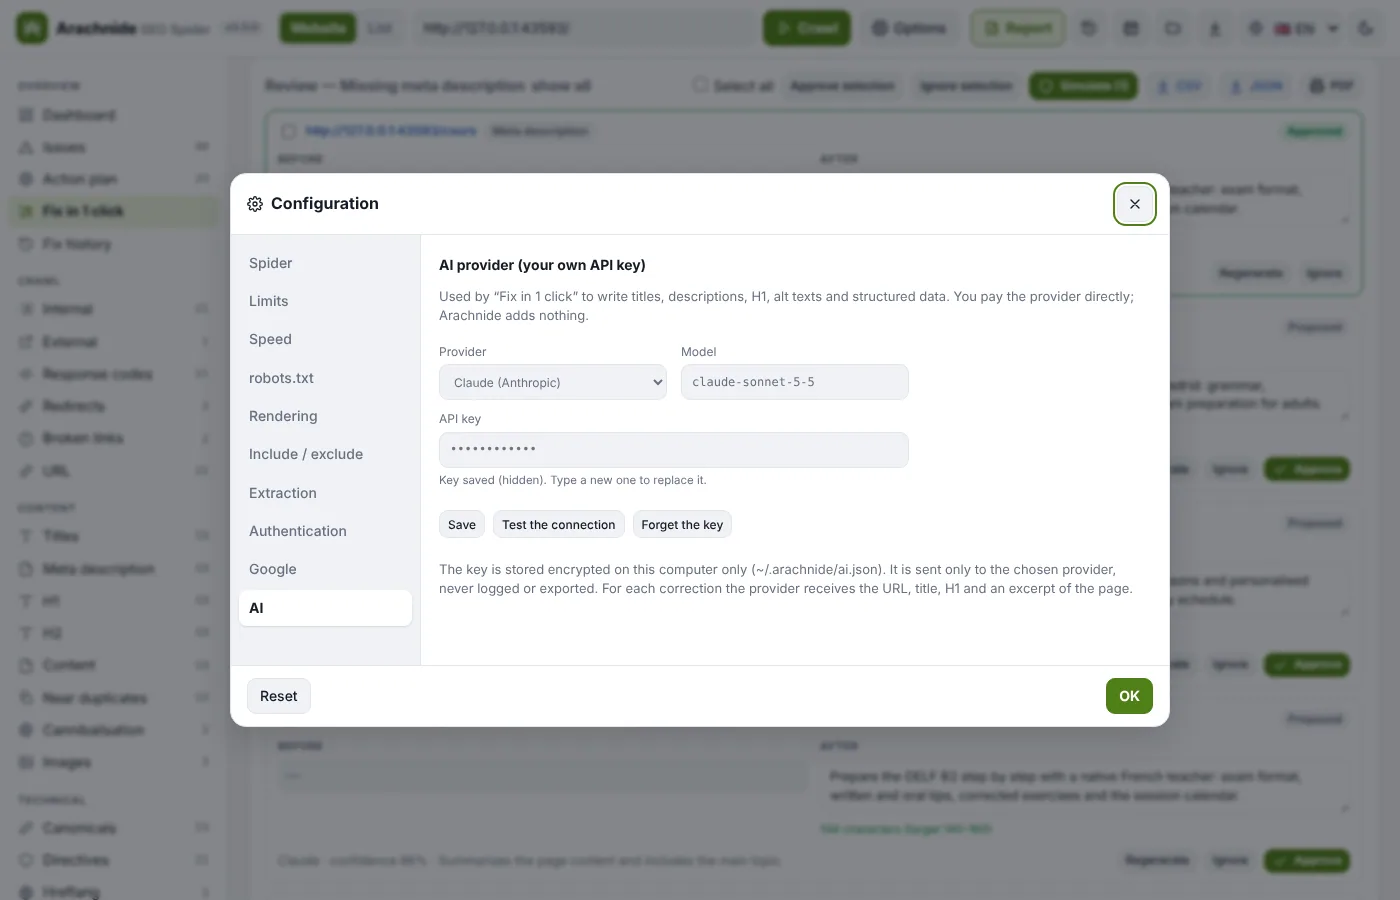
Dalla 3.5, Claude (Anthropic) o ChatGPT (OpenAI) scrivono title, meta description, H1, testi alternativi delle immagini e JSON-LD a partire dal contenuto reale di ogni pagina, con la tua chiave API. Reindirizzamenti 301, canonical, noindex accidentali e link verso reindirizzamenti sono calcolati senza IA. Tu rivedi, approvi, e un connettore applica la modifica.
- Connettori: WordPress (plugin compagno), Drupal, Joomla, PrestaShop, Shopify, Webflow, Wix, file (HTML statico più _redirects, .htaccess, nginx o vercel.json), Cloudflare Worker, pull request GitHub e una modalità manuale con il percorso esatto dei clic.
- Rilevamento automatico del CMS, modalità simulazione predefinita, regole per sito (campi consentiti, dimensione dei lotti, sola lettura), cronologia e annullamento di una correzione o di un intero lotto, PDF «correzioni applicate».
- Chiavi e credenziali sono salvate cifrate sul tuo computer e inviate solo al fornitore o al CMS interessato.
Mappa del sito in 2D e 3D
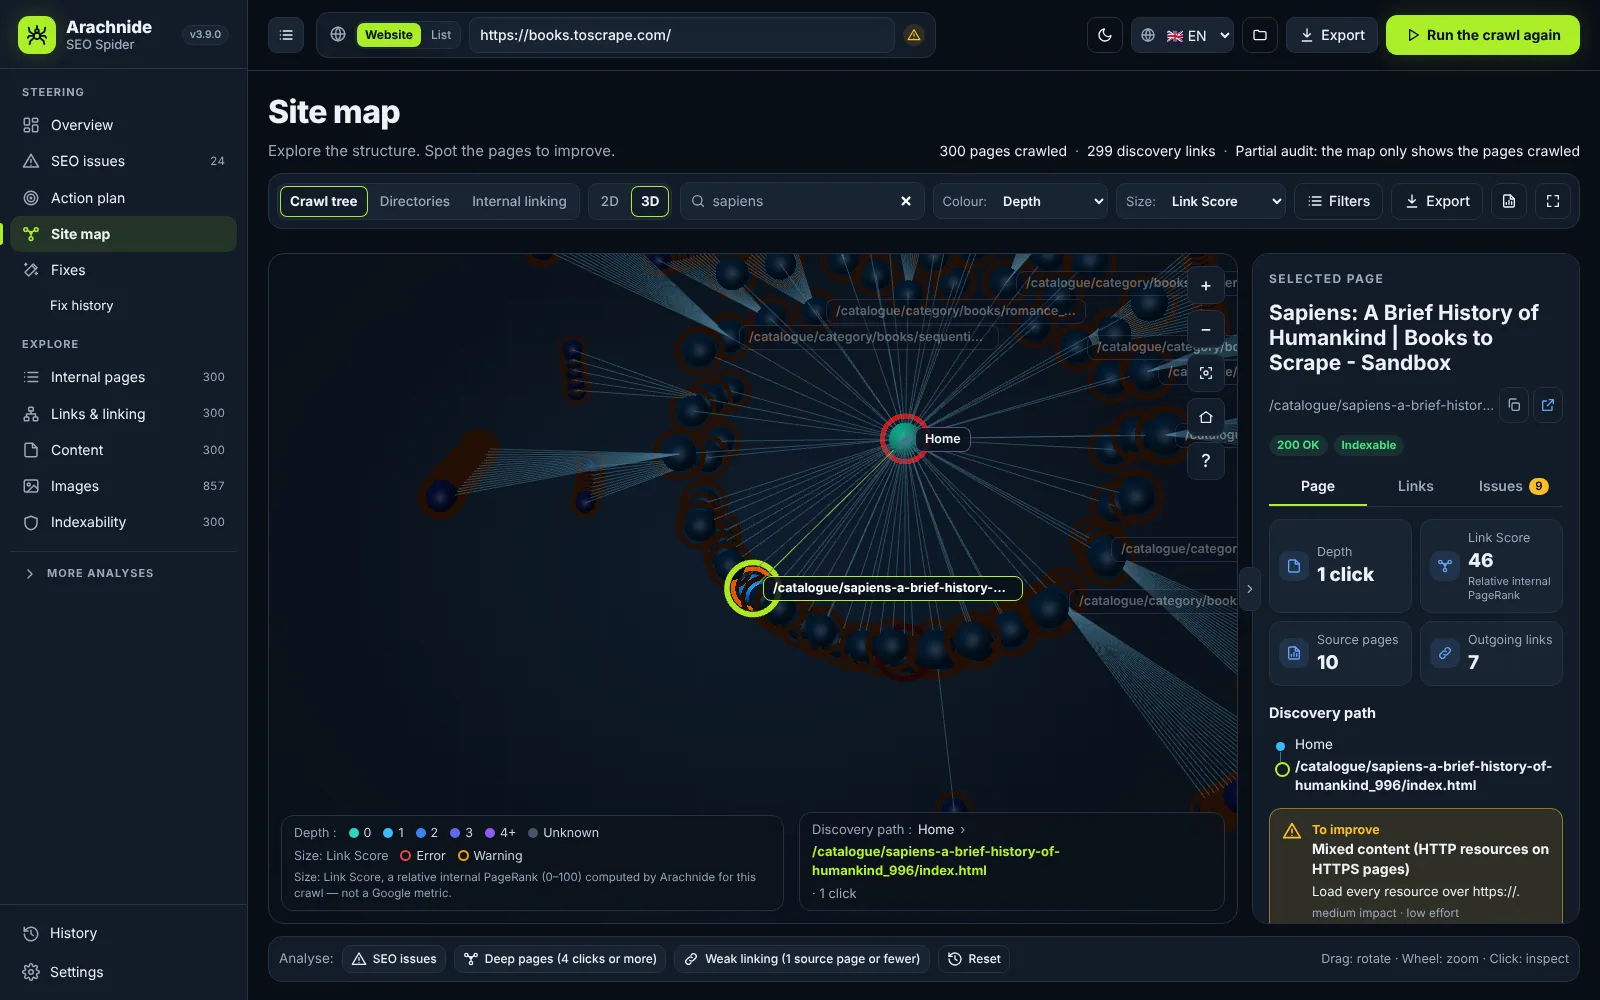
Due viste complementari condividono gli stessi dati, filtri, ricerca e ispettore di pagina. La mappa del sito è il classico albero orizzontale in stile Screaming Frog su sfondo bianco, pensato per screenshot e report per i clienti. La visualizzazione 2D / 3D è la vista di esplorazione: stile scuro, disposizione radiale, colorata per problemi SEO di default.
- Tre rappresentazioni: albero di scansione (percorso di clic più breve dalla home page), directory (struttura degli URL) e linking interno (i veri link orientati).
- Filtri per cartella, pattern di URL (testo, carattere jolly o regex), problemi, profondità, stato, indicizzabilità, linking in entrata debole, intervallo di Link Score; evidenzia o isola.
- Ispettore di pagina con stato, profondità, Link Score, pagine sorgente, percorso di scoperta e problemi; esportazioni PNG e PDF con intestazione, legenda e contesto.
Segmenti
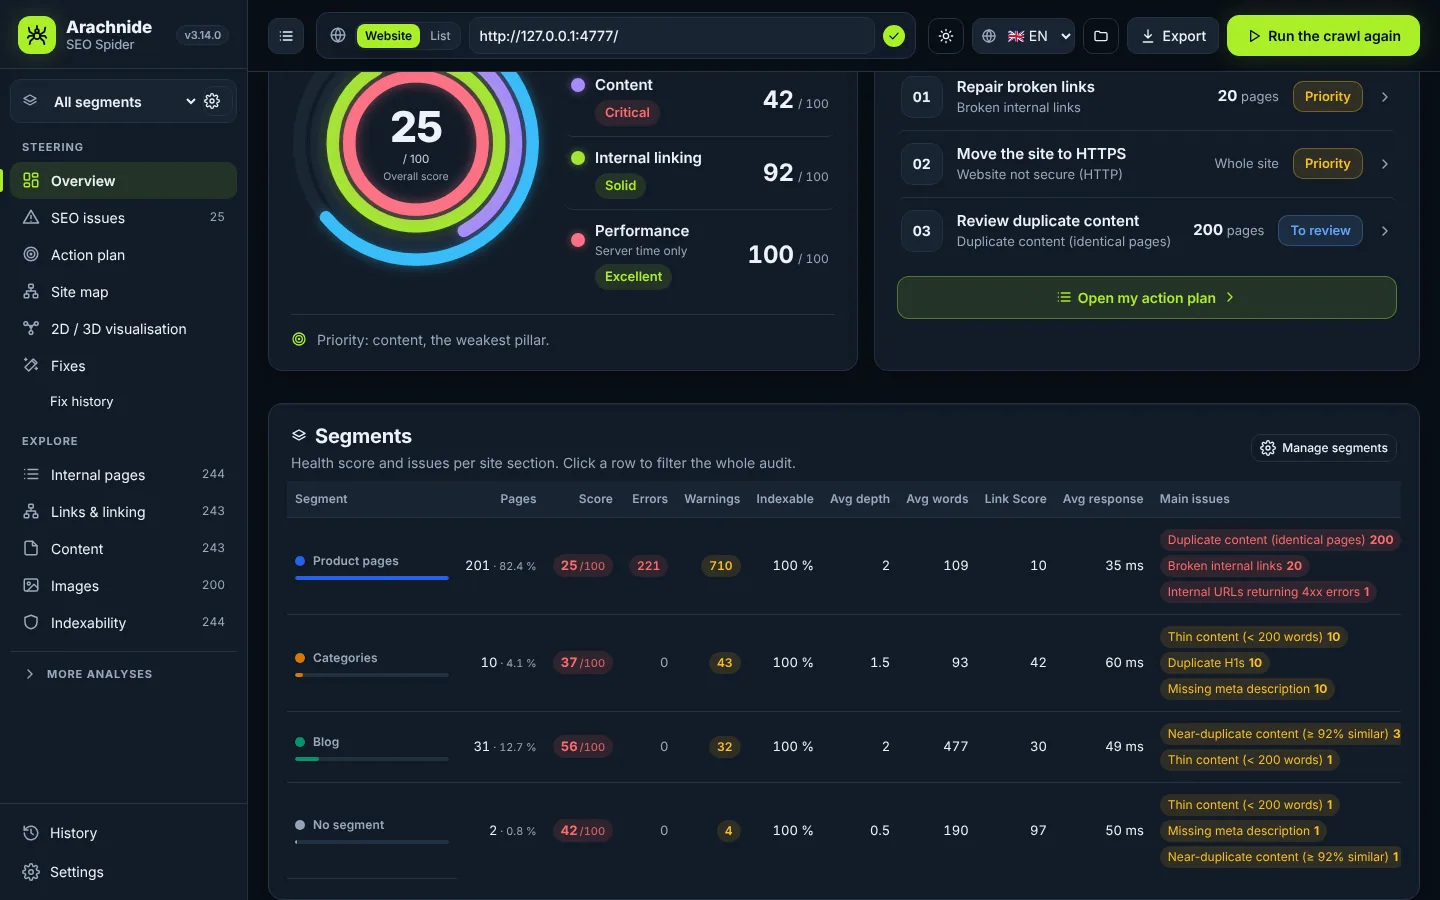
Su un sito grande, un punteggio globale nasconde dove sono davvero i problemi. I segmenti (3.14) suddividono l’audit in sezioni con un nome, esattamente come i segmenti di Screaming Frog: schede prodotto, categorie, blog, una lingua, pagine senza traffico.
- Regole su 20 campi (percorso, URL, title, H1, stato, indicizzabilità, profondità, parole, link in entrata, Link Score, tempo di risposta, tipo di dati strutturati, lingua, clic di Search Console, sessioni GA4, estrazioni personalizzate) con operatori di testo, numerici e booleani, combinati in E / O.
- Vince il primo segmento che corrisponde; «Crea dalle directory» costruisce un segmento per ogni cartella di primo livello in un clic.
- Applicati dopo il crawl senza ripeterlo; un filtro globale ricalcola dashboard, punteggio, problemi, piano d’azione, tabelle, esportazioni CSV e report PDF per quella sezione.
Dati Google
Collega i dati Google che un crawler non può vedere: PageSpeed Insights e Core Web Vitals degli utenti Chrome reali (CrUX), clic, impressioni, CTR e posizione di Search Console per URL, e sessioni di Google Analytics 4.
- Search Console tramite account di servizio in sola lettura o importazione CSV; Google Analytics 4 tramite API o CSV (3.15).
- Trova le pagine che Google vede ma che i tuoi link non raggiungono, le pagine orfane che ricevono ancora traffico, le pagine con CTR basso e le pagine non indicizzabili con traffico.
- Crawl pianificati (giornalieri, settimanali, mensili) con avvisi via email quando il punteggio scende o compaiono errori, confrontati con il crawl precedente, report completo allegato.
Report per i clienti
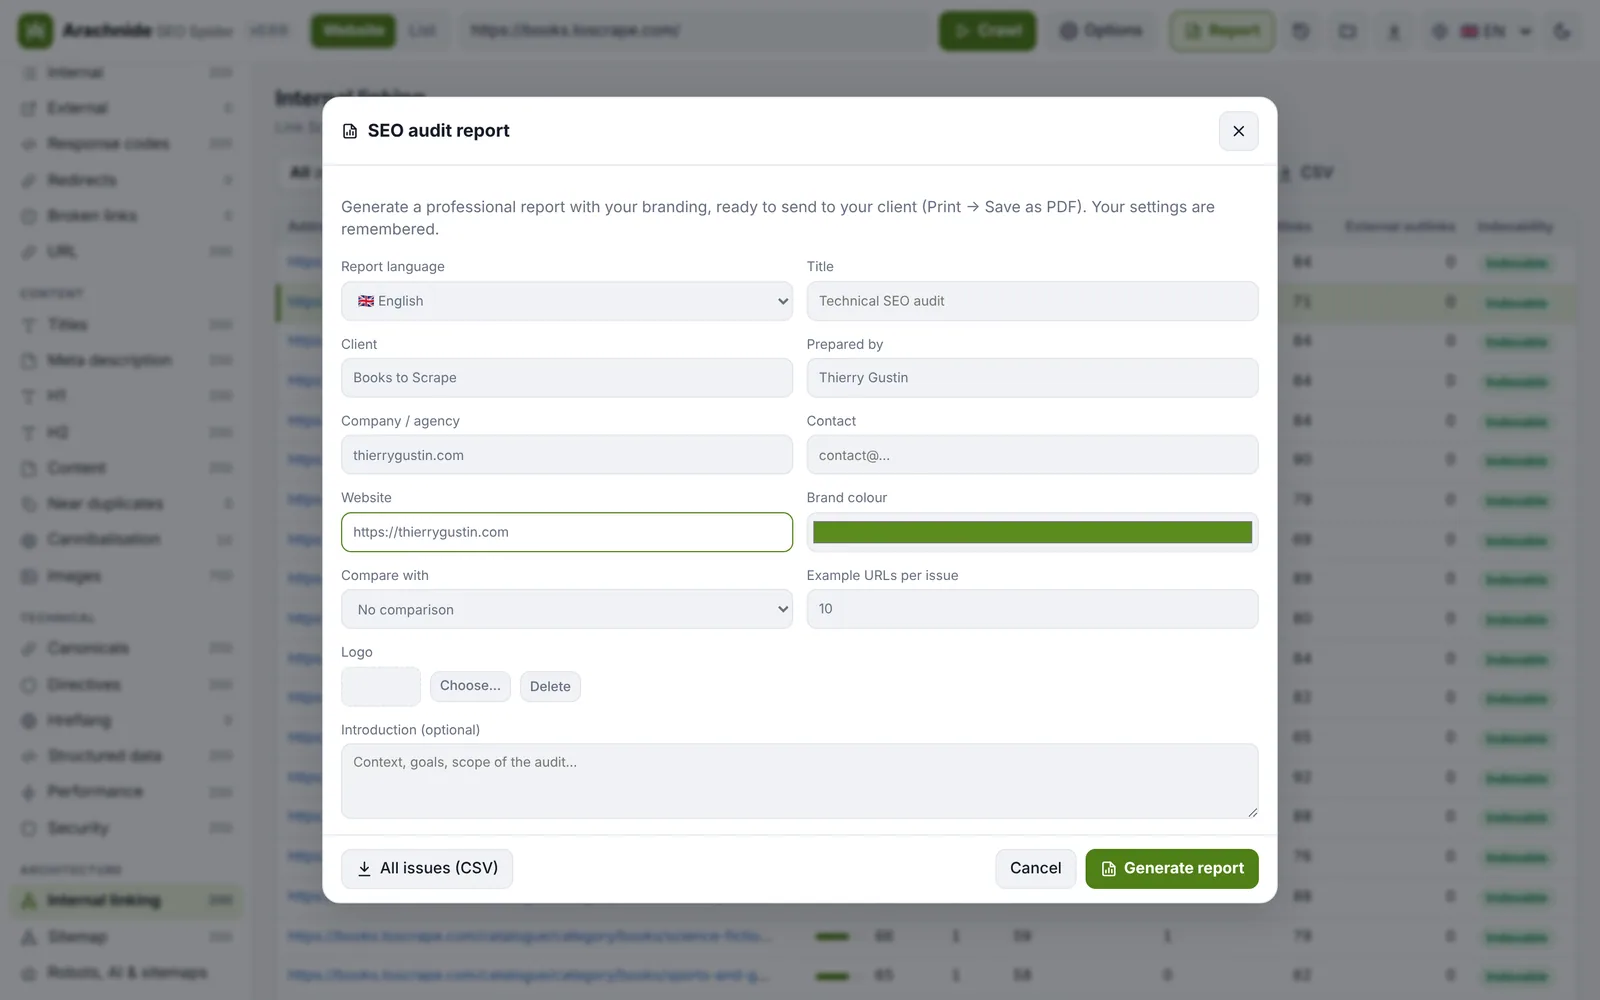
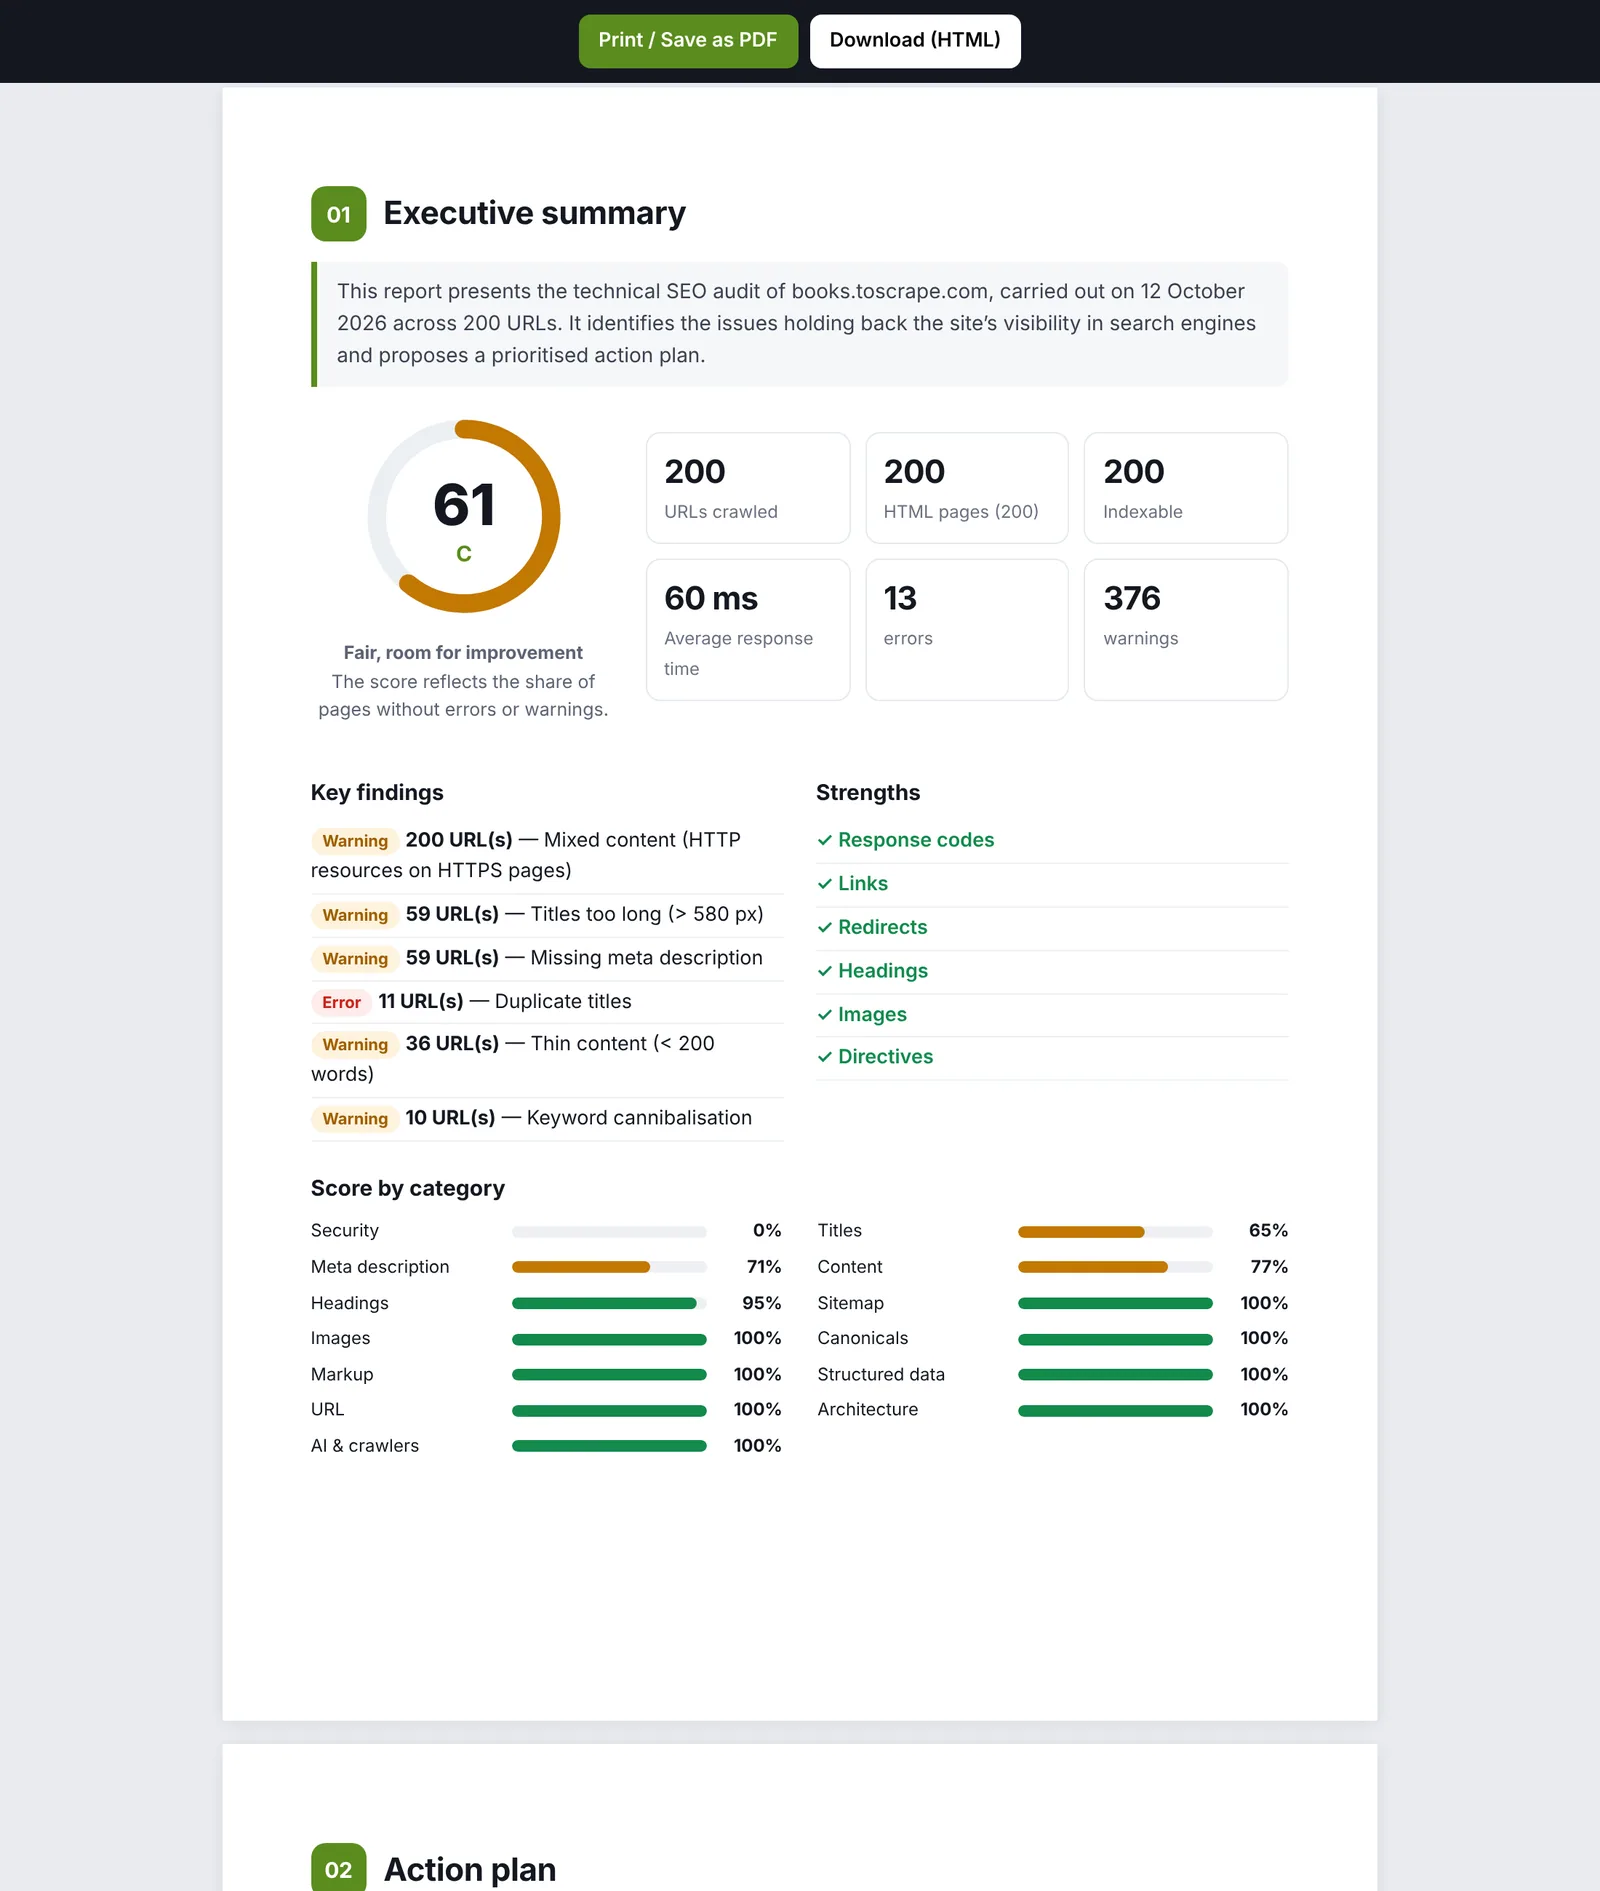
Un report HTML white label che si stampa in PDF, in sei lingue: il tuo logo, il tuo colore, il nome del cliente e i tuoi contatti, una sintesi per la direzione, i risultati chiave, i punteggi per categoria, un piano d’azione in tre livelli di priorità, un’analisi dettagliata con URL di esempio e la metodologia.
- Confronto con un crawl precedente dello stesso sito: variazione del punteggio, problemi risolti, nuovi o peggiorati, URL per URL.
- Risultati per segmento quando sono definiti dei segmenti; un report per un solo segmento lo nomina in copertina.
- CSV di tutti i problemi e di tutte le pagine per il tuo cliente o il tuo sviluppatore.
Agenti IA e GEO
Dalla 3.13 Arachnide è progettato per essere guidato da un agente IA: il tuo, o qualsiasi assistente che parli MCP (Claude) o OpenAPI (Actions di ChatGPT, LangChain, n8n, Make). Tre accessi, un solo set di 25 strumenti definiti una volta sola.
- MCP via stdio (Claude Desktop, Claude Code), MCP via HTTP (connettori personalizzati di claude.ai, agenti ospitati, Claude Agent SDK) e REST + OpenAPI 3.1 importabile come Action di ChatGPT in un clic.
- Punteggio di prontezza GEO su 100: accesso dei crawler IA (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended…), llms.txt, copertura dei dati strutturati, profondità dei contenuti, igiene.
- Token di accesso creato al primo avvio, 240 richieste al minuto per IP, registro delle ultime chiamate nell’app, strumenti di scrittura contrassegnati come consequenziali.
Estrazione personalizzata e ricerca
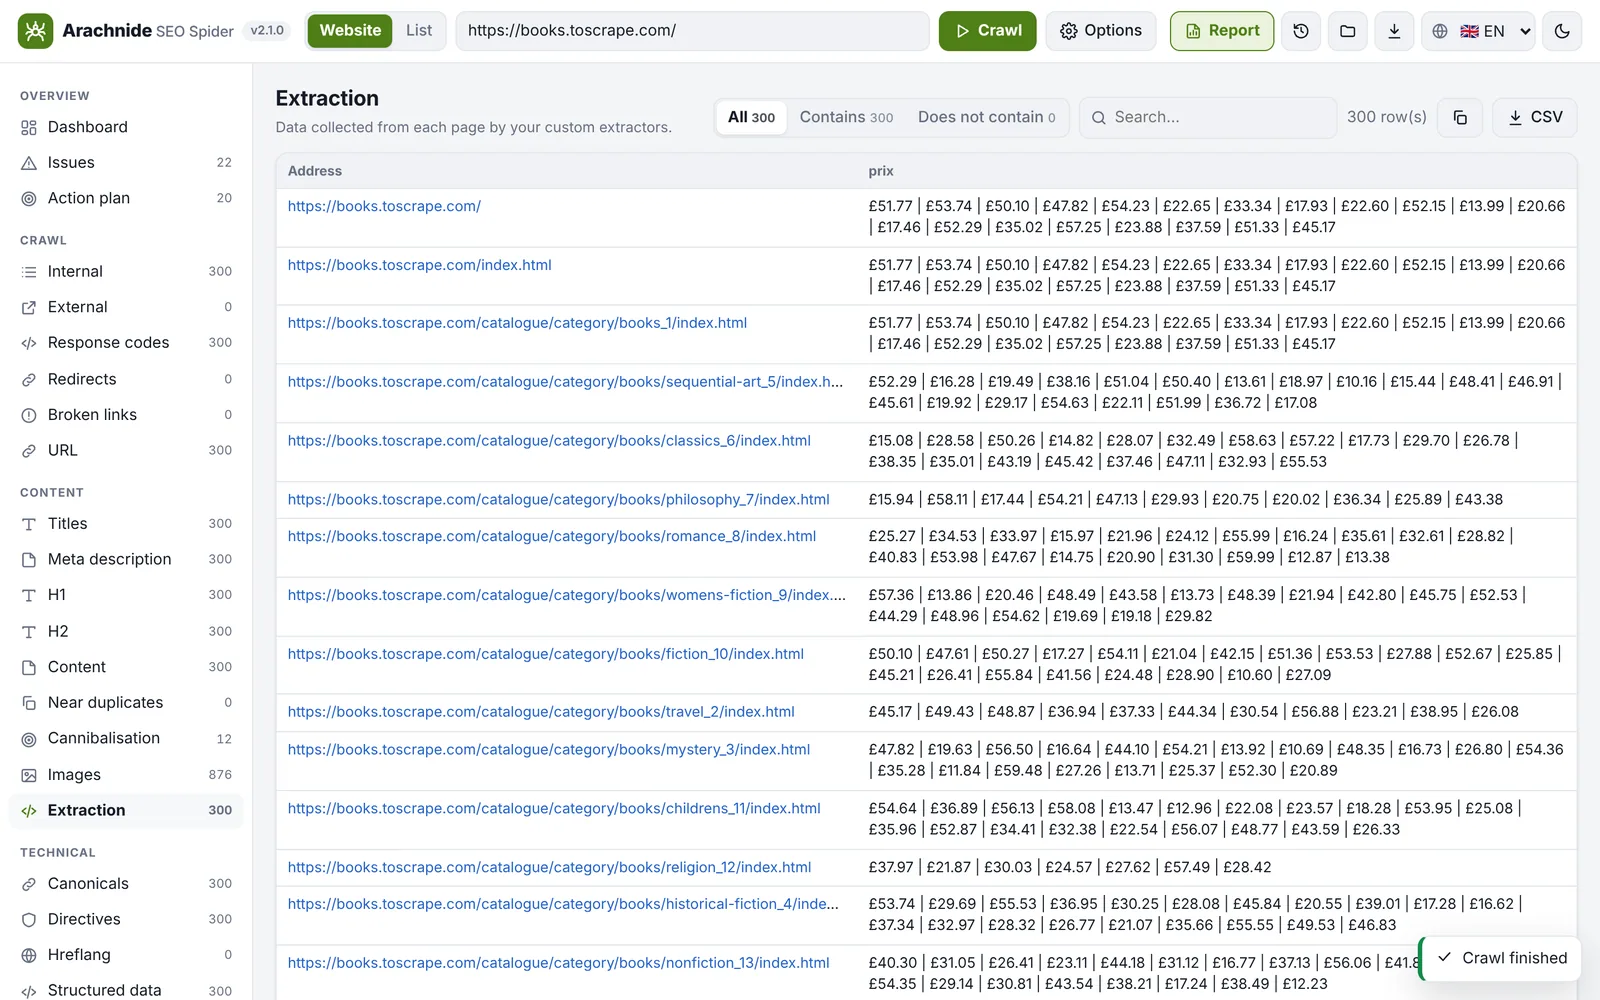
Raccogli qualsiasi dato da ogni pagina: prezzo, autore, data, SKU, codice di tracciamento. Fino a 20 estrattori per selettore CSS (testo, attributo, HTML o conteggio), XPath (3.21) o regex, con una scheda Estrazione e una colonna per regola nell’esportazione CSV.
- Ricerca personalizzata: tutte le pagine che contengono un testo o una regex, come un vecchio numero di telefono o un codice di tracciamento.
- Le estrazioni possono guidare i segmenti (extract:Price) e la CLI accetta le stesse regole con --extract.
- Una regex impazzita viene interrotta in un worker dopo 2 s invece di bloccare il crawl.
Riga di comando
Tutto ciò che fa l’interfaccia, da un terminale o da un job cron: node src/cli.mjs <url> [options]. La CLI mostra il punteggio e i problemi nella tua lingua, salva il crawl in NDJSON gzip che l’interfaccia può aprire ed esporta il CSV e il report HTML.
- JSON (NDJSON gzip), pages.csv e issues.csv, report HTML con il tuo brand, confronto con un crawl precedente, segmenti, avvisi via email per cron.
- --resume riprende un crawl interrotto dal suo diario; --sitemap scansiona esattamente gli URL di una sitemap; --extract aggiunge una colonna CSV per regola.
- Stesse opzioni dell’interfaccia: limiti, velocità, modalità robots.txt, user agent, autenticazione, includi / escludi, dati Google.
Scalabilità e prestazioni
Le versioni dalla 3.16 alla 3.21 hanno formato un programma di scalabilità in sei passi: grafo dei link compatto in colonne di array tipizzati (14 byte per link), NDJSON gzip scritto in streaming, un diario di ripresa, un’analisi che confronta tutte le pagine per i quasi duplicati e un browser che non riceve mai l’intero crawl.
- Testato su un sito sintetico locale di 200.000 pagine e 19,9 milioni di link con npm run bench -- --pages 200000: crawl e analisi in 2086 s (circa 96 pagine al secondo), salvataggio in 38 s in un file di 62,5 MB, memoria massima 2,7 GB.
- Protezioni del crawl: il budget di pagine conta le pagine scaricate, i parametri di tracciamento vengono rimossi, le trappole a faccette vengono segnalate, un robots.txt irraggiungibile vieta tutto come richiede la RFC 9309.
- Il budget predefinito è di 500 pagine: alzalo in Opzioni → Limiti per un sito grande.