Configurazione del crawl
Ogni opzione del crawl con il suo valore predefinito - limiti, velocità, robots.txt, rendering, ambito, estrazione, autenticazione, modalità elenco e sitemap.
Clicca su Opzioni (l’ingranaggio) per aprire la finestra Configurazione, modellata sulla configurazione dello spider di un crawler desktop. Le tue impostazioni vengono memorizzate, tranne la password HTTP e gli header personalizzati, che spesso contengono un cookie di sessione o un token.
| Scheda | Impostazioni |
|---|---|
| Spider | Leggere le sitemap XML, seguire i canonical, includere i sottodomini, controllare i link esterni e le immagini |
| Limiti | Totale del crawl, profondità di crawl, URL per livello di profondità, profondità delle cartelle, query string, redirect da seguire, lunghezza degli URL, link per pagina, dimensione della pagina, limiti per percorso URL (/blog/ = 200, uno per riga) |
| Velocità | Numero massimo di thread, numero massimo di URL al secondo, timeout |
| robots.txt | Rispetta / ignora ma segnala lo stato / ignora, robots.txt personalizzato, tester di URL |
| Rendering | Rendering JavaScript, user-agent (Arachnide, Googlebot desktop/smartphone, Chrome), Accept-Language |
| Includi / escludi | Regex di inclusione / esclusione, rimozione dei parametri degli URL (utm_*, gclid), ignorare tutti i parametri, ricerca personalizzata |
| Estrazione | Fino a 20 estrattori: selettore CSS (testo, attributo, HTML o conteggio) o regex |
| Autenticazione | Utente e password HTTP, header personalizzati (cookie, token) |
Spider
- Leggi le sitemap XML (attivo): le sitemap dichiarate nel
robots.txto in/sitemap.xmlvengono lette, compresi gli indici di sitemap e i file.gz, e i loro URL messi in coda. Le sitemap di immagini e video vengono saltate; vengono letti al massimo 500 file di sitemap. - Segui i canonical (attivo): un canonical che punta a un URL non scansionato lo mette in coda.
- Includi i sottodomini (disattivo):
blog.example.comfa parte diexample.comsolo quando questa opzione è attiva. Un’altra porta non è mai il sito analizzato. - Verifica i link esterni e verifica le immagini (peso, stato, formato) sono disattivi per impostazione predefinita per mantenere leggeri i crawl dei clienti.
Limiti
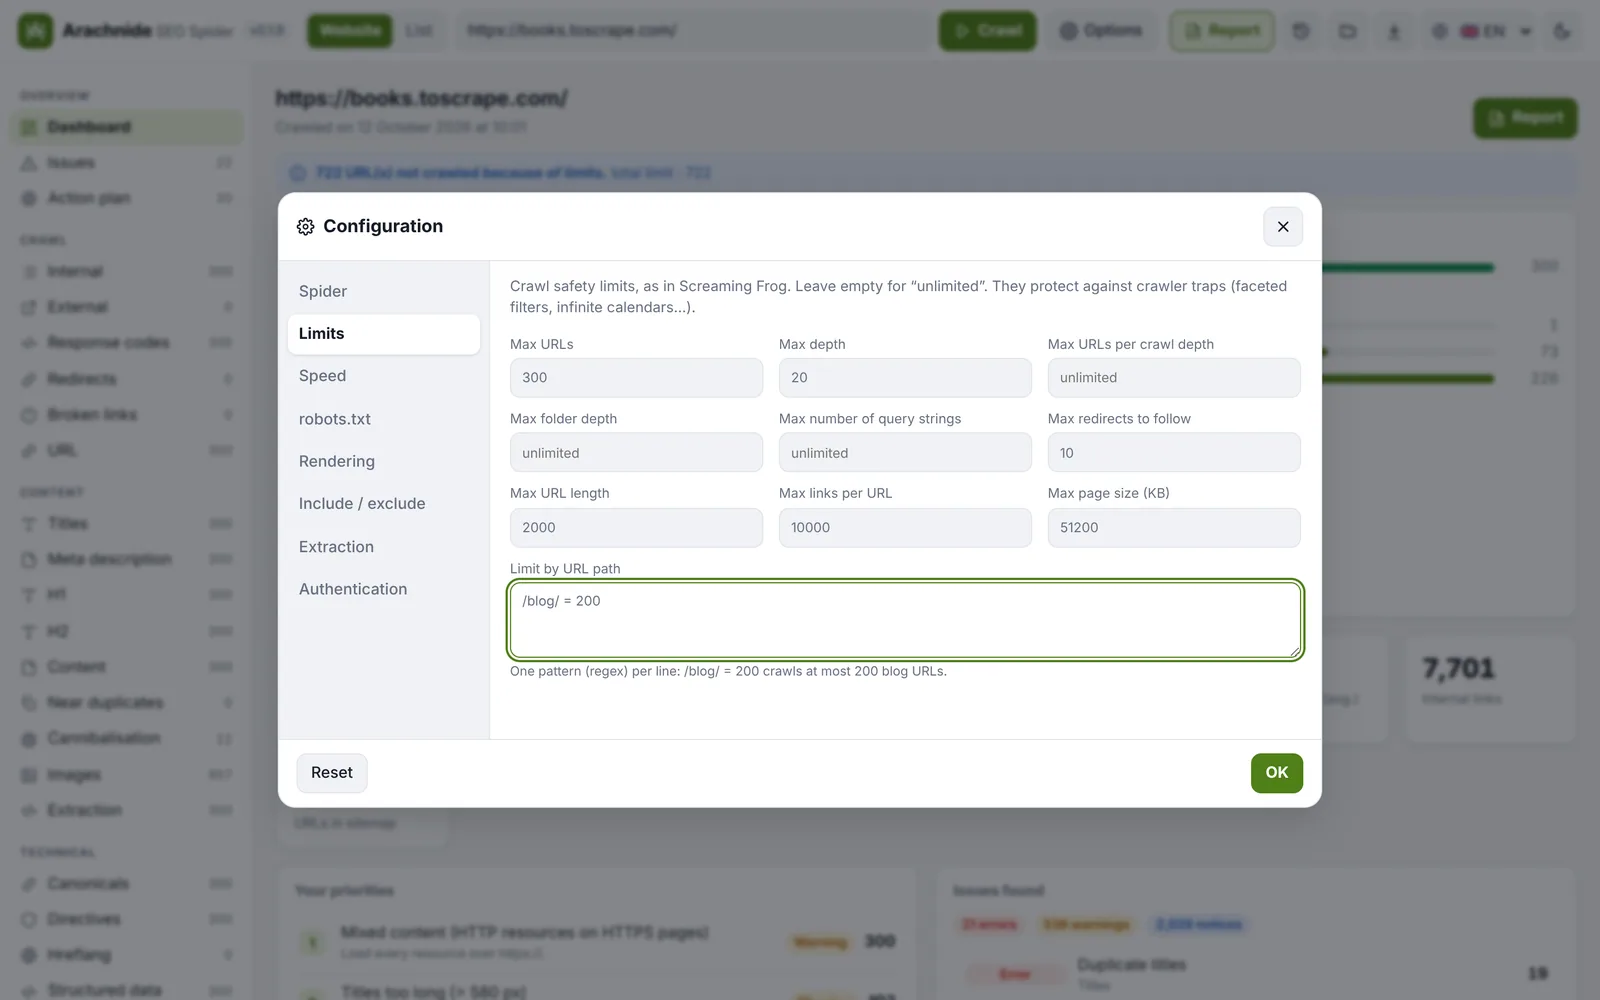
| Impostazione | Predefinito | Note |
|---|---|---|
Totale del crawl (maxPages) | 500 | Conta le pagine effettivamente scaricate; gli URL bloccati da robots.txt non lo consumano. Fino a 10 000 000. |
Profondità di crawl (maxDepth) | 20 | I reindirizzamenti non aggiungono profondità. |
URL per livello di profondità, profondità delle cartelle, query string, reindirizzamenti da seguire (10), lunghezza degli URL, link per pagina, peso della pagina (maxPageSizeKb) | — | Gli URL saltati sono contati per motivo nella dashboard. I corpi delle risposte sono letti in streaming e abbandonati oltre il limite di dimensione. |
| Limiti per percorso URL | — | Uno per riga, es. /blog/ = 200. |
Velocità
- Thread massimi (
concurrency): 5 per impostazione predefinita, da 1 a 30. Su un sito di un cliente, resta tra 2 e 5. - URL massimi al secondo (
maxUrlPerSec): un limite globale, utile sugli hosting condivisi. - Pausa tra le richieste per worker, e timeout.
Le risposte di limitazione della frequenza (429 e 503 con Retry-After) vengono rispettate e ritentate; 500, 502, 504 ed errori di connessione ricevono un nuovo tentativo differito alla fine della coda.
robots.txt
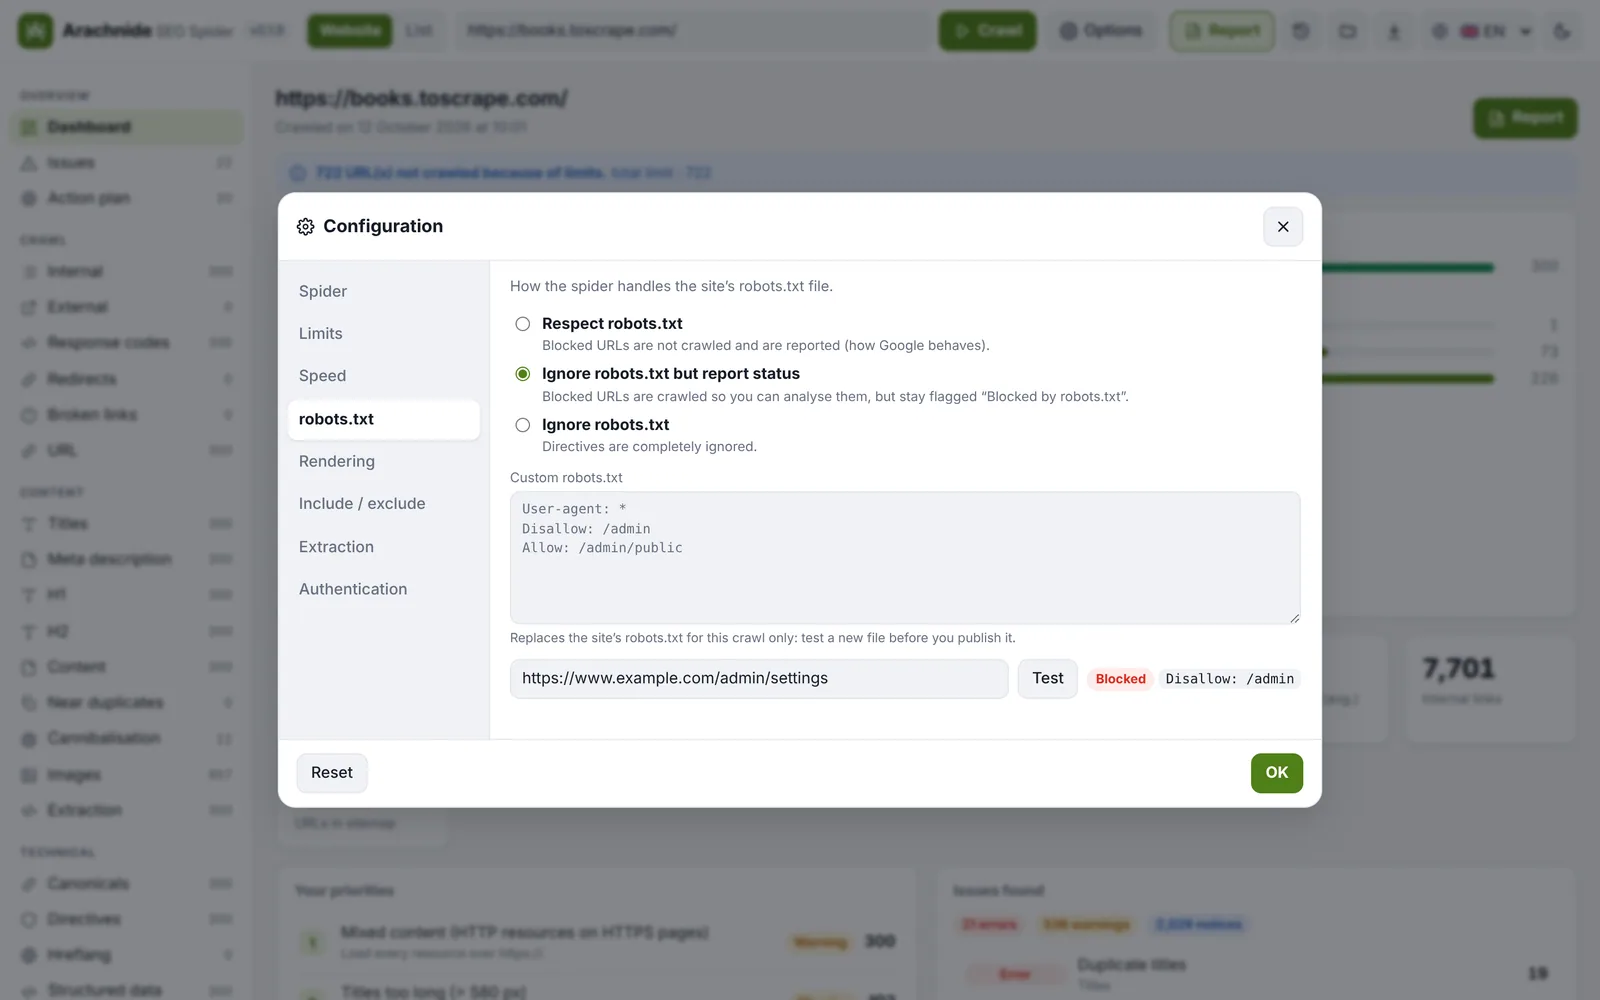
Tre modalità: rispetta (predefinita), ignora ma segnala (gli URL bloccati vengono scansionati e restano contrassegnati) e ignora. Puoi incollare un robots.txt personalizzato per testare un file prima di pubblicarlo, e il tester integrato dice se un URL è consentito e quale regola si applica. Arachnide segue le regole di Google per il robots.txt (RFC 9309):
- un robots.txt che risponde 4xx significa che tutto è consentito;
- un robots.txt che risponde 5xx o irraggiungibile significa che tutto è vietato, con un avviso esplicito. Due vie d’uscita: l’opzione robots.txt non disponibile → consenti (
--robots-unavailable allow), oppure la modalità segnala / ignora; - in modalità elenco e con i sottodomini, il robots.txt viene letto una volta per host.
Rendering
Il rendering JavaScript usa il Chrome, Edge, Chromium o Brave già installato (tramite puppeteer-core; non viene scaricato nulla). Arachnide confronta l’HTML grezzo con la pagina renderizzata (contenuto, link, title, H1, canonical, noindex), segnala gli errori JS e i reindirizzamenti JavaScript, e misura LCP e CLS in laboratorio. Chrome viene riavviato ogni 500 pagine renderizzate per limitarne la memoria, e riavviato una volta se muore.
User agent: Arachnide (predefinito), Googlebot desktop, Googlebot smartphone, Chrome o una stringa personalizzata. Come Googlebot, per impostazione predefinita non viene inviato alcun header Accept-Language; puoi impostarne uno. Se un sito risponde 403 all’agente Arachnide, il crawl passa automaticamente a Chrome e te lo segnala.
Includi / escludi
- Includi ed escludi: un’espressione regolare per riga. Una riga non valida viene ignorata e segnalata. L’URL di partenza viene sempre scansionato.
- Resta nella cartella di partenza:
https://example.com/blog/scansiona solo/blog/…. - Rimuovi parametri URL come
utm_*ogclid(caratteri jolly accettati). Dalla 3.21, i parametri sono ordinati per chiave e i parametri di tracciamento noti (utm_*,gclid,fbclid,msclkid,mc_cid,srsltid,_ga…) vengono rimossi per impostazione predefinita, così?a=1&b=2e?b=2&a=1sono una sola pagina; mantieni i parametri così come sono ripristina il comportamento grezzo. - Ignora tutti i parametri, e ricerca personalizzata (un testo o una
/regex/da trovare nel codice sorgente). - Un percorso che produce 200 varianti di parametri viene segnalato una sola volta come trappola a faccette, la firma dei filtri combinabili che consumano il budget.
Estrazione
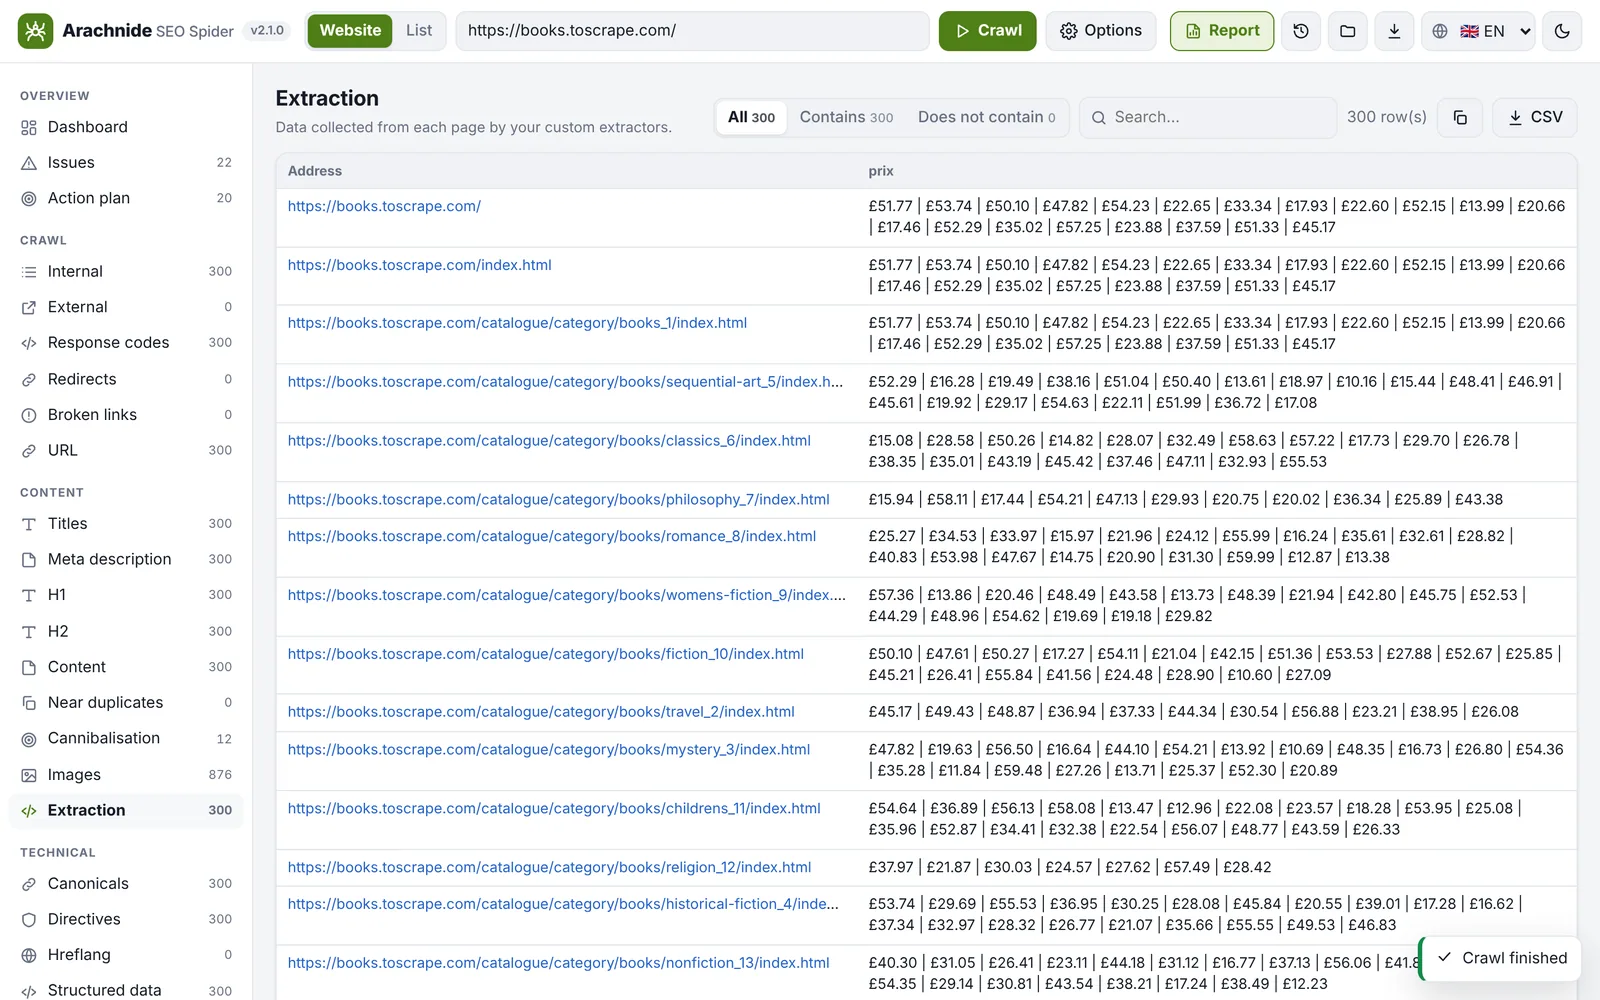
Fino a 20 estrattori, ognuno con un nome e una regola:
- Selettore CSS con un target: testo, attributo, HTML interno o conteggio;
- XPath (3.21): valutato in Chrome in modalità rendering, oppure sull’HTML grezzo tramite
jsdom, una dipendenza opzionale caricata solo quando esiste una regola XPath (npm install jsdomse vedi l’avviso); - Regex, eseguita in un worker con un timeout di 2 secondi: un pattern catastrofico viene interrotto per quella pagina e il crawl continua.
I valori compaiono nella scheda Estrazione, in una colonna per regola in pages.csv, e possono guidare i segmenti con il campo extract:<name>. La CLI accetta le stesse regole con --extract (vedi Riga di comando).
Autenticazione
Autenticazione HTTP (utente e password) e header personalizzati (cookie, token) per i siti di staging. Vengono inviati solo al sito analizzato, anche in modalità rendering, e non vengono mai salvati.
Modalità sito, elenco e sitemap
Il selettore accanto al campo dell’indirizzo sceglie tra scansionare un sito (seguendo i link) e un elenco di URL che incolli (fino a 500 000 URL dalla 3.21; i link non vengono seguiti, il linking interno è non misurato). La CLI aggiunge --list urls.txt e --sitemap URL, che scansiona esattamente gli URL di una sitemap o di un indice di sitemap, deduplicati e normalizzati. Gli agenti IA ottengono le stesse modalità tramite mode, urls e sitemap_url sugli strumenti di crawl.
Riprendere un crawl interrotto
Durante un crawl, Arachnide aggiunge righe a un diario di ripresa (crawls/.en-cours/<id>.ndjson): ogni URL messo in coda, ogni pagina elaborata. Dopo un crash o un’interruzione, il diario è elencato nella schermata iniziale e il crawl può essere ripreso da dove si era fermato, perdendo solo gli ultimi secondi. Il diario viene eliminato quando il crawl è completo. Nella CLI: --resume FILE, oppure --no-journal per non scrivere nulla.