Funcionalidades
Tudo está na versão 3.21.0, gratuita, sem nenhuma funcionalidade paga. Cada secção remete para a sua página de documentação.
Auditoria e pontuação de saúde
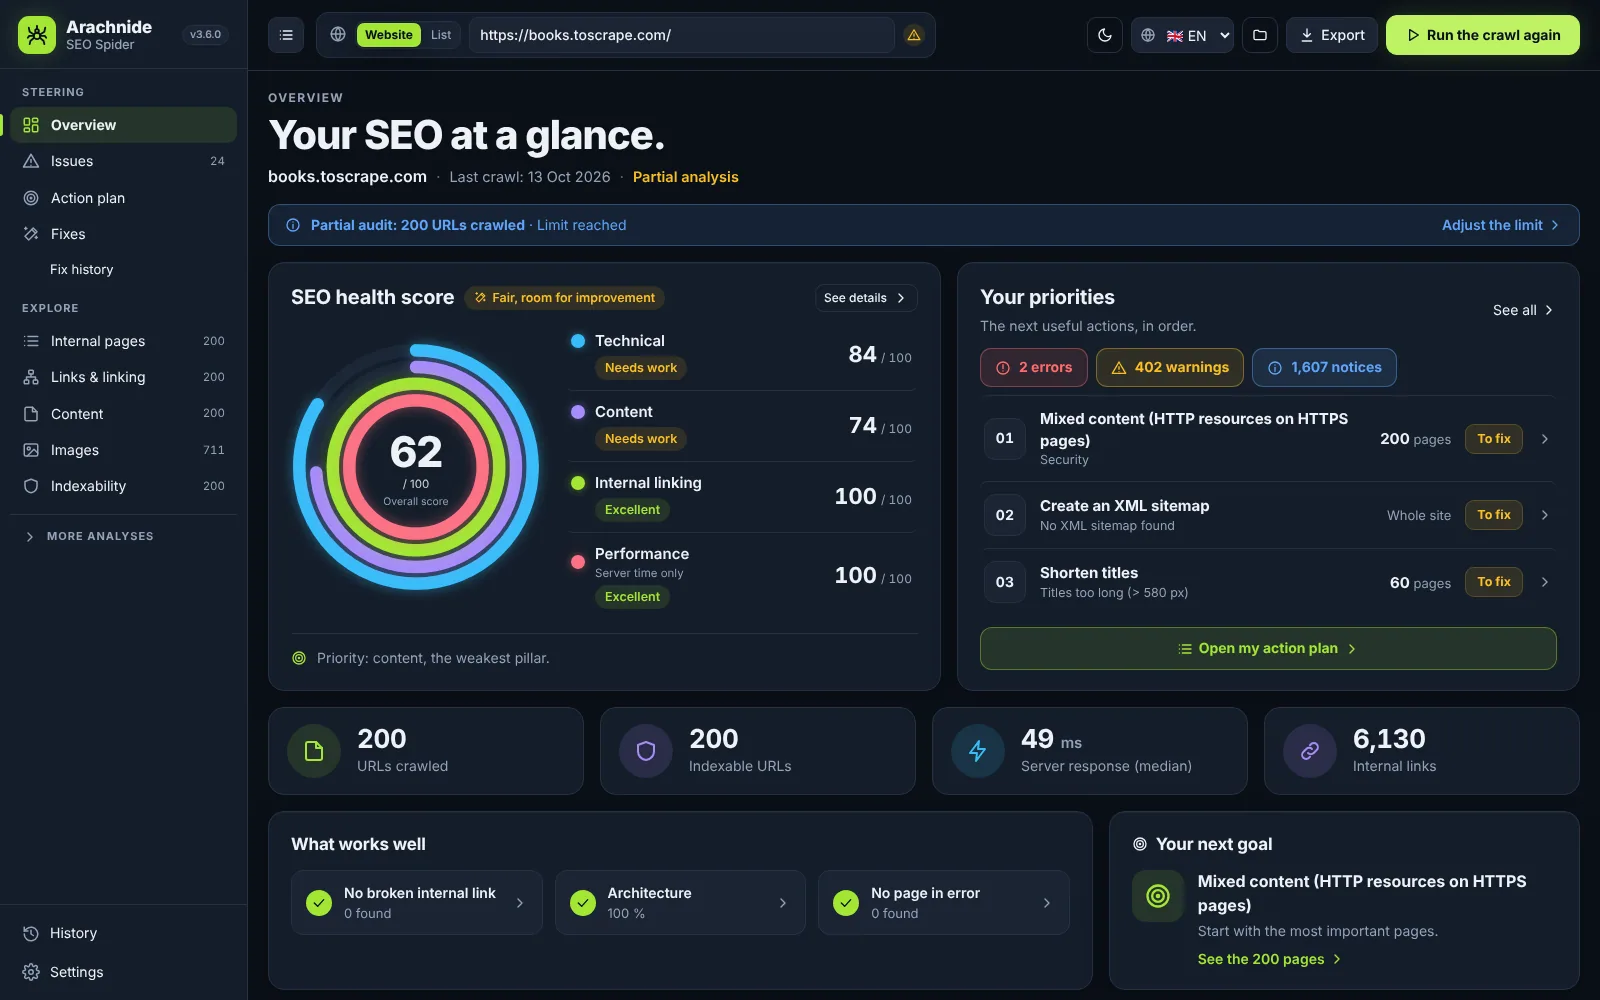
Um rastreio dá-lhe uma pontuação de saúde em 100 com nota A–F, quatro pontuações de pilar (técnico, conteúdo, ligação interna, desempenho), as suas prioridades contadas em páginas únicas, indicadores-chave, o que funciona bem e o seu próximo objetivo. Os pilares sem dados aparecem como «não medido», nunca como uma boa pontuação.
- Cerca de 95 verificações em 14 famílias: códigos de resposta, redirecionamentos, títulos e metas, cabeçalhos, conteúdo, imagens, indexação, arquitetura, sitemaps, internacional, dados estruturados, JavaScript, desempenho e segurança, URLs, IA e GEO.
- Link Score (PageRank interno), profundidade de clique, páginas órfãs, quase duplicados (simhash), canibalização de palavras-chave, largura dos títulos e descrições em píxeis com pré-visualização da SERP do Google.
- Renderização JavaScript com o Chrome ou o Edge já instalado: HTML bruto versus página renderizada, erros JS, LCP e CLS.
Problemas SEO e plano de ação
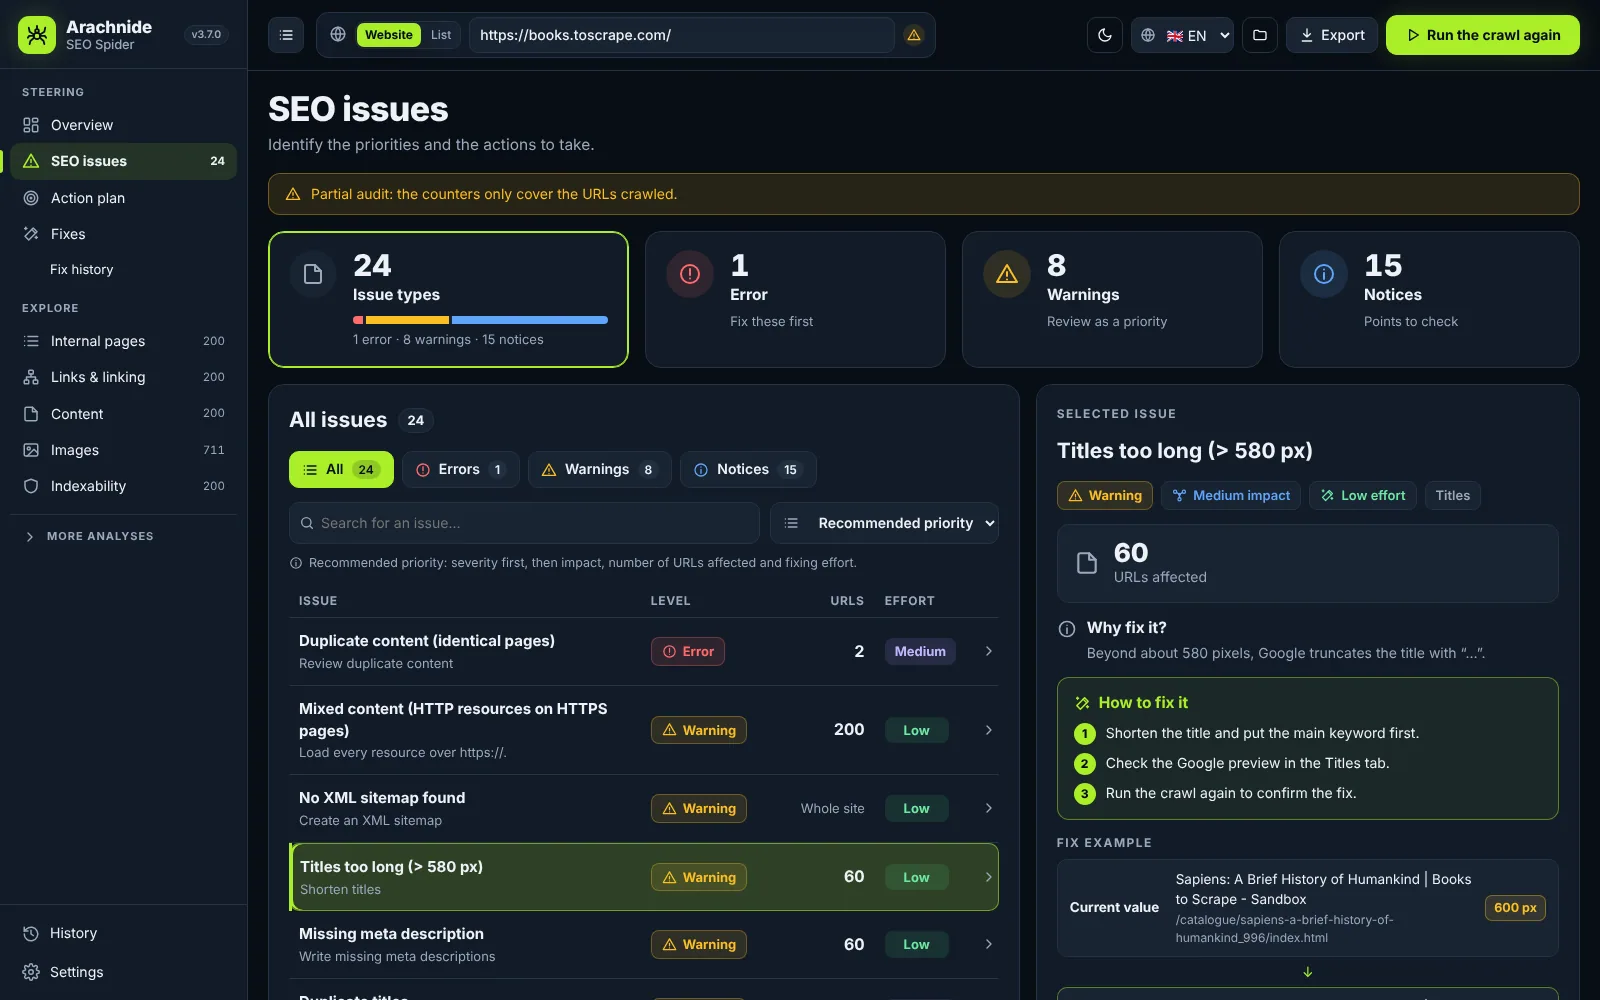
A página Problemas mostra o que foi encontrado, a gravidade, quantos URLs únicos afeta e o esforço necessário, com um painel de correção: porque é importante, passos numerados, um exemplo antes / depois tirado de uma página real e a lista de URLs a exportar.
- Prioridade recomendada: primeiro os erros, depois os avisos, depois as notas, ordenados por gravidade × impacto × URLs ÷ esforço.
- O plano de ação transforma cada problema numa ação com um verbo, uma posição, um critério «concluído quando», um estado (a fazer, em curso, a validar) e notas guardadas no seu navegador por site.
- Só um novo rastreio que já não deteta o problema o marca como resolvido.
Corrigir em 1 clique e conectores
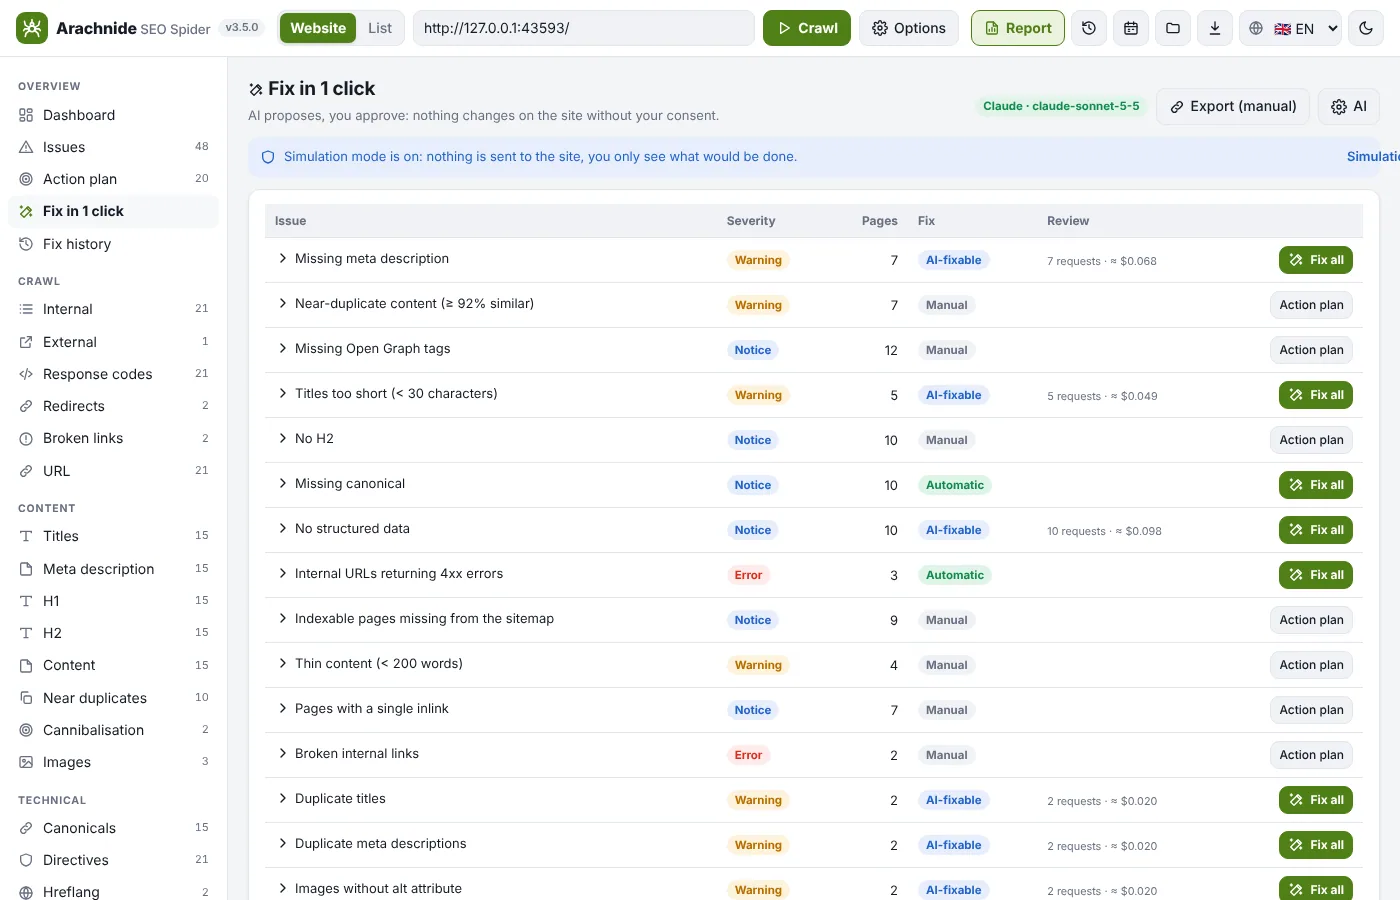
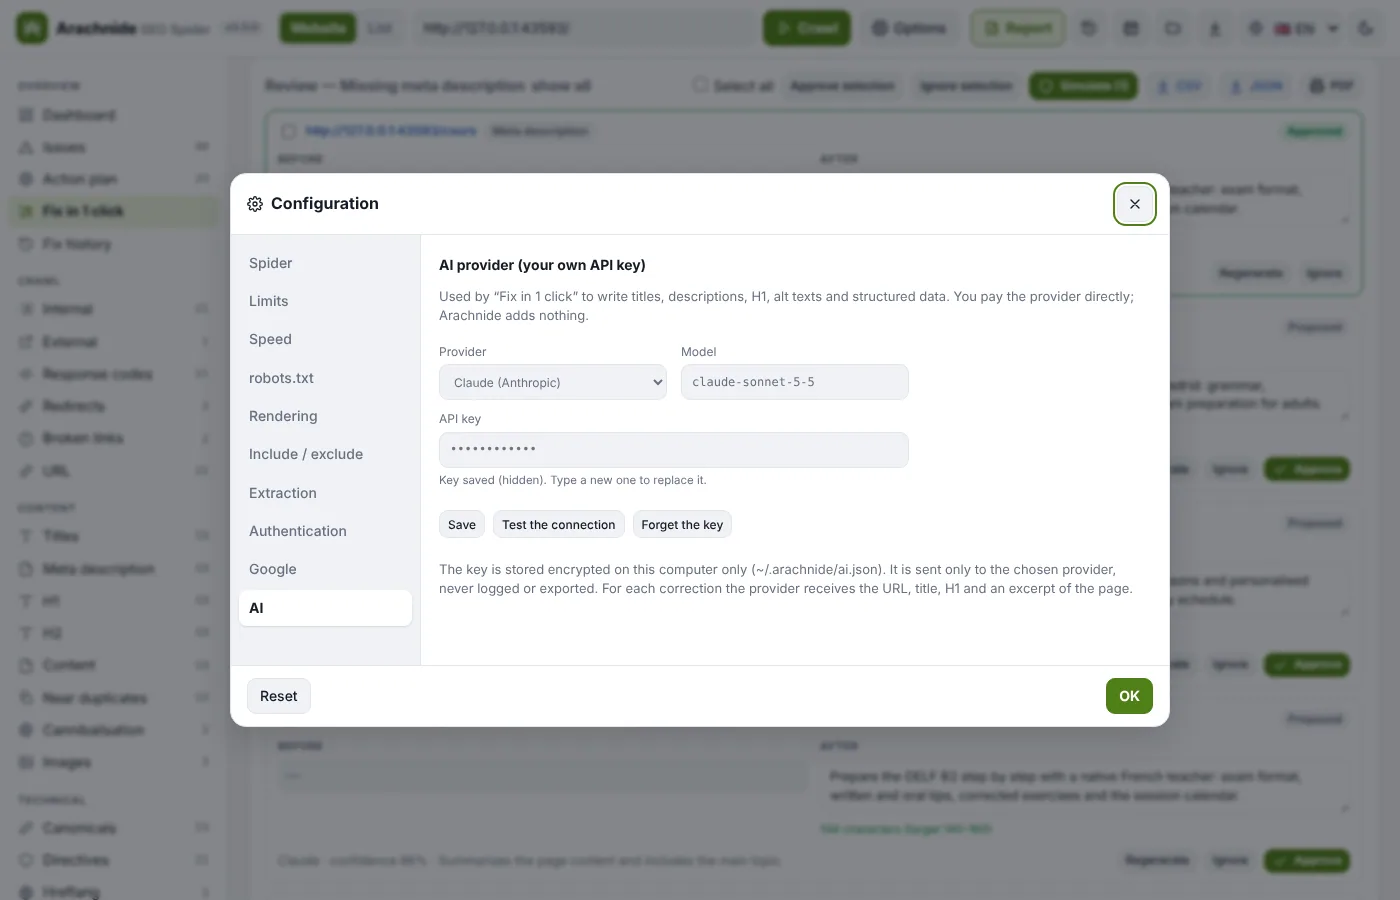
Desde a 3.5, o Claude (Anthropic) ou o ChatGPT (OpenAI) escrevem títulos, meta descriptions, H1, textos alternativos de imagens e JSON-LD a partir do conteúdo real de cada página, com a sua própria chave de API. Redirecionamentos 301, canonicals, noindex acidentais e links para redirecionamentos são calculados sem IA. Você revê, aprova, e um conector aplica a alteração.
- Conectores: WordPress (plugin complementar), Drupal, Joomla, PrestaShop, Shopify, Webflow, Wix, ficheiros (HTML estático mais _redirects, .htaccess, nginx ou vercel.json), Cloudflare Worker, pull request no GitHub e um modo manual com o caminho de cliques exato.
- Deteção automática do CMS, modo de simulação ativo por predefinição, política por site (campos permitidos, tamanho dos lotes, só leitura), histórico e anulação de uma correção ou de um lote inteiro, PDF «Correções aplicadas».
- As chaves e credenciais são guardadas cifradas no seu computador e nunca são enviadas para outro lado que não o fornecedor ou o CMS em causa.
Mapa do site em 2D e 3D
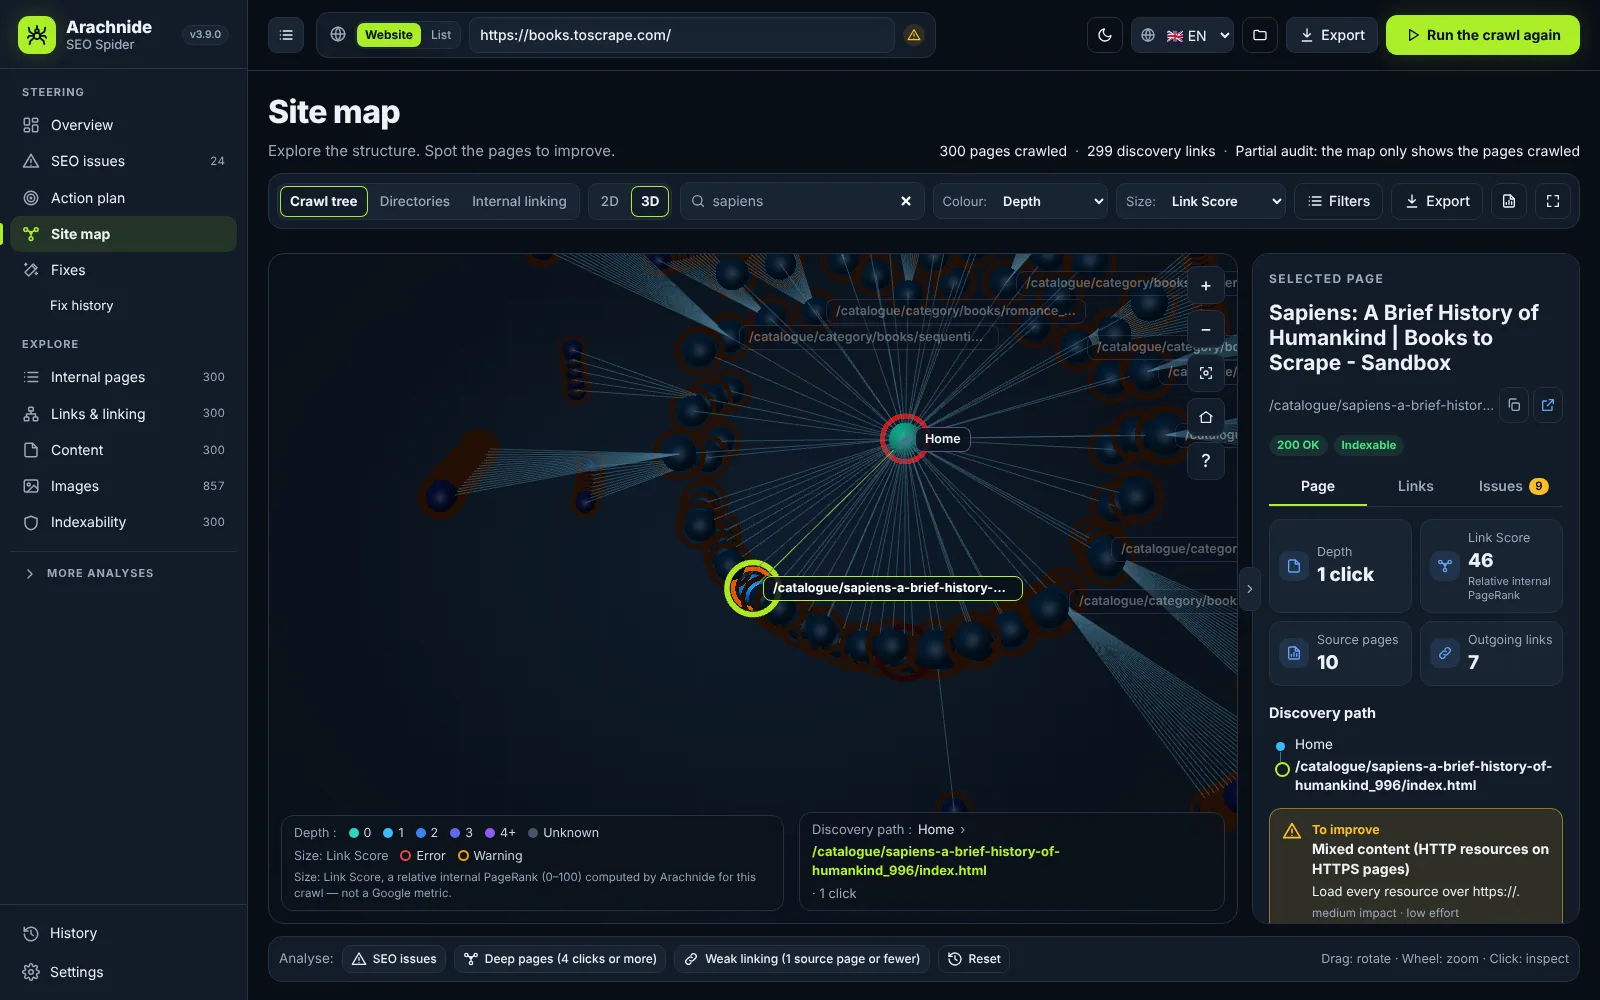
Duas vistas complementares partilham os mesmos dados, filtros, pesquisa e inspetor de página. O mapa do site é a árvore horizontal clássica ao estilo Screaming Frog sobre fundo branco, pensada para capturas de ecrã e relatórios para clientes. A visualização 2D / 3D é a vista de exploração: estilo escuro, disposição radial, colorida por problemas SEO por predefinição.
- Três representações: árvore de rastreio (caminho de cliques mais curto desde a página inicial), diretórios (estrutura dos URLs) e ligação interna (os links reais, com sentido).
- Filtros por pasta, padrões de URL (texto, caráter universal ou regex), problemas, profundidade, estado, indexabilidade, ligação de entrada fraca, intervalo de Link Score; destacar ou isolar.
- Inspetor de página com estado, profundidade, Link Score, páginas de origem, caminho de descoberta e problemas; exportações PNG e PDF com cabeçalho, legenda e contexto.
Segmentos
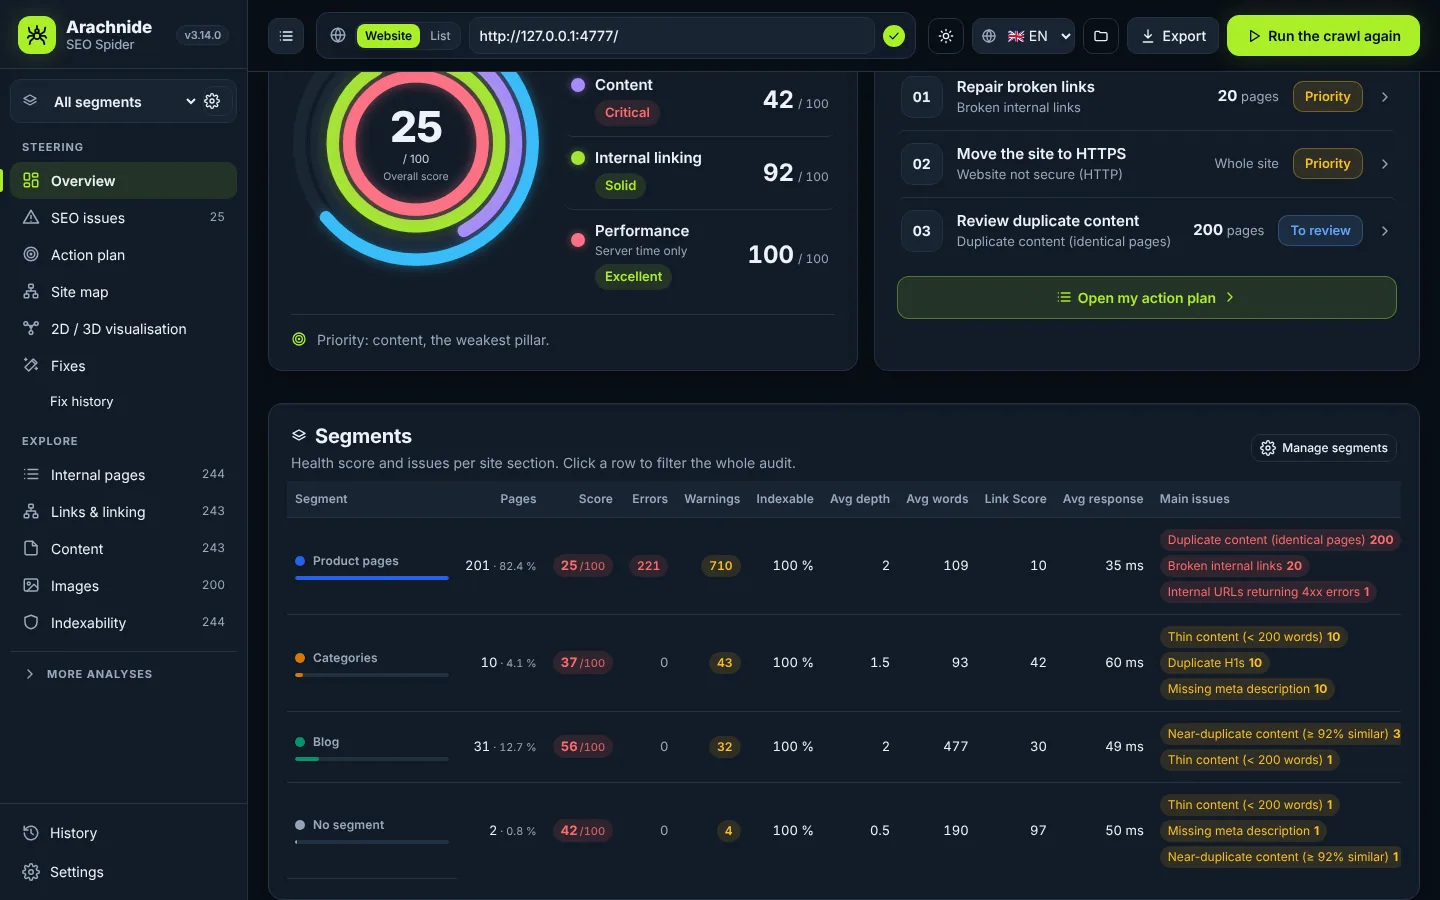
Num site grande, uma pontuação global esconde onde estão realmente os problemas. Os segmentos (3.14) dividem a auditoria em secções com nome, exatamente como os segmentos do Screaming Frog: páginas de produto, categorias, blog, um idioma, páginas sem tráfego.
- Regras sobre 20 campos (caminho, URL, title, H1, estado, indexabilidade, profundidade, palavras, links de entrada, Link Score, tempo de resposta, tipo de dados estruturados, idioma, cliques do Search Console, sessões GA4, extrações personalizadas) com operadores de texto, número e booleanos, combinados em E / OU.
- Ganha o primeiro segmento que corresponde; «criar a partir das pastas» constrói um segmento por pasta de primeiro nível num clique.
- Aplicados depois do rastreio sem novo rastreio; um filtro global recalcula o painel, a pontuação, os problemas, o plano de ação, as tabelas, as exportações CSV e o relatório PDF para essa secção.
Dados Google
Ligue os dados Google que um crawler não vê: PageSpeed Insights e Core Web Vitals de utilizadores reais do Chrome (CrUX), cliques, impressões, CTR e posição do Search Console por URL, e sessões do Google Analytics 4.
- Search Console por conta de serviço só de leitura ou por importação CSV; Google Analytics 4 por API ou CSV (3.15).
- Encontra as páginas que o Google vê mas que os seus links não alcançam, as páginas órfãs que ainda recebem tráfego, as páginas com CTR baixo e as páginas não indexáveis com tráfego.
- Rastreios agendados (diário, semanal, mensal) com alertas por e-mail quando a pontuação desce ou aparecem erros, comparados com o rastreio anterior, relatório completo em anexo.
Relatórios para clientes
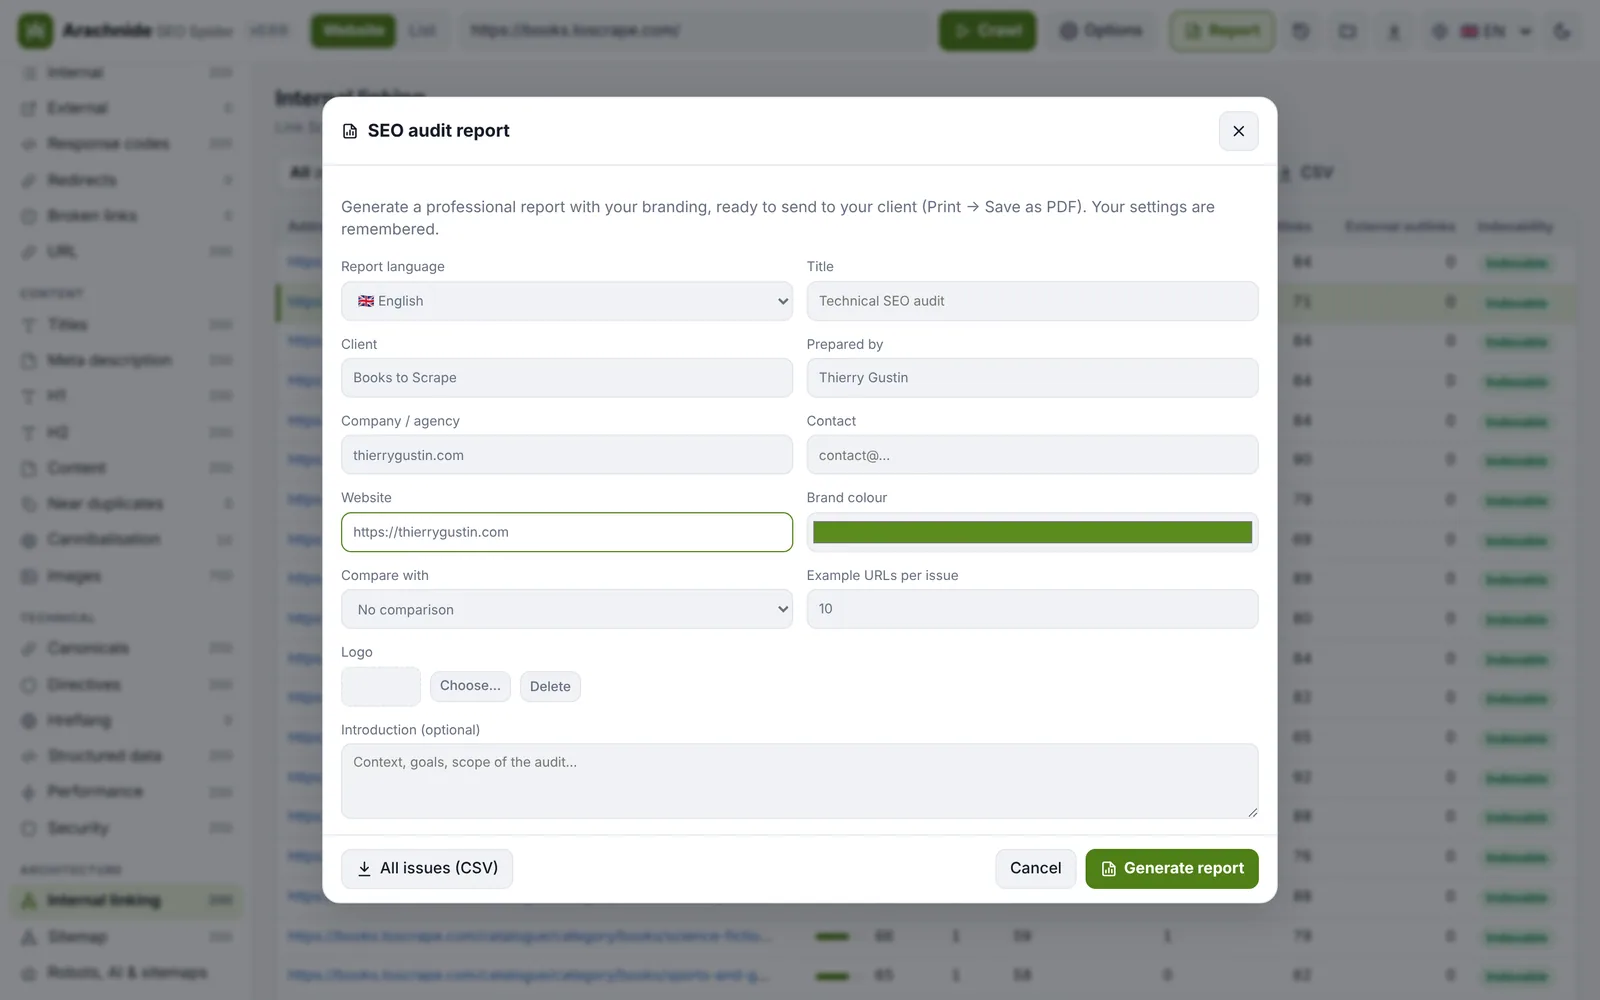
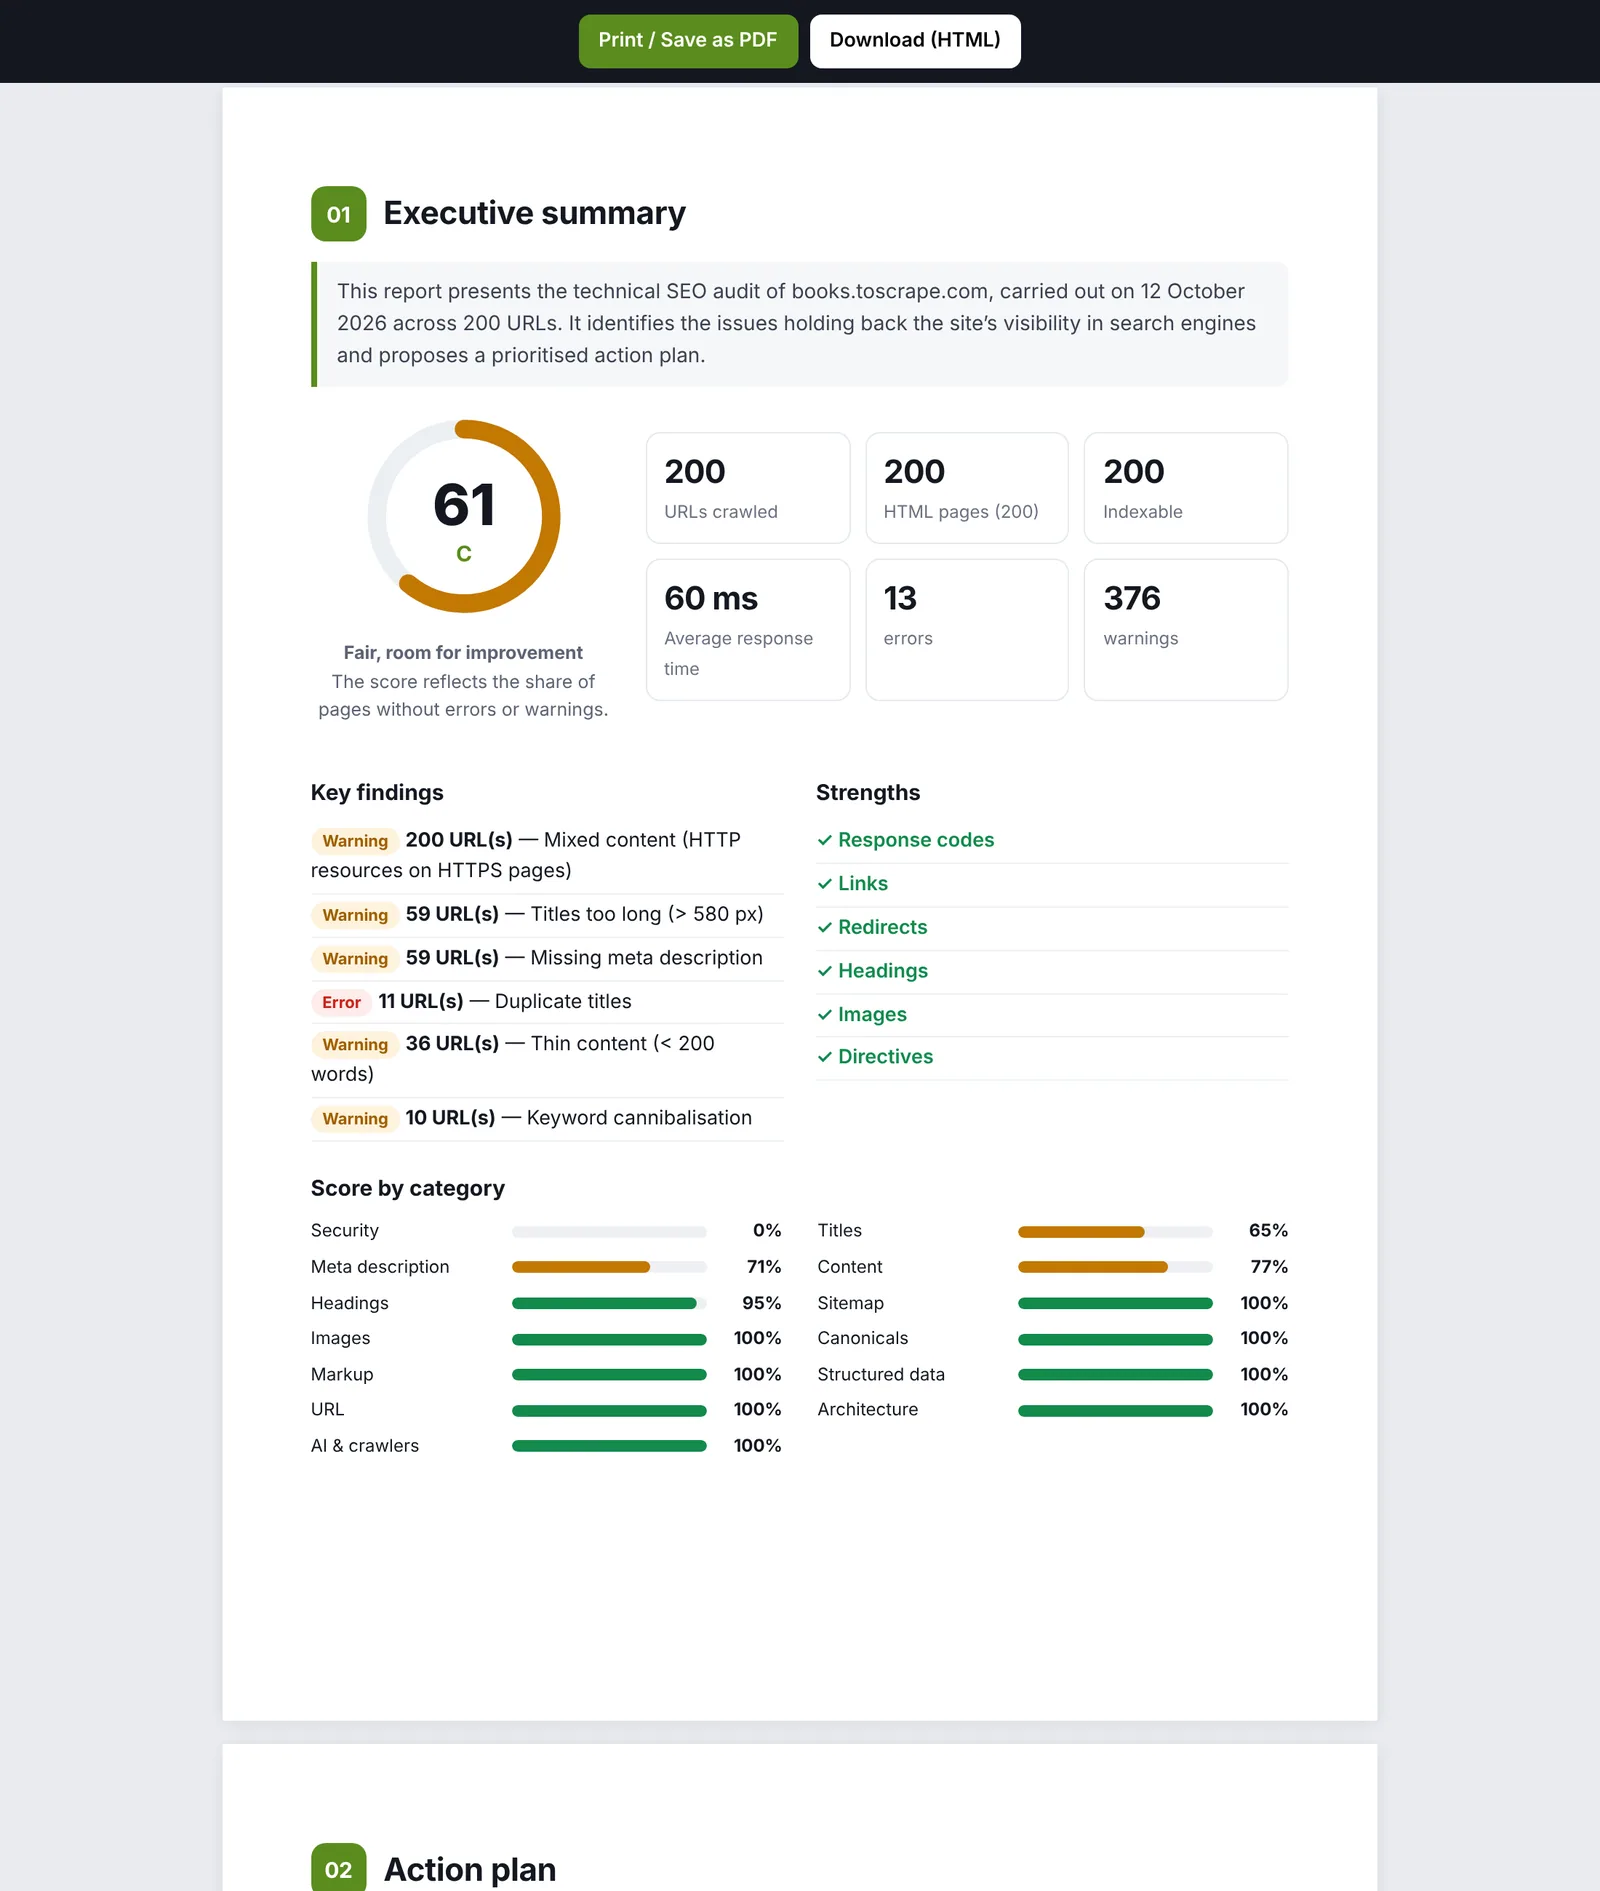
Um relatório HTML em marca branca que se imprime em PDF, em seis idiomas: o seu logótipo, a sua cor, o nome do cliente e os seus contactos, um resumo executivo, as principais conclusões, as pontuações por categoria, um plano de ação em três níveis de prioridade, uma análise detalhada com exemplos de URLs e a metodologia.
- Comparação com um rastreio anterior do mesmo site: variação da pontuação, problemas corrigidos, novos ou agravados, URL a URL.
- Resultados por segmento quando há segmentos definidos; um relatório para um único segmento identifica-o na capa.
- CSV de todos os problemas e de todas as páginas para o seu cliente ou programador.
Agentes de IA e GEO
Desde a 3.13, o Arachnide foi concebido para ser conduzido por um agente de IA: o seu, ou qualquer assistente que fale MCP (Claude) ou OpenAPI (Actions do ChatGPT, LangChain, n8n, Make). Três vias, um único conjunto de 25 ferramentas definidas uma só vez.
- MCP por stdio (Claude Desktop, Claude Code), MCP por HTTP (conectores personalizados do claude.ai, agentes alojados, Claude Agent SDK) e REST + OpenAPI 3.1 importável como Action do ChatGPT num clique.
- Pontuação de preparação GEO em 100: acesso dos crawlers de IA (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended…), llms.txt, cobertura de dados estruturados, profundidade do conteúdo, higiene.
- Token de acesso criado no primeiro arranque, 240 pedidos por minuto e por IP, registo das últimas chamadas na aplicação, ferramentas de escrita assinaladas como consequentes.
Extração personalizada e pesquisa
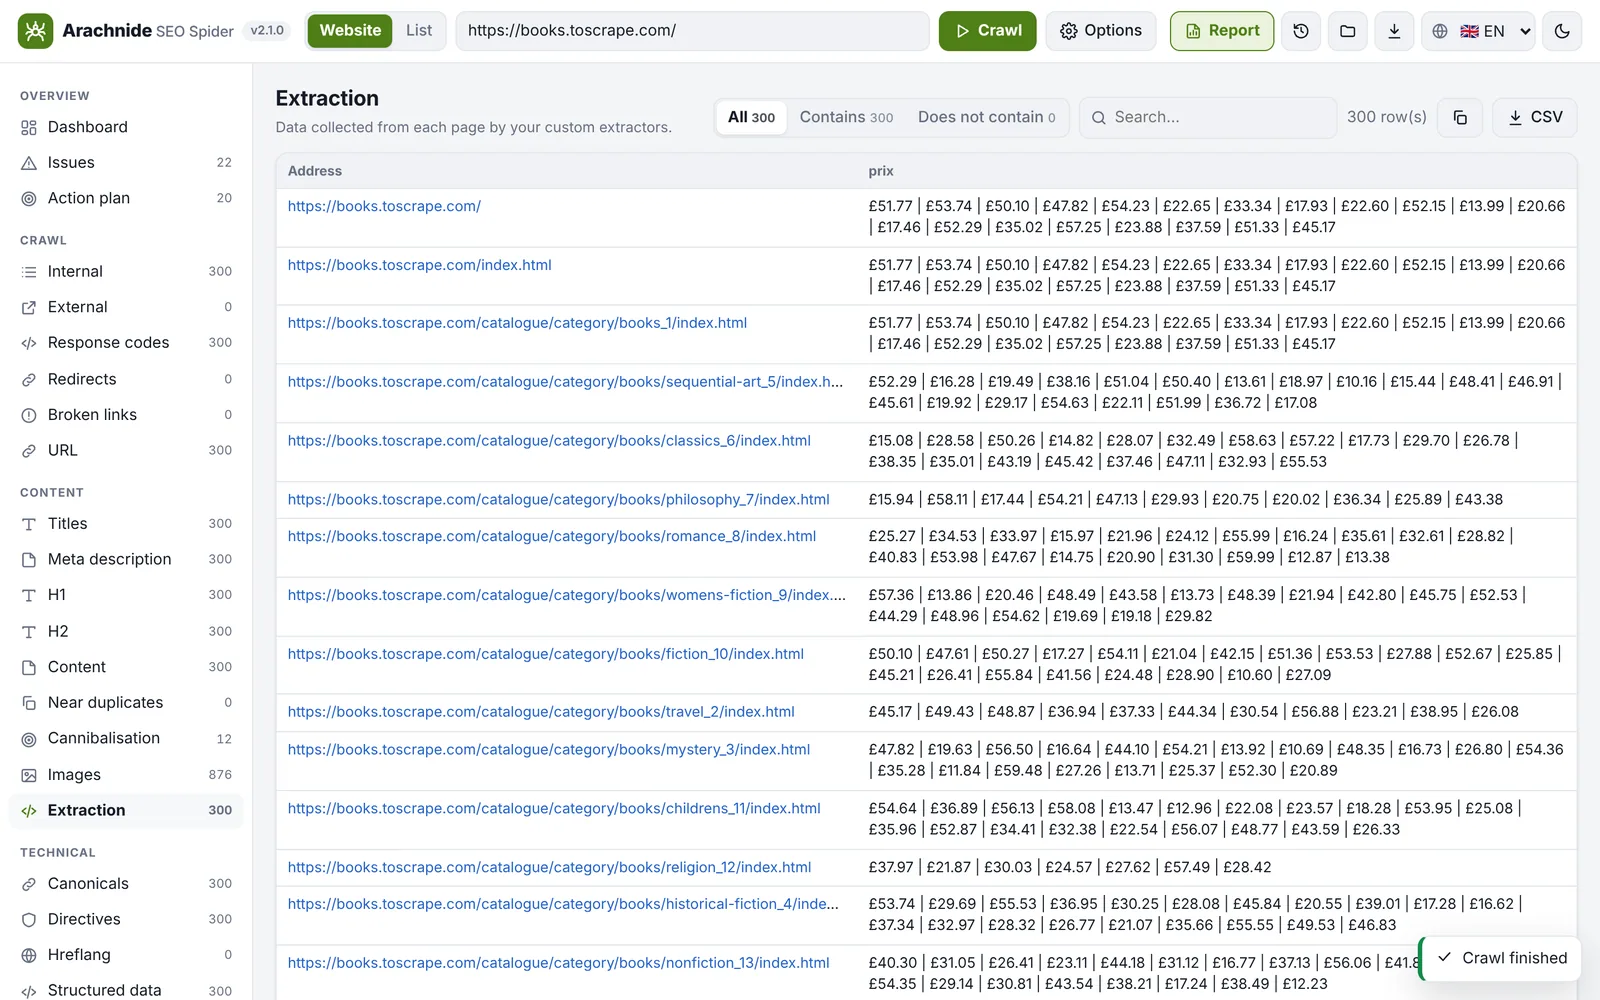
Recolha qualquer dado de cada página: preço, autor, data, SKU, código de acompanhamento. Até 20 extratores por seletor CSS (texto, atributo, HTML ou contagem), XPath (3.21) ou regex, com um separador Extração e uma coluna por regra na exportação CSV.
- Pesquisa personalizada: todas as páginas que contêm um texto ou uma regex, como um número de telefone antigo ou um código de acompanhamento.
- As extrações podem alimentar segmentos (extract:Price) e a CLI aceita as mesmas regras com --extract.
- Uma regex descontrolada é interrompida num worker ao fim de 2 s em vez de bloquear o rastreio.
Linha de comandos
Tudo o que a interface faz, a partir de um terminal ou de uma tarefa cron: node src/cli.mjs <url> [options]. A CLI mostra a pontuação e os problemas no seu idioma, grava o rastreio em NDJSON gzip que a interface pode abrir, e exporta o CSV e o relatório HTML.
- JSON (NDJSON gzip), pages.csv e issues.csv, relatório HTML com a sua marca, comparação com um rastreio anterior, segmentos, alertas por e-mail para o cron.
- --resume retoma um rastreio interrompido a partir do seu diário; --sitemap rastreia exatamente os URLs de um sitemap; --extract adiciona uma coluna CSV por regra.
- As mesmas opções da interface: limites, velocidade, modos robots.txt, user-agents, autenticação, incluir / excluir, dados Google.
Escala e desempenho
As versões 3.16 a 3.21 formaram um programa de escala em seis passos: grafo de links compacto em colunas de arrays tipados (14 bytes por link), NDJSON gzip escrito em fluxo, um diário de retoma, uma análise que compara todas as páginas para quase duplicados, e um navegador que nunca recebe o rastreio inteiro.
- Testado num site sintético local de 200 000 páginas e 19,9 milhões de links com npm run bench -- --pages 200000: rastreio e análise em 2086 s (cerca de 96 páginas por segundo), gravação em 38 s num ficheiro de 62,5 MB, memória máxima 2,7 GB.
- Salvaguardas de rastreio: o orçamento de páginas conta as páginas descarregadas, os parâmetros de acompanhamento são removidos, as armadilhas de facetas são assinaladas, um robots.txt inacessível proíbe tudo como exige a RFC 9309.
- O orçamento por predefinição é de 500 páginas: aumente-o em Opções → Limites para um site grande.