Configuração do rastreio
Cada opção de rastreio com o seu valor por predefinição - limites, velocidade, robots.txt, renderização, âmbito, extração, autenticação, modos lista e sitemap.
Clique em Opções (a engrenagem) para abrir a janela Configuração, inspirada na configuração do spider de um crawler de desktop. As suas definições ficam memorizadas, exceto a palavra-passe HTTP e os cabeçalhos personalizados, que muitas vezes contêm um cookie de sessão ou um token.
| Separador | Definições |
|---|---|
| Spider | Ler sitemaps XML, seguir canónicos, incluir subdomínios, verificar links externos e imagens |
| Limites | Total de rastreio, profundidade de rastreio, URLs por profundidade, profundidade de pastas, parâmetros de consulta, redirecionamentos a seguir, comprimento do URL, links por página, tamanho da página, limites por caminho de URL (/blog/ = 200, um por linha) |
| Velocidade | Número máximo de threads, máximo de URLs por segundo, tempo limite |
| robots.txt | Respeitar robots.txt / Ignorar robots.txt mas assinalar o estado / Ignorar robots.txt, robots.txt personalizado, testador de URLs |
| Renderização | Renderização JavaScript, user-agent (Arachnide, Googlebot desktop/smartphone, Chrome), Accept-Language |
| Incluir / excluir | Regex de inclusão / exclusão, remover parâmetros de URL (utm_*, gclid), ignorar todos os parâmetros, pesquisa personalizada |
| Extração | Até 20 extratores: seletor CSS (texto, atributo, HTML ou contagem) ou regex |
| Autenticação | Utilizador e palavra-passe HTTP, cabeçalhos personalizados (cookies, tokens) |
Spider
- Ler sitemaps XML (ativo): os sitemaps declarados no
robots.txtou em/sitemap.xmlsão lidos, incluindo os índices de sitemaps e os ficheiros.gz, e os seus URLs entram na fila. Os sitemaps de imagens e de vídeos são ignorados; são lidos no máximo 500 ficheiros de sitemap. - Seguir os canonicals (ativo): um canonical que aponta para um URL não rastreado coloca-o na fila.
- Incluir subdomínios (inativo):
blog.example.comfaz parte deexample.comapenas quando esta opção está ativa. Outra porta nunca é o site auditado. - Verificar os links externos e verificar as imagens (tamanho, estado, formato) estão inativos por predefinição, para manter leves os rastreios em sites de clientes.
Limites
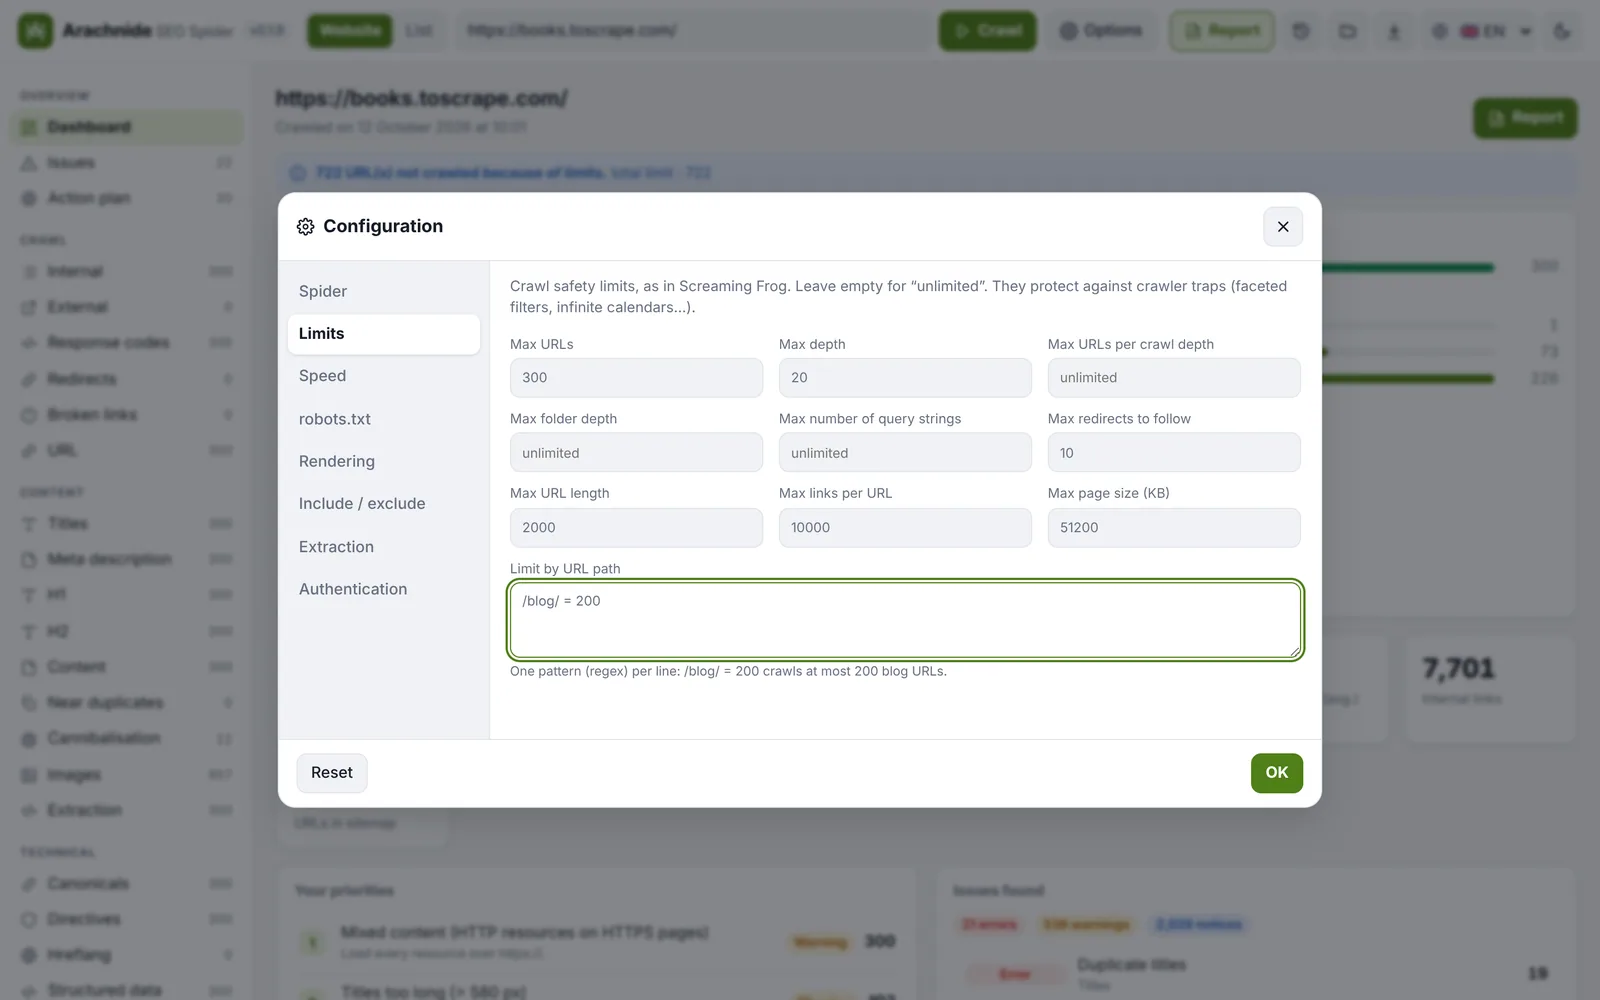
| Definição | Por predefinição | Notas |
|---|---|---|
Total de rastreio (maxPages) | 500 | Conta as páginas realmente descarregadas; os URLs bloqueados pelo robots.txt não o consomem. Até 10 000 000. |
Profundidade de rastreio (maxDepth) | 20 | Os redirecionamentos não acrescentam profundidade. |
URLs por profundidade, profundidade de pastas, parâmetros de consulta, redirecionamentos a seguir (10), comprimento do URL, links por página, tamanho da página (maxPageSizeKb) | — | Os URLs ignorados são contados por motivo no painel. Os corpos das respostas são lidos em fluxo e abandonados além do limite de tamanho. |
| Limites por caminho de URL | — | Um por linha, ex. /blog/ = 200. |
Velocidade
- Máximo de threads (
concurrency): 5 por predefinição, de 1 a 30. Num site de cliente, fique entre 2 e 5. - Máximo de URLs por segundo (
maxUrlPerSec): um limite global, útil em alojamento partilhado. - Pausa entre pedidos por worker, e tempo limite.
As respostas de limitação de pedidos (429 e 503 com Retry-After) são respeitadas e o pedido é repetido; os 500, 502, 504 e os erros de ligação têm uma nova tentativa diferida no fim da fila.
robots.txt
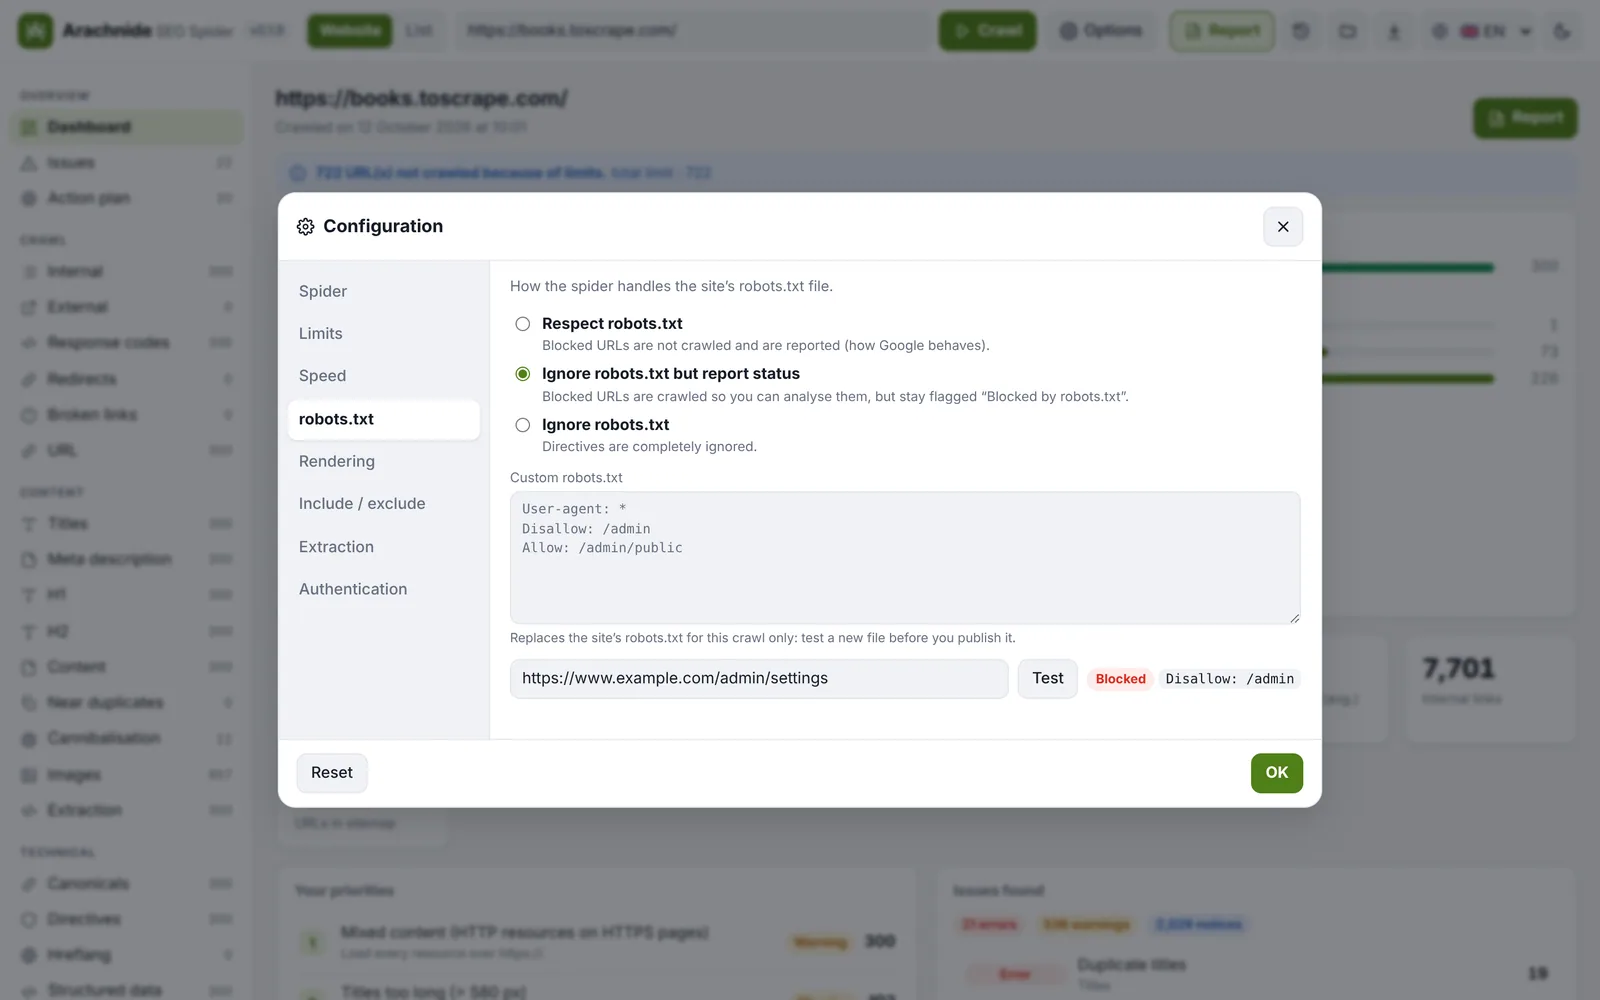
Três modos: respeitar (por predefinição), ignorar mas assinalar (os URLs bloqueados são rastreados e continuam assinalados) e ignorar. Pode colar um robots.txt personalizado para testar um ficheiro antes de o publicar, e o testador integrado diz se um URL é permitido e que regra se aplica. O Arachnide segue as regras do Google para o robots.txt (RFC 9309):
- um robots.txt que responde 4xx significa que tudo é permitido;
- um robots.txt que responde 5xx ou inacessível significa que tudo é proibido, com um aviso explícito. Duas saídas: a opção robots.txt indisponível → permitir (
--robots-unavailable allow), ou o modo assinalar / ignorar; - em modo lista e com subdomínios, o robots.txt é lido uma vez por anfitrião.
Renderização
A renderização JavaScript usa o Chrome, Edge, Chromium ou Brave já instalado (através de puppeteer-core; nada é transferido). O Arachnide compara o HTML bruto com a página renderizada (conteúdo, links, título, H1, canonical, noindex), assinala os erros JS e os redirecionamentos JavaScript, e mede o LCP e o CLS em laboratório. O Chrome é reiniciado a cada 500 páginas renderizadas para limitar a sua memória, e reiniciado uma vez se morrer.
User-agent: Arachnide (por predefinição), Googlebot desktop, Googlebot smartphone, Chrome, ou uma cadeia personalizada. Tal como o Googlebot, nenhum cabeçalho Accept-Language é enviado por predefinição; pode definir um. Se um site responder 403 ao user-agent do Arachnide, o rastreio passa automaticamente para o Chrome e avisa-o.
Incluir / excluir
- Incluir e excluir: uma expressão regular por linha. Uma linha inválida é ignorada e assinalada. O URL inicial é sempre rastreado.
- Ficar no diretório inicial:
https://example.com/blog/rastreia apenas/blog/…. - Remover parâmetros de URL como
utm_*ougclid(carateres universais aceites). Desde a 3.21, os parâmetros são ordenados por chave e os parâmetros de acompanhamento conhecidos (utm_*,gclid,fbclid,msclkid,mc_cid,srsltid,_ga…) são removidos por predefinição, pelo que?a=1&b=2e?b=2&a=1são uma única página; manter os parâmetros tal como estão repõe o comportamento bruto. - Ignorar todos os parâmetros, e pesquisa personalizada (um texto ou
/regex/a encontrar no código-fonte). - Um caminho que produz 200 variantes de parâmetros é assinalado uma vez como armadilha de facetas, a assinatura de filtros combináveis que consomem o orçamento.
Extração
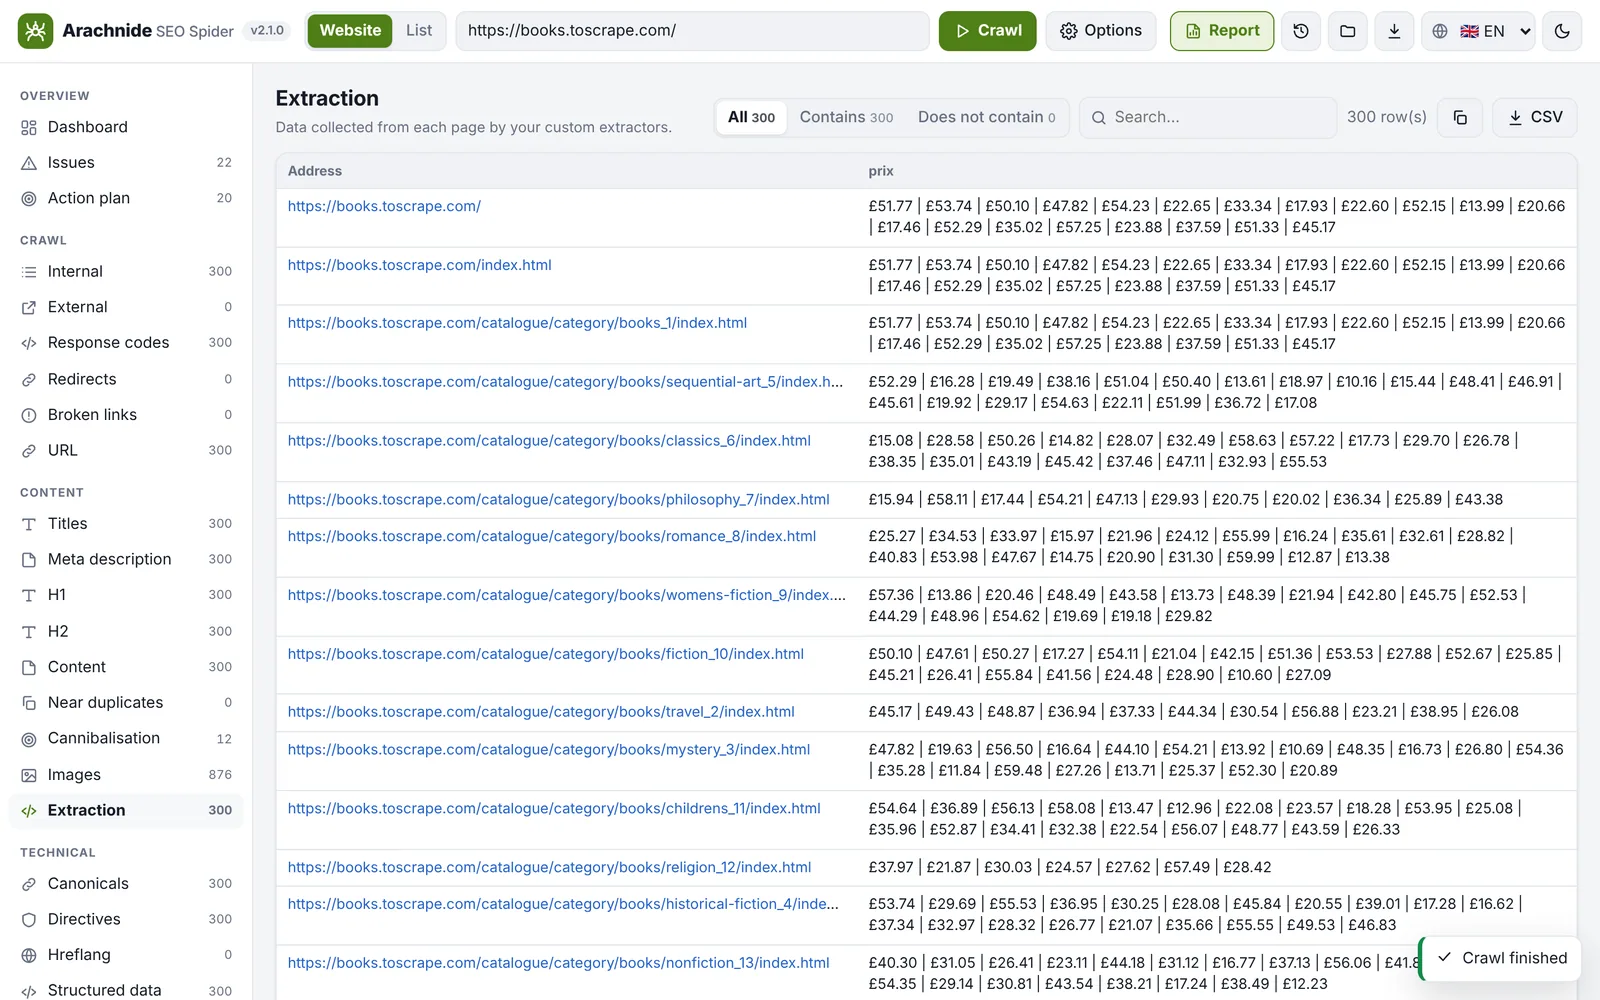
Até 20 extratores, cada um com um nome e uma regra:
- Seletor CSS com um alvo: texto, atributo, HTML interno ou contagem;
- XPath (3.21): avaliado no Chrome em modo de renderização, ou sobre o HTML bruto através de
jsdom, uma dependência opcional carregada apenas quando existe uma regra XPath (npm install jsdomse vir o aviso); - Regex, executada num worker com um tempo limite de 2 segundos: um padrão catastrófico é interrompido para essa página e o rastreio continua.
Os valores aparecem no separador Extração, numa coluna por regra em pages.csv, e podem alimentar segmentos com o campo extract:<nome>. A CLI aceita as mesmas regras com --extract (consulte Linha de comandos).
Autenticação
Autenticação HTTP (utilizador e palavra-passe) e cabeçalhos personalizados (cookies, tokens) para sites de pré-produção. São enviados apenas ao site auditado, também em modo de renderização, e nunca são guardados.
Modos site, lista e sitemap
O seletor junto ao campo de endereço escolhe entre rastrear um site (seguindo os links) e uma lista de URLs que cola (até 500 000 URLs desde a 3.21; os links não são seguidos, a ligação interna não é medida). A CLI acrescenta --list urls.txt e --sitemap URL, que rastreia exatamente os URLs de um sitemap ou índice de sitemaps, sem duplicados e normalizados. Os agentes de IA têm os mesmos modos através de mode, urls e sitemap_url nas ferramentas de rastreio.
Retomar um rastreio interrompido
Durante um rastreio, o Arachnide vai acrescentando a um diário de retoma (crawls/.en-cours/<id>.ndjson): cada URL em fila, cada página processada. Após uma falha ou uma paragem, o diário é listado no ecrã inicial e o rastreio pode ser retomado onde parou, perdendo apenas os últimos segundos. O diário é eliminado quando o rastreio termina. Na CLI: --resume FICHEIRO, ou --no-journal para não escrever nada.