Funktionen
Alles ist in Version 3.21.0 enthalten, kostenlos, ohne Funktion hinter einer Bezahlschranke. Jeder Abschnitt verweist auf seine Dokumentationsseite.
Audit und Health Score
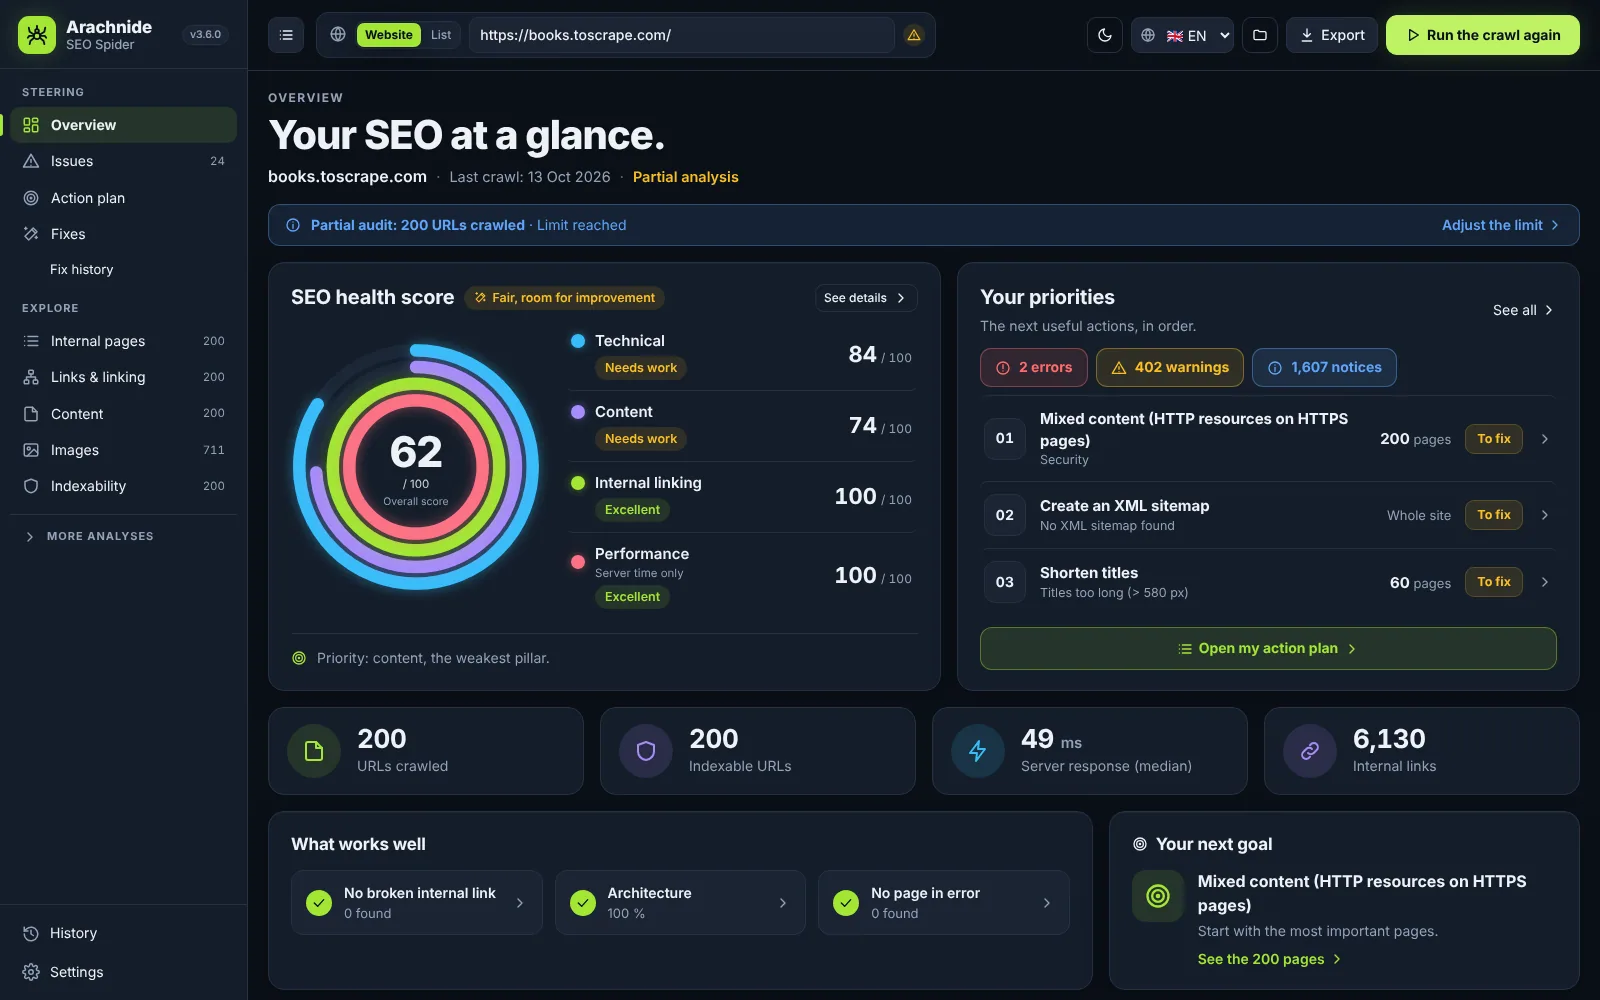
Ein Crawl liefert Ihnen einen Health Score von 100 mit Note A–F, vier Säulen-Scores (Technik, Inhalt, Verlinkung, Performance), Ihre wichtigsten Prioritäten in eindeutigen Seiten gezählt, Kennzahlen, was gut funktioniert und Ihr nächstes Ziel. Säulen ohne Daten werden als „Nicht gemessen“ angezeigt, nie als guter Score.
- Rund 95 Prüfungen in 14 Familien: Statuscodes, Weiterleitungen, Titles und Metas, Überschriften, Inhalt, Bilder, Indexierung, Architektur, Sitemaps, International, strukturierte Daten, JavaScript, Performance und Sicherheit, URLs, KI und GEO.
- Link Score (interner PageRank), Klicktiefe, verwaiste Seiten, Beinahe-Duplikate (simhash), Keyword-Kannibalisierung, Breite von Title und Description in Pixeln mit Google-SERP-Vorschau.
- JavaScript-Rendering mit dem bereits installierten Chrome oder Edge: Roh-HTML gegen gerenderte Seite, JS-Fehler, LCP und CLS.
SEO-Probleme und Maßnahmenplan
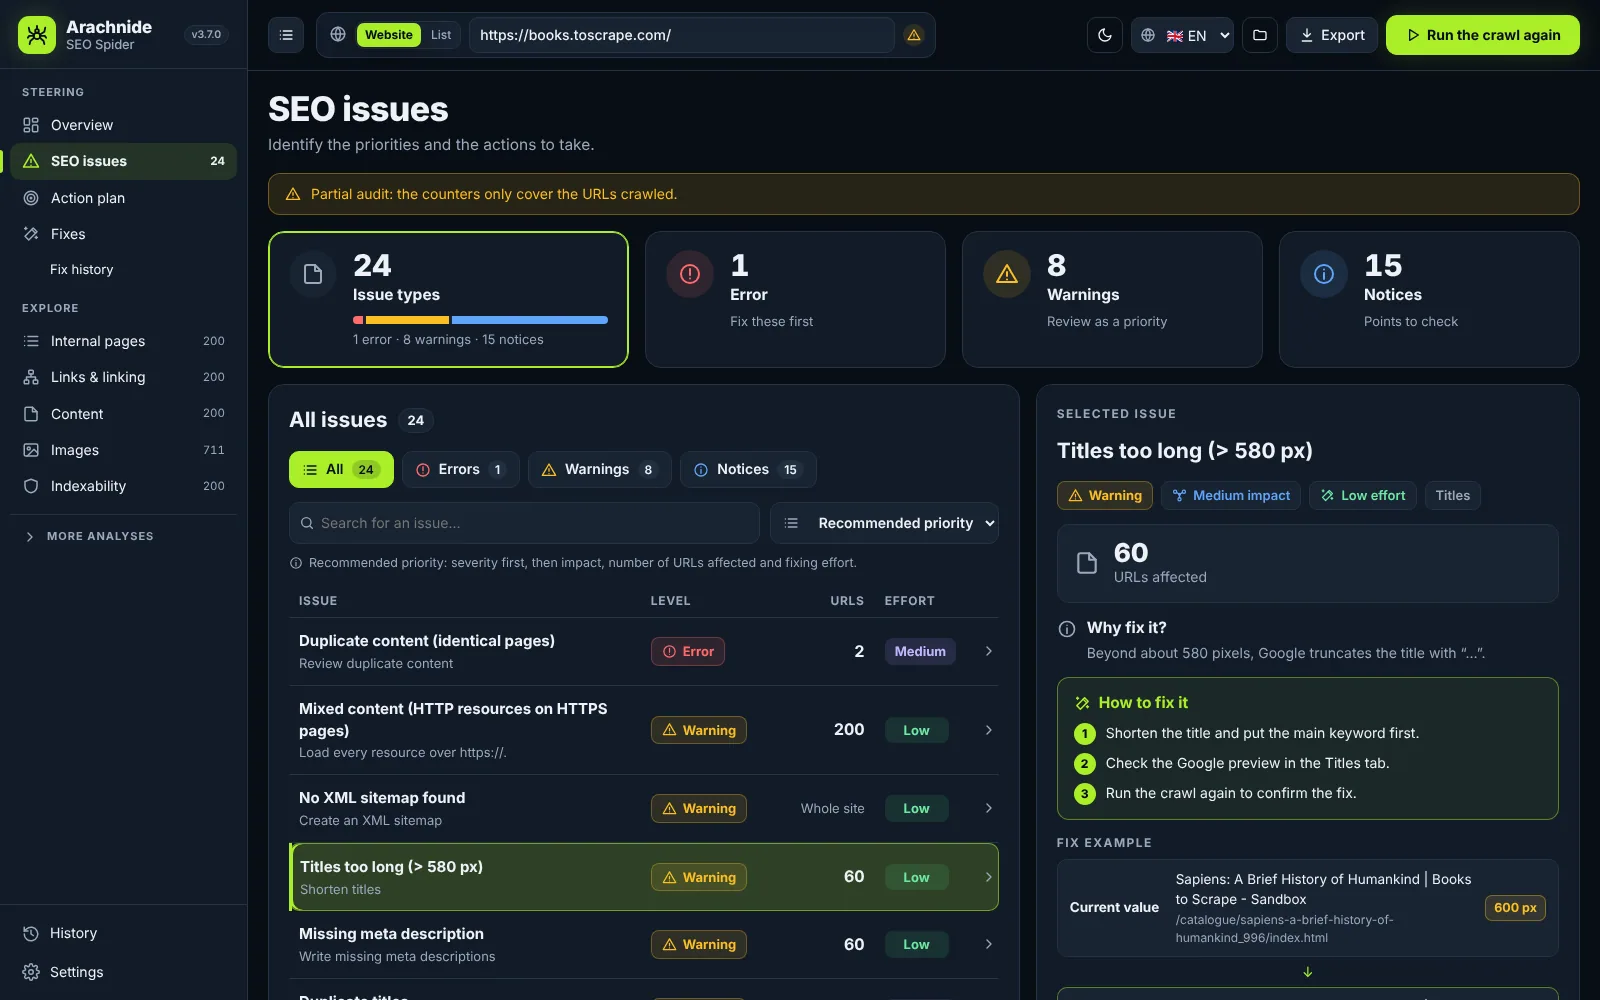
Die Seite Probleme zeigt, was gefunden wurde, wie schwer es wiegt, wie viele eindeutige URLs betroffen sind und wie viel Aufwand es kostet, mit einem Korrekturbereich: warum es wichtig ist, nummerierte Schritte, ein Vorher-/Nachher-Beispiel von einer echten Seite und die Liste der URLs zum Export.
- Empfohlene Priorität: zuerst Fehler, dann Warnungen, dann Hinweise, sortiert nach Schweregrad × Wirkung × URLs ÷ Aufwand.
- Der Maßnahmenplan macht aus jedem Problem eine Maßnahme mit Verb, Rang, Kriterium „Erledigt, wenn“, Status (zu erledigen, in Bearbeitung, zu validieren) und Notizen, die pro Website in Ihrem Browser gespeichert werden.
- Erst ein neuer Crawl, der das Problem nicht mehr findet, markiert es als gelöst.
Mit 1 Klick korrigieren und Connectors
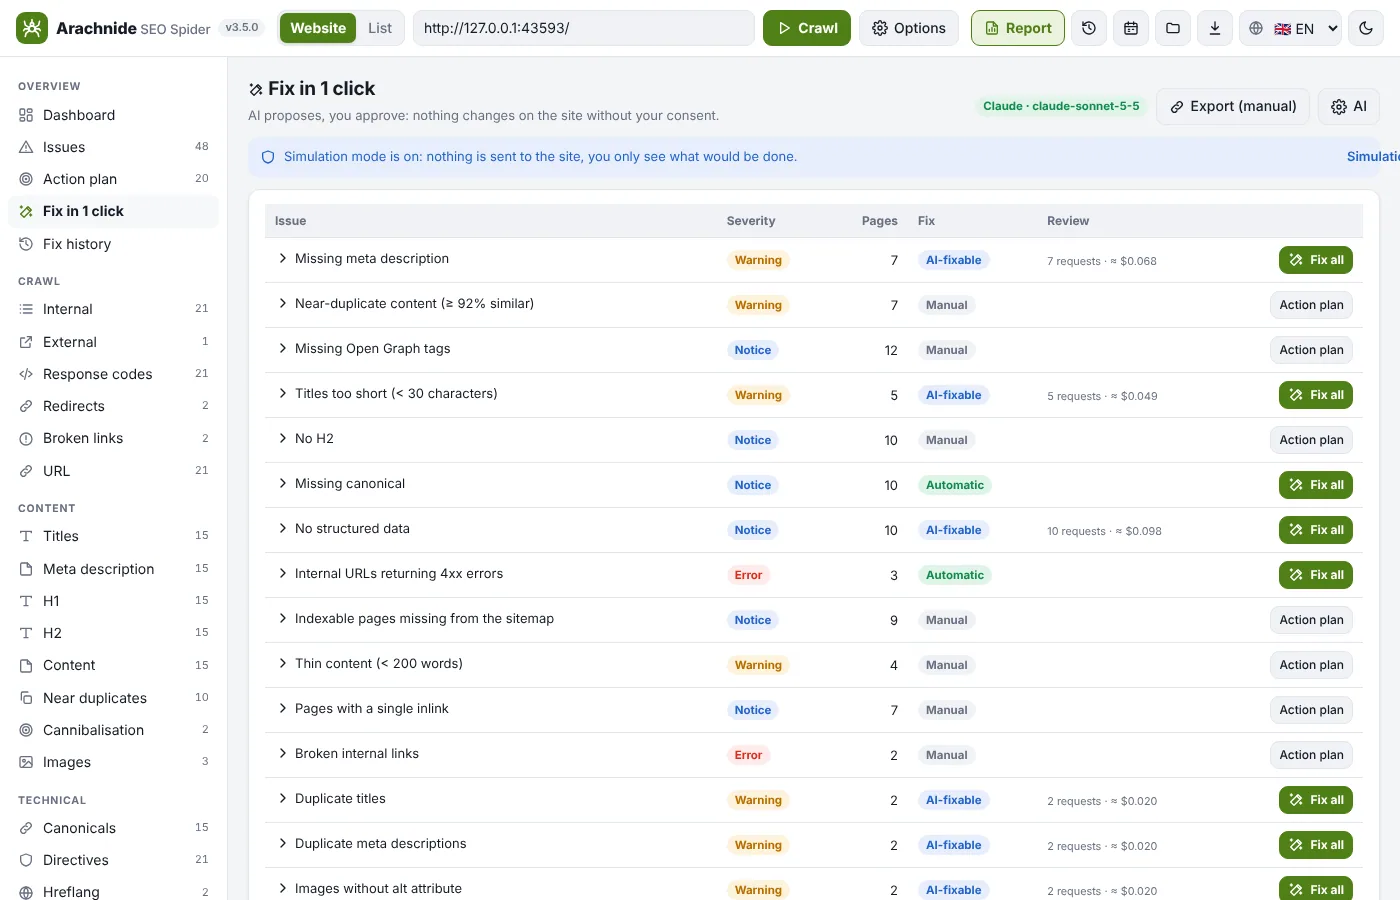
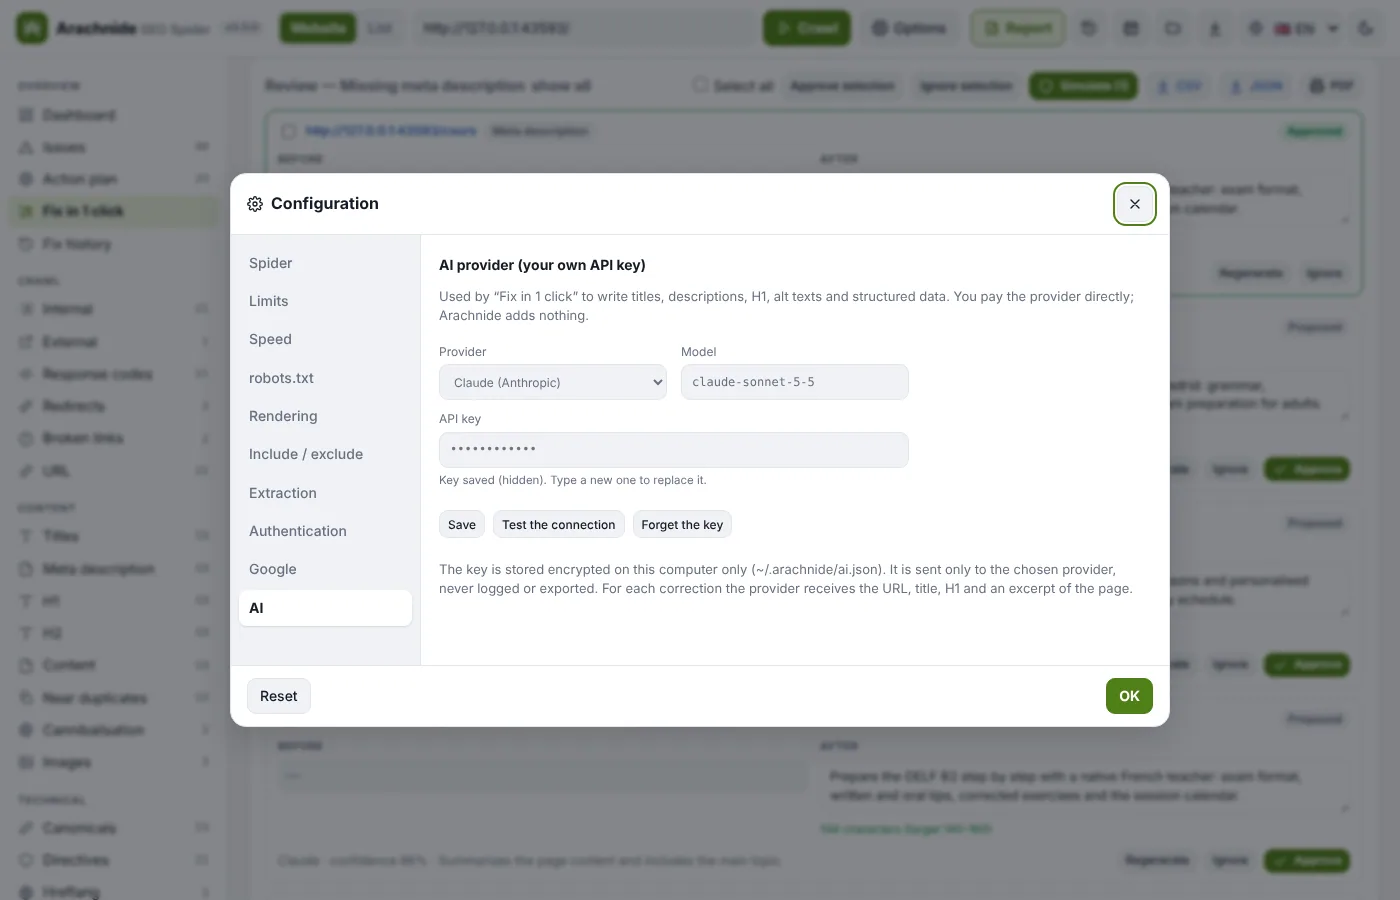
Seit 3.5 schreiben Claude (Anthropic) oder ChatGPT (OpenAI) Titles, Meta Descriptions, H1, Alt-Texte für Bilder und JSON-LD auf Basis des echten Inhalts jeder Seite, mit Ihrem eigenen API-Schlüssel. 301-Weiterleitungen, Canonicals, versehentliches noindex und Links auf Weiterleitungen werden ohne KI berechnet. Sie prüfen, geben frei, und ein Connector wendet die Änderung an.
- Connectors: WordPress (Begleit-Plugin), Drupal, Joomla, PrestaShop, Shopify, Webflow, Wix, Dateien (statisches HTML plus _redirects, .htaccess, nginx oder vercel.json), Cloudflare Worker, GitHub-Pull-Request und ein manueller Modus mit exakten Klickpfaden.
- Automatische CMS-Erkennung, Simulationsmodus standardmäßig aktiv, Regeln pro Website (erlaubte Felder, Stapelgröße, Nur-Lesen), Verlauf und Rückgängigmachen einer Korrektur oder eines ganzen Stapels, PDF „Angewendete Korrekturen“.
- Schlüssel und Zugangsdaten werden verschlüsselt auf Ihrem Computer gespeichert und an niemanden gesendet außer an den betroffenen Anbieter oder das betroffene CMS.
Website-Karte in 2D und 3D
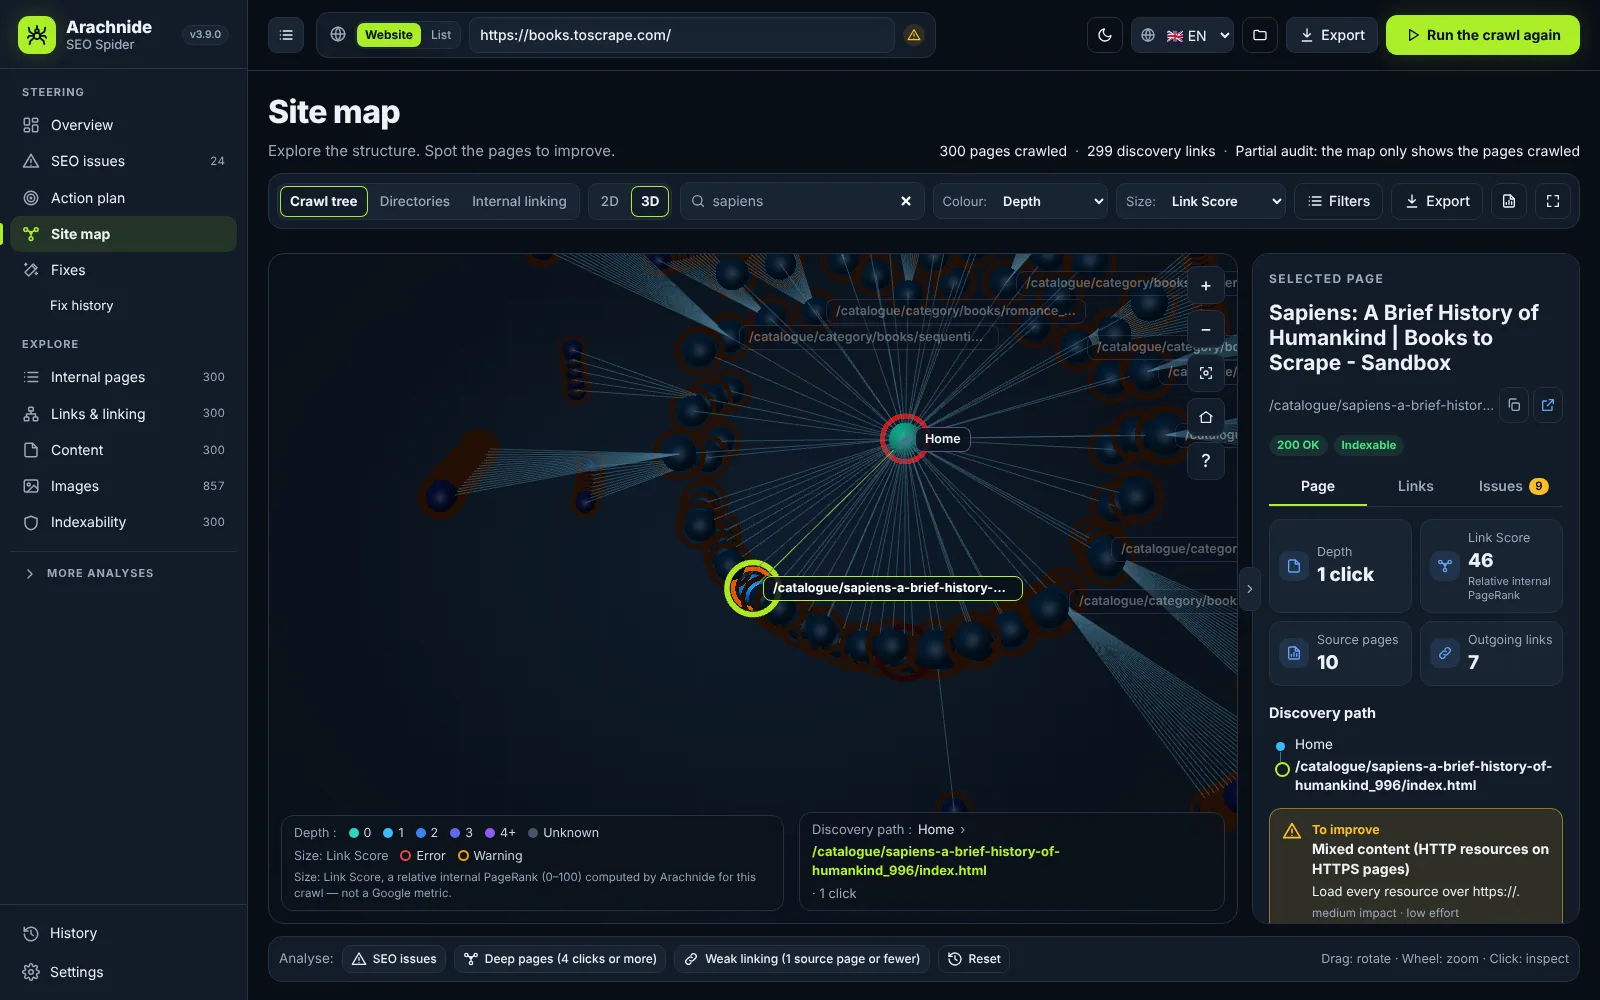
Zwei sich ergänzende Ansichten teilen sich dieselben Daten, Filter, Suche und Seiteninspektor. Die Website-Karte ist der klassische horizontale Baum im Stil von Screaming Frog auf weißem Hintergrund, gemacht für Screenshots und Kundenberichte. Die 2D-/3D-Visualisierung ist die Erkundungsansicht: dunkler Stil, radiales Layout, standardmäßig nach SEO-Problemen eingefärbt.
- Drei Darstellungen: Crawl-Baum (kürzester Klickpfad von der Startseite), Verzeichnisse (URL-Struktur) und interne Verlinkung (die tatsächlichen gerichteten Links).
- Filter nach Ordner, URL-Mustern (Text, Platzhalter oder Regex), Problemen, Tiefe, Status, Indexierbarkeit, schwacher eingehender Verlinkung, Link-Score-Bereich; hervorheben oder isolieren.
- Seiteninspektor mit Status, Tiefe, Link Score, Quellseiten, Entdeckungspfad und Problemen; PNG- und PDF-Exporte mit Kopfzeile, Legende und Kontext.
Segmente
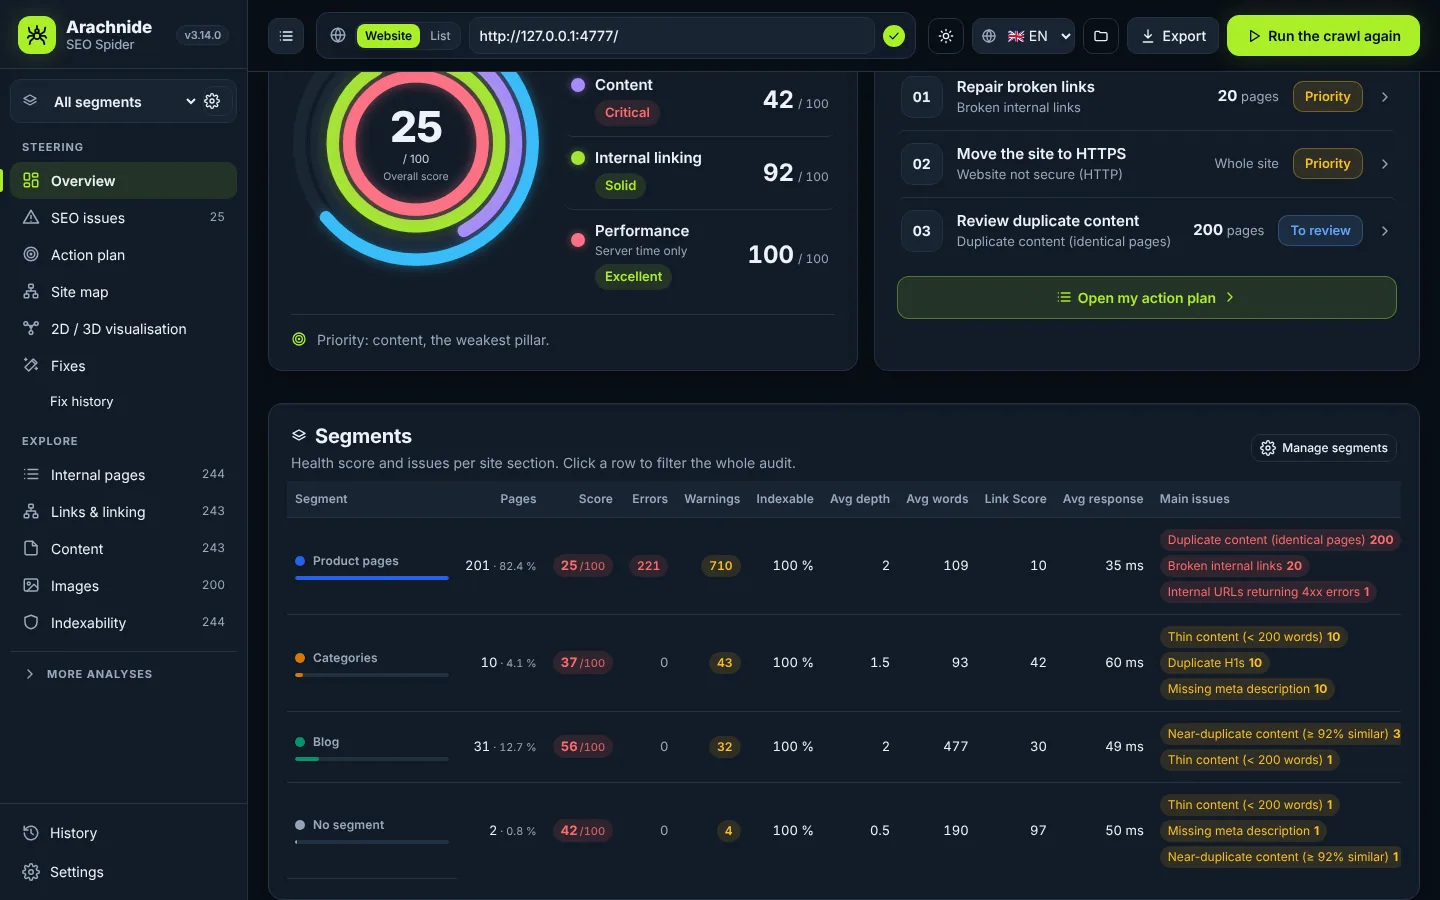
Auf einer großen Website verdeckt ein globaler Score, wo die Probleme wirklich liegen. Segmente (3.14) teilen das Audit in benannte Bereiche, genau wie die Segmente von Screaming Frog: Produktseiten, Kategorien, Blog, eine Sprache, Seiten ohne Traffic.
- Regeln auf 20 Feldern (Pfad, URL, Title, H1, Status, Indexierbarkeit, Tiefe, Wörter, eingehende Links, Link Score, Antwortzeit, Typ strukturierter Daten, Sprache, Search-Console-Klicks, GA4-Sitzungen, benutzerdefinierte Extraktionen) mit Text-, Zahl- und Wahr/Falsch-Operatoren, kombiniert mit UND / ODER.
- Das erste passende Segment gewinnt; „Aus Verzeichnissen erstellen“ legt mit einem Klick ein Segment pro Verzeichnis der ersten Ebene an.
- Nach dem Crawl angewendet, ohne erneutes Crawlen; ein globaler Filter berechnet Übersicht, Score, Probleme, Maßnahmenplan, Tabellen, CSV-Exporte und PDF-Bericht für diesen Bereich neu.
Google-Daten
Verbinden Sie die Google-Daten, die ein Crawler nicht sehen kann: PageSpeed Insights und Core Web Vitals echter Chrome-Nutzer (CrUX), Klicks, Impressionen, CTR und Position aus der Search Console je URL sowie Sitzungen aus Google Analytics 4.
- Search Console per Dienstkonto mit Lesezugriff oder per CSV-Import; Google Analytics 4 per API oder CSV (3.15).
- Findet Seiten, die Google sieht, aber Ihre Links nicht erreichen, verwaiste Seiten, die noch Traffic erhalten, Seiten mit niedriger CTR und nicht indexierbare Seiten mit Traffic.
- Geplante Crawls (täglich, wöchentlich, monatlich) mit E-Mail-Benachrichtigung, wenn der Score sinkt oder Fehler auftreten, verglichen mit dem vorherigen Crawl, vollständiger Bericht im Anhang.
Kundenberichte
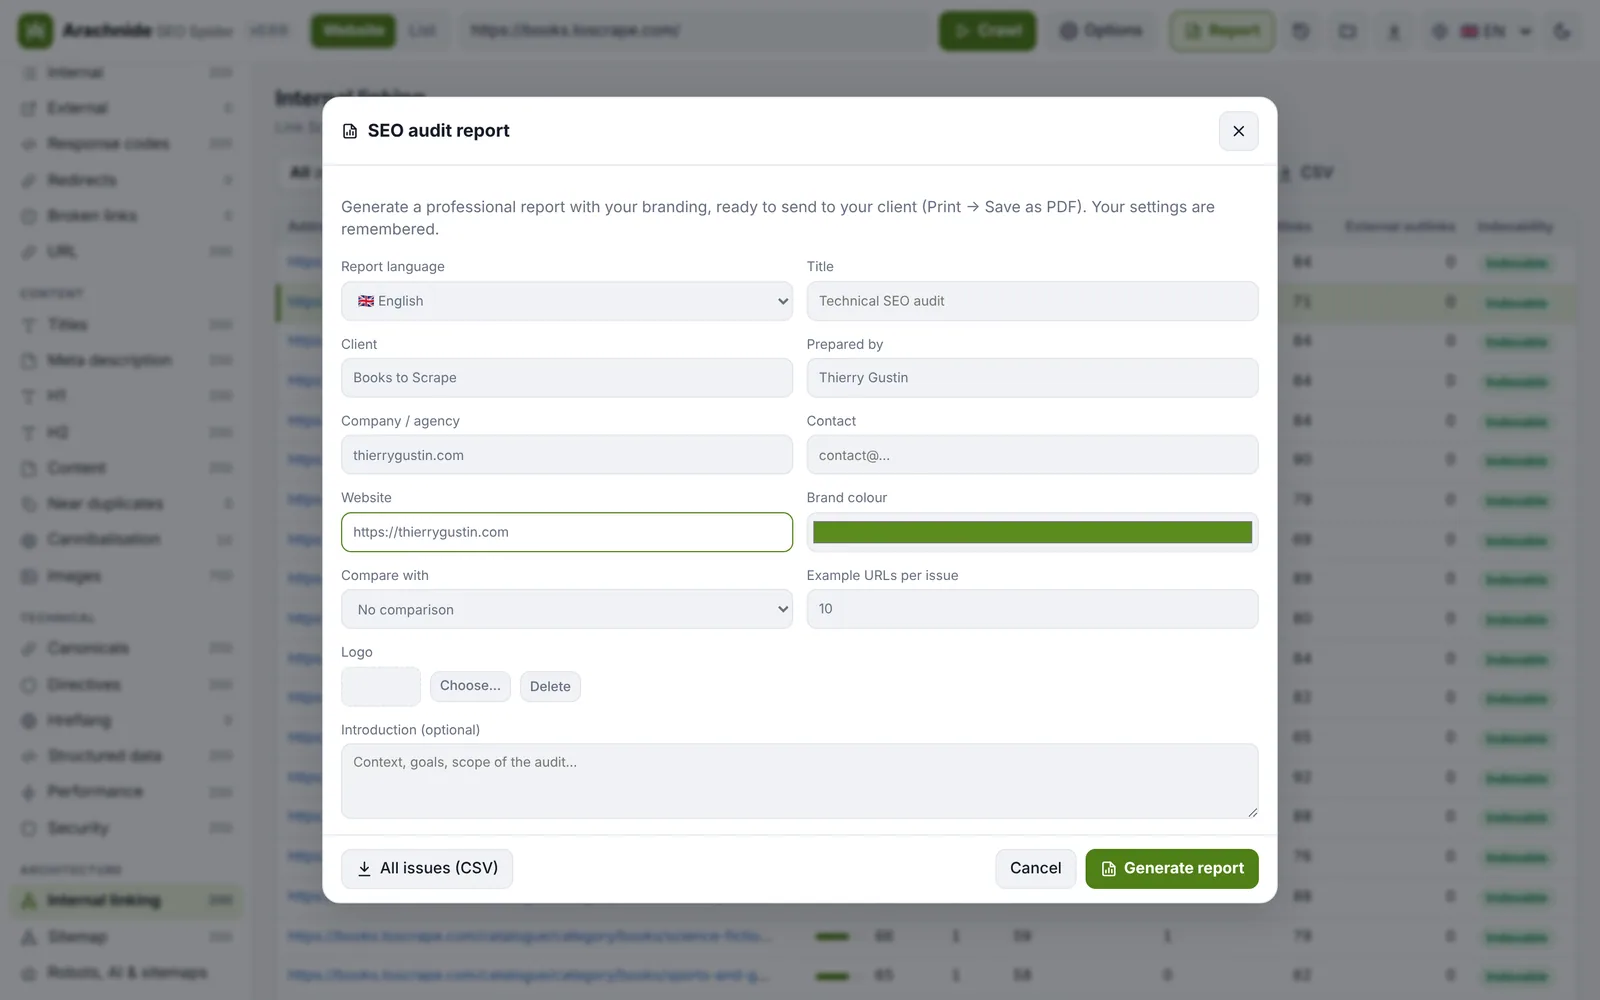
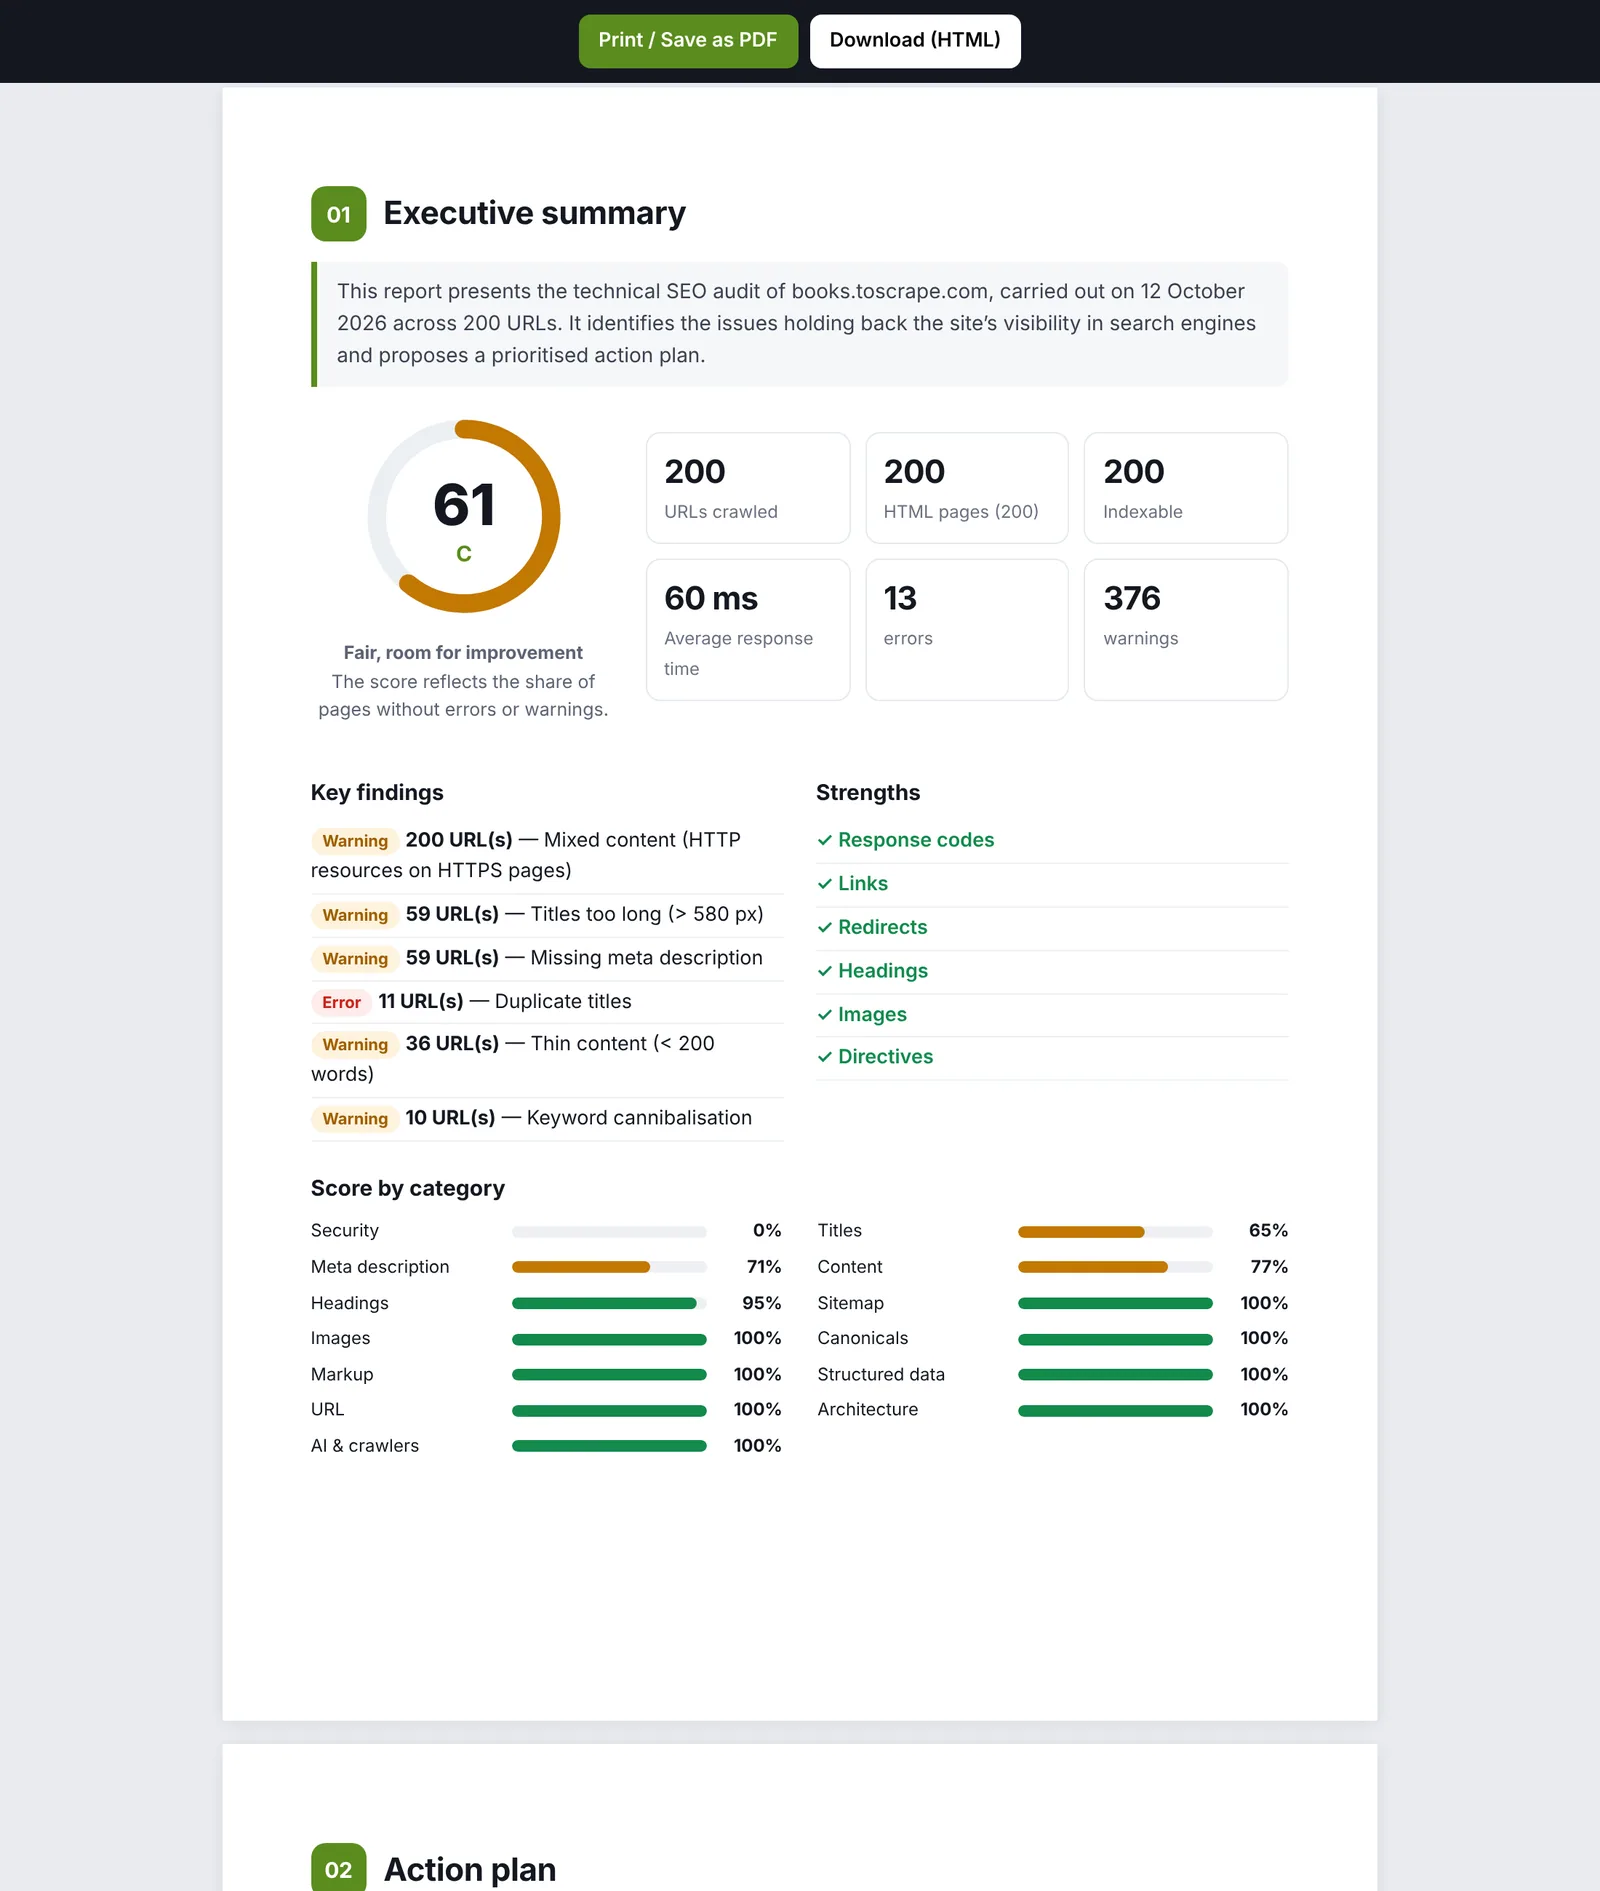
Ein White-Label-HTML-Bericht, der sich als PDF drucken lässt, in sechs Sprachen: Ihr Logo, Ihre Farbe, Kundenname und Kontaktdaten, eine Zusammenfassung für die Geschäftsführung, die wichtigsten Erkenntnisse, Scores nach Kategorie, ein Maßnahmenplan in drei Prioritätsstufen, eine detaillierte Analyse mit Beispiel-URLs und die Methodik.
- Vergleich mit einem früheren Crawl derselben Website: Entwicklung des Scores, behobene, neue oder verschlechterte Probleme, URL für URL.
- Ergebnisse je Segment, wenn Segmente definiert sind; ein Bericht für ein einzelnes Segment nennt es auf dem Deckblatt.
- CSV aller Probleme und aller Seiten für Ihren Kunden oder Entwickler.
KI-Agenten und GEO
Seit 3.13 ist Arachnide dafür gebaut, von einem KI-Agenten gesteuert zu werden: von Ihrem eigenen oder von jedem Assistenten, der MCP (Claude) oder OpenAPI (ChatGPT Actions, LangChain, n8n, Make) spricht. Drei Zugänge, ein Satz von 25 Tools, nur einmal definiert.
- MCP über stdio (Claude Desktop, Claude Code), MCP über HTTP (benutzerdefinierte Connectors in claude.ai, gehostete Agenten, Claude Agent SDK) und REST + OpenAPI 3.1, mit einem Klick als ChatGPT Action importierbar.
- GEO-Readiness-Score von 100: Zugriff für KI-Crawler (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended…), llms.txt, Abdeckung strukturierter Daten, Inhaltstiefe, Hygiene.
- Zugriffstoken beim ersten Start erstellt, 240 Anfragen pro Minute und IP, Protokoll der letzten Aufrufe in der App, Schreib-Tools als folgenreich markiert.
Benutzerdefinierte Extraktion und Suche
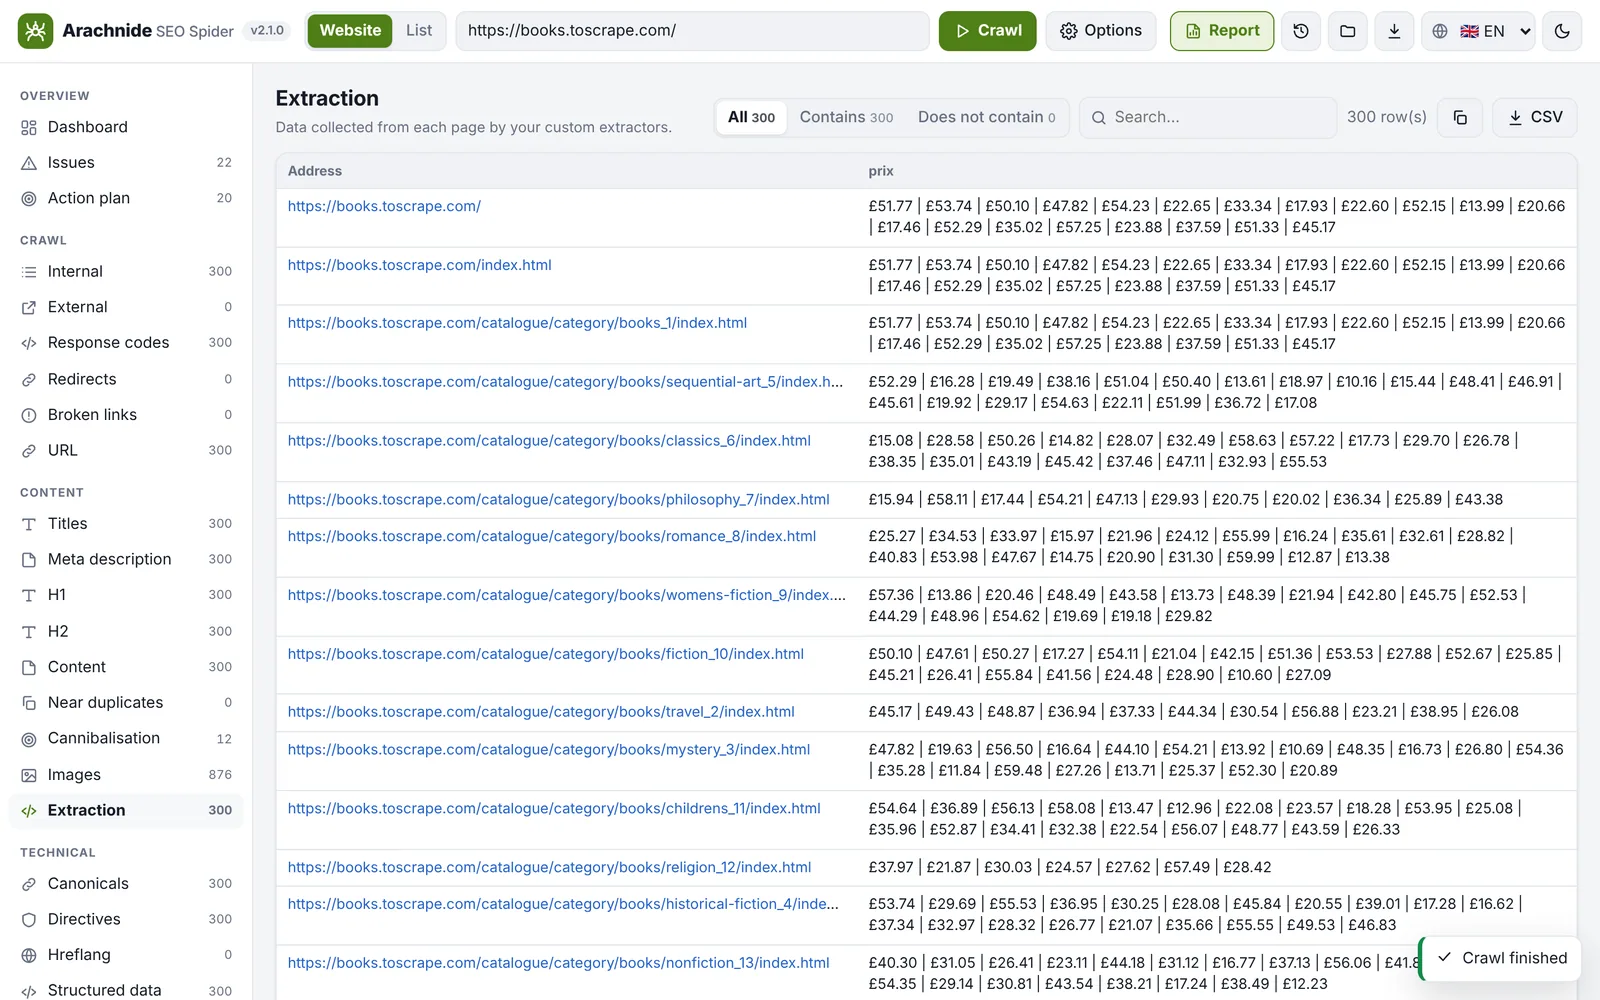
Erfassen Sie beliebige Daten aus jeder Seite: Preis, Autor, Datum, Artikelnummer, Tracking-Code. Bis zu 20 Extraktoren per CSS-Selektor (Text, Attribut, HTML oder Anzahl), XPath (3.21) oder Regex, mit einem Tab Extraktion und einer Spalte pro Regel im CSV-Export.
- Benutzerdefinierte Suche: jede Seite, die einen Text oder eine Regex enthält, etwa eine alte Telefonnummer oder einen Tracking-Code.
- Extraktionen können Segmente steuern (extract:Preis), und die CLI akzeptiert dieselben Regeln mit --extract.
- Eine durchdrehende Regex wird nach 2 s in einem Worker abgebrochen, statt den Crawl einzufrieren.
Kommandozeile
Alles, was die Oberfläche kann, aus einem Terminal oder einem Cron-Job: node src/cli.mjs <url> [options]. Die CLI gibt Score und Probleme in Ihrer Sprache aus, speichert den Crawl als gezipptes NDJSON, das die Oberfläche öffnen kann, und exportiert CSV und den HTML-Bericht.
- JSON (NDJSON gzip), pages.csv und issues.csv, HTML-Bericht in Ihrem Branding, Vergleich mit einem früheren Crawl, Segmente, E-Mail-Benachrichtigungen für cron.
- --resume setzt einen unterbrochenen Crawl aus seinem Journal fort; --sitemap crawlt genau die URLs einer Sitemap; --extract fügt eine CSV-Spalte pro Regel hinzu.
- Dieselben Optionen wie in der Oberfläche: Limits, Geschwindigkeit, robots.txt-Modi, User-Agents, Authentifizierung, Einschließen / Ausschließen, Google-Daten.
Skalierung und Performance
Die Versionen 3.16 bis 3.21 bildeten ein Skalierungsprogramm in sechs Schritten: kompakter Linkgraph in Typed-Array-Spalten (14 Bytes pro Link), gezipptes NDJSON als Stream geschrieben, ein Fortsetzungsjournal, eine Analyse, die jede Seite auf Beinahe-Duplikate vergleicht, und ein Browser, der nie den ganzen Crawl erhält.
- Getestet auf einer lokalen synthetischen Site mit 200.000 Seiten und 19,9 Millionen Links mit npm run bench -- --pages 200000: Crawl und Analyse in 2.086 s (rund 96 Seiten pro Sekunde), gespeichert in 38 s in eine Datei von 62,5 MB, Spitzenspeicher 2,7 GB.
- Crawl-Leitplanken: Das Seitenbudget zählt heruntergeladene Seiten, Tracking-Parameter werden entfernt, Facetten-Fallen werden gemeldet, eine unerreichbare robots.txt verbietet alles, wie RFC 9309 verlangt.
- Das Standardbudget sind 500 Seiten: Heben Sie es unter Optionen → Limits für eine große Website an.