Crawl-Konfiguration
Jede Crawl-Option mit ihrem Standardwert - Limits, Geschwindigkeit, robots.txt, Rendering, Umfang, Extraktion, Authentifizierung, Listen- und Sitemap-Modus.
Klicken Sie auf Optionen (das Zahnrad), um das Fenster Konfiguration zu öffnen, das der Spider-Konfiguration eines Desktop-Crawlers nachempfunden ist. Ihre Einstellungen werden gespeichert, mit Ausnahme des HTTP-Passworts und der benutzerdefinierten Header, die oft ein Session-Cookie oder ein Token enthalten.
| Tab | Einstellungen |
|---|---|
| Spider | XML-Sitemaps lesen, Canonicals folgen, Subdomains einbeziehen, externe Links und Bilder prüfen |
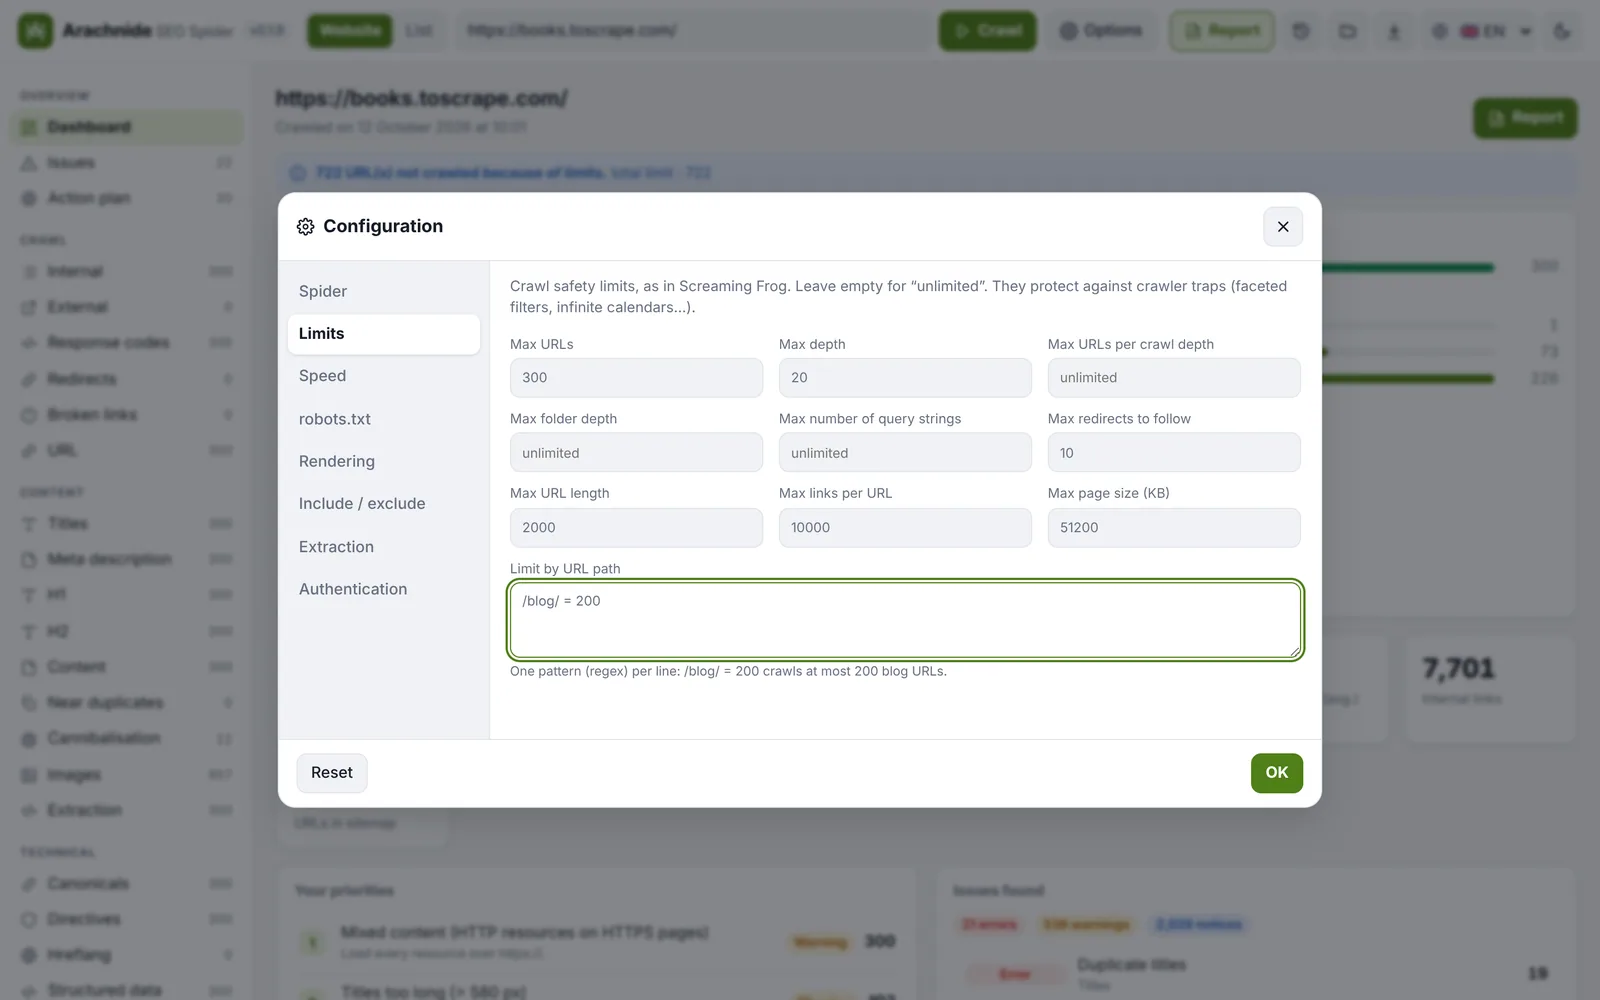
| Limits | Crawl-Gesamtzahl, Crawl-Tiefe, URLs pro Tiefe, Ordnertiefe, Query-Strings, zu folgende Weiterleitungen, URL-Länge, Links pro Seite, Seitengröße, Limits nach URL-Pfad (/blog/ = 200, eines pro Zeile) |
| Geschwindigkeit | Max. Threads, max. URLs pro Sekunde, Timeout |
| robots.txt | Beachten / ignorieren, aber Status melden / ignorieren, benutzerdefinierte robots.txt, URL-Tester |
| Rendering | JavaScript-Rendering, User-Agent (Arachnide, Googlebot Desktop/Smartphone, Chrome), Accept-Language |
| Einschließen / ausschließen | Regulärer Ausdruck zum Ein- und Ausschließen, URL-Parameter entfernen (utm_*, gclid), alle Parameter ignorieren, benutzerdefinierte Suche |
| Extraktion | Bis zu 20 Extraktoren: CSS-Selektor (Text, Attribut, HTML oder Anzahl) oder regulärer Ausdruck |
| Authentifizierung | HTTP-Benutzer und -Passwort, benutzerdefinierte Header (Cookies, Tokens) |
Spider
- XML-Sitemaps lesen (an): Die in der
robots.txtoder unter/sitemap.xmldeklarierten Sitemaps werden gelesen, einschließlich Sitemap-Indizes und.gz-Dateien, und ihre URLs werden eingereiht. Bild- und Video-Sitemaps werden übersprungen; es werden höchstens 500 Sitemap-Dateien gelesen. - Canonicals folgen (an): Ein Canonical, das auf eine nicht gecrawlte URL zeigt, reiht sie ein.
- Subdomains einschließen (aus):
blog.example.comgehört nur dann zuexample.com, wenn diese Option aktiv ist. Ein anderer Port ist nie die geprüfte Website. - Externe Links prüfen und Bilder prüfen (Größe, Status, Format) sind standardmäßig aus, damit Kunden-Crawls leicht bleiben.
Limits
| Einstellung | Standard | Hinweise |
|---|---|---|
Crawl-Gesamtzahl (maxPages) | 500 | Zählt tatsächlich heruntergeladene Seiten; von robots.txt blockierte URLs verbrauchen sie nicht. Bis zu 10 000 000. |
Crawl-Tiefe (maxDepth) | 20 | Weiterleitungen erhöhen die Tiefe nicht. |
URLs pro Tiefe, Ordnertiefe, Query-Strings, zu folgende Weiterleitungen (10), URL-Länge, Links pro Seite, Seitengröße (maxPageSizeKb) | — | Übersprungene URLs werden in der Übersicht je Grund gezählt. Antwortkörper werden als Stream gelesen und oberhalb des Größenlimits verworfen. |
| Limits nach URL-Pfad | — | Eines pro Zeile, z. B. /blog/ = 200. |
Geschwindigkeit
- Max. Threads (
concurrency): standardmäßig 5, 1 bis 30. Bleiben Sie auf einer Kunden-Website zwischen 2 und 5. - Max. URLs pro Sekunde (
maxUrlPerSec): eine globale Obergrenze, nützlich bei Shared Hosting. - Pause zwischen Anfragen pro Worker und Zeitlimit.
Antworten zur Ratenbegrenzung (429 und 503 mit Retry-After) werden beachtet und erneut versucht; 500, 502, 504 und Verbindungsfehler erhalten einen verzögerten Neuversuch am Ende der Warteschlange.
robots.txt
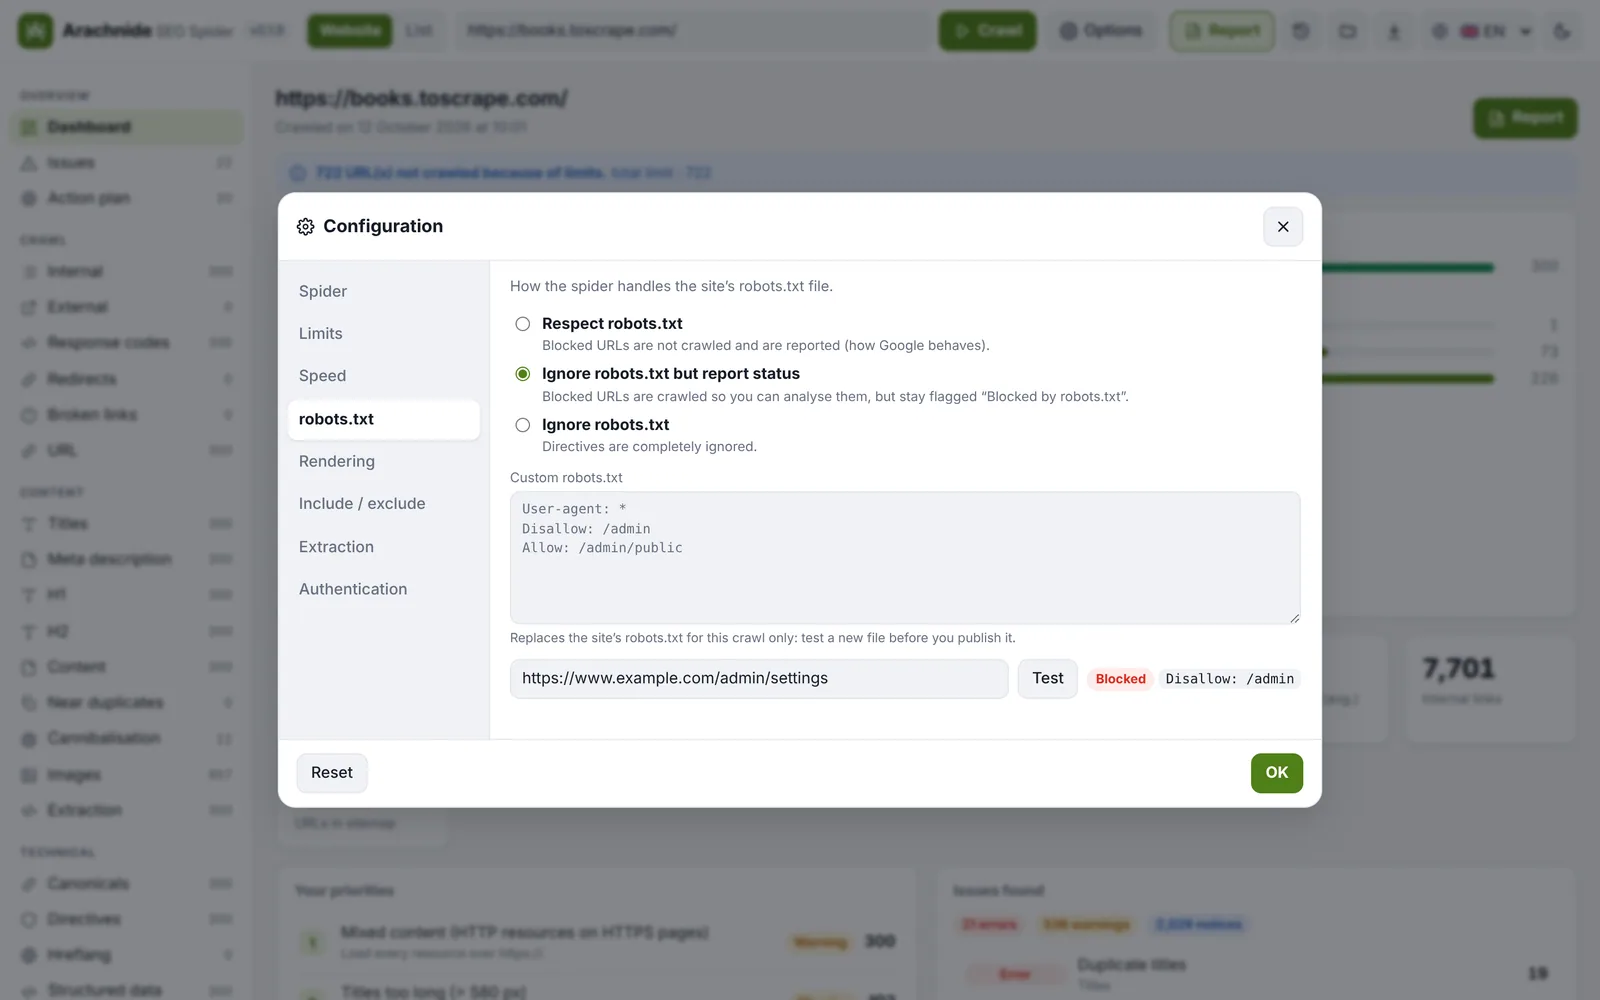
Drei Modi: beachten (Standard), ignorieren, aber melden (blockierte URLs werden gecrawlt und trotzdem markiert) und ignorieren. Sie können eine benutzerdefinierte robots.txt einfügen, um eine Datei vor der Veröffentlichung zu testen, und der integrierte Tester sagt, ob eine URL erlaubt ist und welche Regel greift. Arachnide folgt den Regeln von Google für die robots.txt (RFC 9309):
- eine robots.txt, die mit 4xx antwortet, bedeutet, dass alles erlaubt ist;
- eine robots.txt, die mit 5xx antwortet oder unerreichbar ist, bedeutet, dass alles verboten ist, mit einer ausdrücklichen Warnung. Zwei Auswege: die Option robots.txt nicht verfügbar → erlauben (
--robots-unavailable allow) oder der Modus melden / ignorieren; - im Listenmodus und mit Subdomains wird die robots.txt einmal pro Host gelesen.
Rendering
Das JavaScript-Rendering nutzt das bereits installierte Chrome, Edge, Chromium oder Brave (über puppeteer-core; es wird nichts heruntergeladen). Arachnide vergleicht das rohe HTML mit der gerenderten Seite (Inhalt, Links, Title, H1, Canonical, noindex), meldet JS-Fehler und JavaScript-Weiterleitungen und misst LCP und CLS im Labor. Chrome wird alle 500 gerenderten Seiten neu gestartet, um seinen Speicher zu begrenzen, und einmal neu gestartet, wenn es abstürzt.
User-Agent: Arachnide (Standard), Googlebot Desktop, Googlebot Smartphone, Chrome oder eine eigene Zeichenkette. Wie der Googlebot sendet Arachnide standardmäßig keinen Accept-Language-Header; Sie können einen festlegen. Wenn eine Website dem Arachnide-Agenten mit 403 antwortet, wechselt der Crawl automatisch zu Chrome und sagt es.
Einschließen / ausschließen
- Einschließen und Ausschließen: ein regulärer Ausdruck pro Zeile. Eine ungültige Zeile wird ignoriert und gemeldet. Die Start-URL wird immer gecrawlt.
- Im Startverzeichnis bleiben:
https://example.com/blog/crawlt nur/blog/…. - URL-Parameter entfernen wie
utm_*odergclid(Platzhalter erlaubt). Seit 3.21 werden Parameter nach Schlüssel sortiert und bekannte Tracking-Parameter (utm_*,gclid,fbclid,msclkid,mc_cid,srsltid,_ga…) standardmäßig entfernt, sodass?a=1&b=2und?b=2&a=1eine Seite sind; Parameter unverändert lassen stellt das rohe Verhalten wieder her. - Alle Parameter ignorieren und benutzerdefinierte Suche (ein Text oder eine
/regex/, die im Quellcode gesucht wird). - Ein Pfad, der 200 Parametervarianten erzeugt, wird einmal als Facetten-Falle gemeldet, das typische Muster kombinierbarer Filter, die das Budget auffressen.
Extraktion
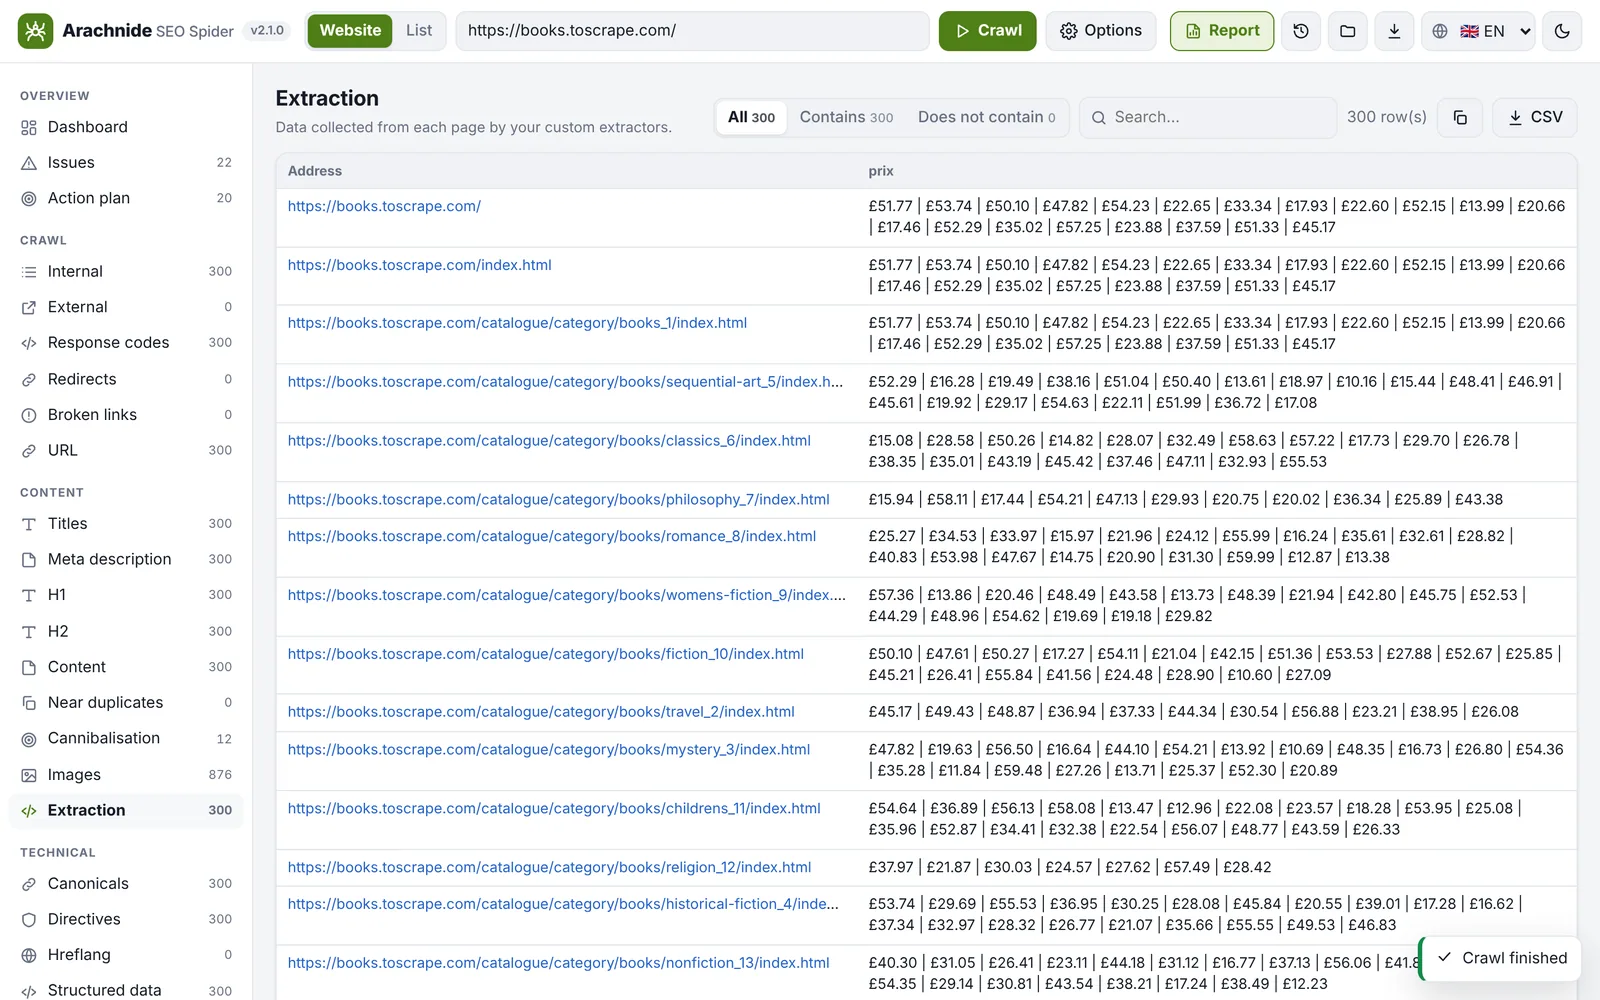
Bis zu 20 Extraktoren, jeder mit einem Namen und einer Regel:
- CSS-Selektor mit einem Ziel: Text, Attribut, inneres HTML oder Anzahl;
- XPath (3.21): im Rendering-Modus in Chrome ausgewertet, oder auf dem rohen HTML über
jsdom, eine optionale Abhängigkeit, die nur geladen wird, wenn eine XPath-Regel existiert (npm install jsdom, wenn Sie die Warnung sehen); - Regex, in einem Worker mit einem Zeitlimit von 2 Sekunden ausgeführt: Ein katastrophales Muster wird für diese Seite abgebrochen, und der Crawl läuft weiter.
Die Werte erscheinen im Tab Extraktion, in einer Spalte pro Regel in pages.csv, und können Segmente über das Feld extract:<name> steuern. Die CLI akzeptiert dieselben Regeln mit --extract (siehe Kommandozeile).
Authentifizierung
HTTP-Authentifizierung (Benutzer und Passwort) und benutzerdefinierte Header (Cookies, Tokens) für Staging-Websites. Sie werden nur an die geprüfte Website gesendet, auch im Rendering-Modus, und nie gespeichert.
Website-, Listen- und Sitemap-Modus
Der Umschalter neben dem Adressfeld wählt zwischen dem Crawlen einer Website (Links werden verfolgt) und einer Liste von URLs, die Sie einfügen (bis zu 500 000 URLs seit 3.21; Links werden nicht verfolgt, die interne Verlinkung ist nicht gemessen). Die CLI ergänzt --list urls.txt und --sitemap URL, das genau die URLs einer Sitemap oder eines Sitemap-Index crawlt, dedupliziert und normalisiert. KI-Agenten erhalten dieselben Modi über mode, urls und sitemap_url auf den Crawl-Tools.
Einen unterbrochenen Crawl fortsetzen
Während eines Crawls schreibt Arachnide ein Fortsetzungsjournal (crawls/.en-cours/<id>.ndjson): jede eingereihte URL, jede verarbeitete Seite. Nach einem Absturz oder einem Stopp wird das Journal auf dem Startbildschirm aufgeführt, und der Crawl kann dort fortgesetzt werden, wo er stand, wobei nur die letzten Sekunden verloren gehen. Das Journal wird gelöscht, wenn der Crawl abgeschlossen ist. In der CLI: --resume DATEI, oder --no-journal, um nichts zu schreiben.