Funcionalidades
Todo está en la versión 3.21.0, gratuita, sin ninguna funcionalidad de pago. Cada sección enlaza a su página de documentación.
Auditoría y puntuación de salud
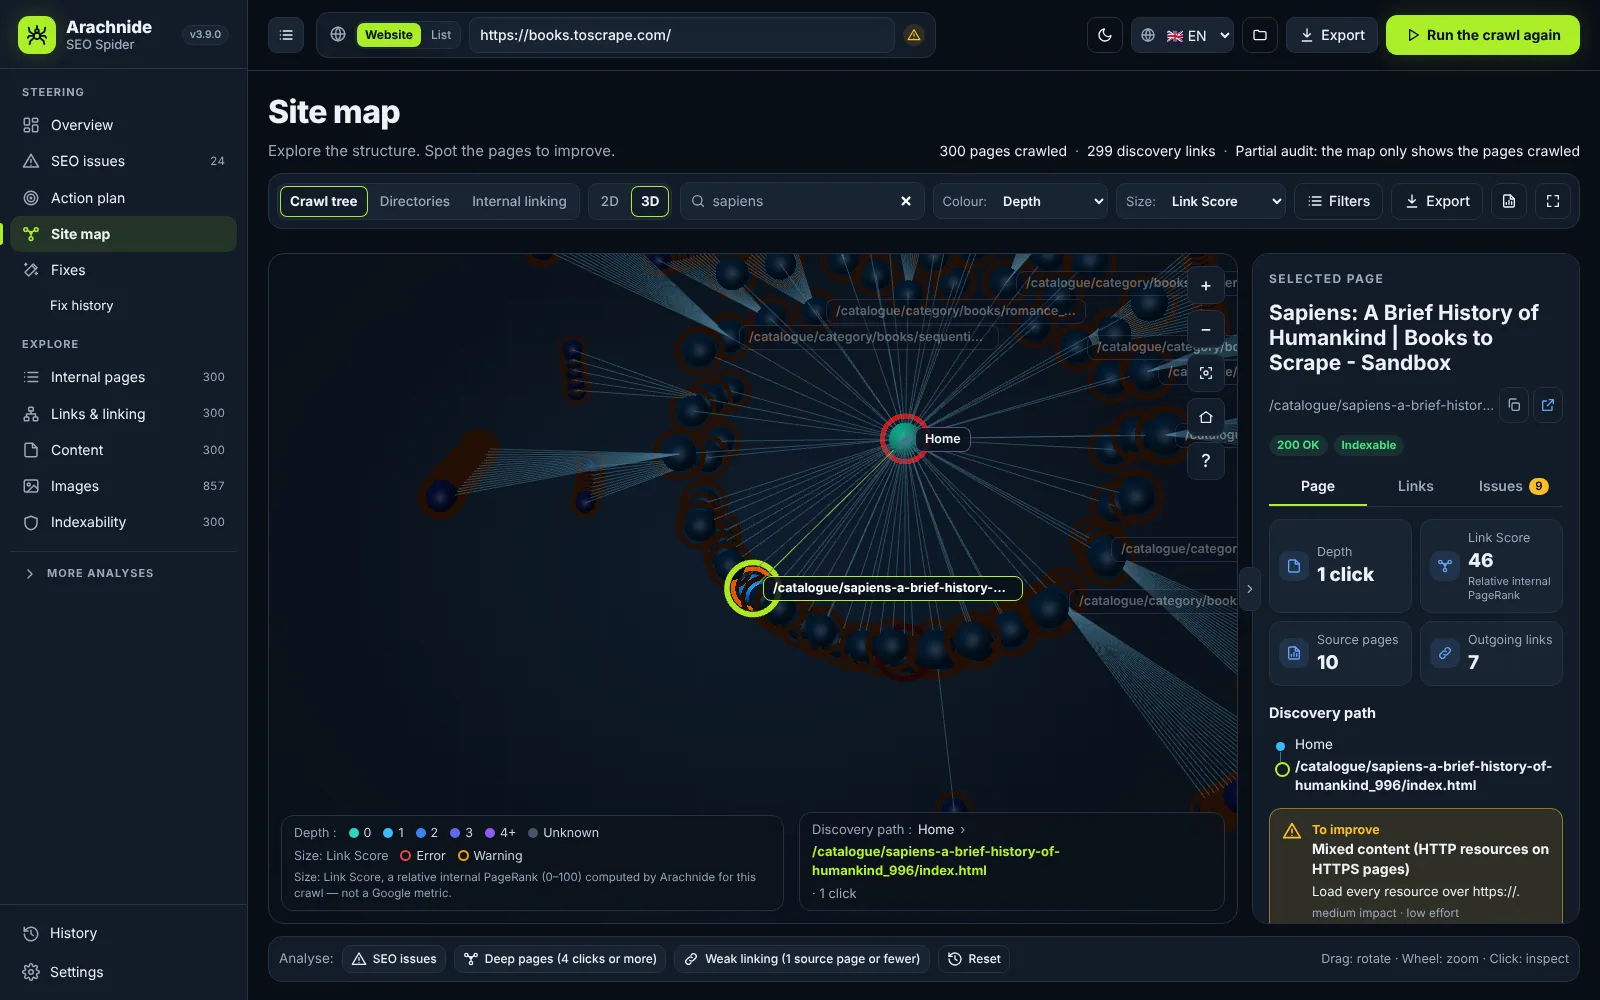
Un rastreo te da una puntuación de salud sobre 100 con nota A–F, cuatro puntuaciones por pilar (técnico, contenido, enlazado interno, rendimiento), tus prioridades contadas en páginas únicas, indicadores clave, lo que funciona bien y tu próximo objetivo. Un pilar sin datos se muestra como «No medido», nunca como una buena puntuación.
- Unas 95 comprobaciones en 14 familias: códigos de respuesta, redirecciones, títulos y metas, encabezados, contenido, imágenes, indexación, arquitectura, sitemaps, internacional, datos estructurados, JavaScript, rendimiento y seguridad, URL, IA y GEO.
- Link Score (PageRank interno), profundidad de clics, páginas huérfanas, casi duplicados (simhash), canibalización de palabras clave, ancho de títulos y descripciones en píxeles con vista previa del SERP de Google.
- Renderizado JavaScript con el Chrome o Edge ya instalado: HTML bruto frente a HTML renderizado, errores JS, LCP y CLS.
Problemas SEO y plan de acción
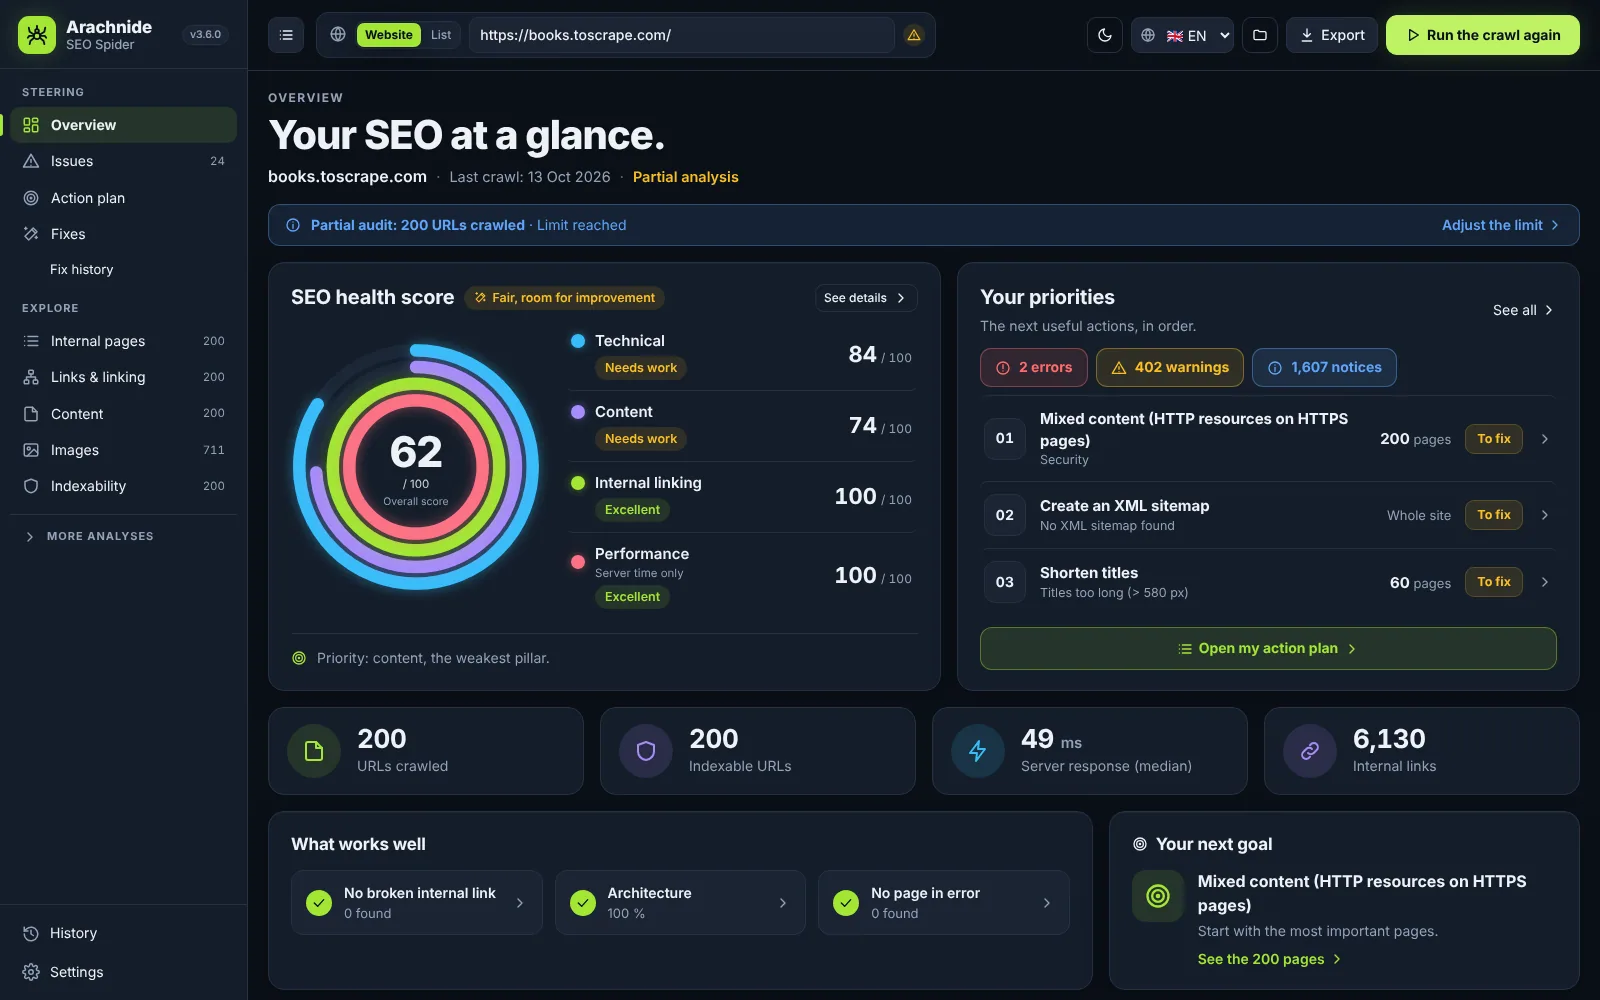
La página de problemas muestra qué se ha encontrado, su gravedad, cuántas URL únicas afecta y el esfuerzo que requiere, con un panel de corrección: por qué importa, pasos numerados, un ejemplo antes / después tomado de una página real y la lista de URL para exportar.
- Prioridad recomendada: primero los errores, luego las advertencias y después los avisos, ordenados por gravedad × impacto × URL ÷ esfuerzo.
- El plan de acción convierte cada problema en una acción con un verbo, un rango, un criterio «terminado cuando», un estado (por hacer, en curso, por validar) y notas guardadas en tu navegador por sitio.
- Solo un nuevo rastreo que ya no detecta el problema lo marca como resuelto.
Corregir en 1 clic y conectores
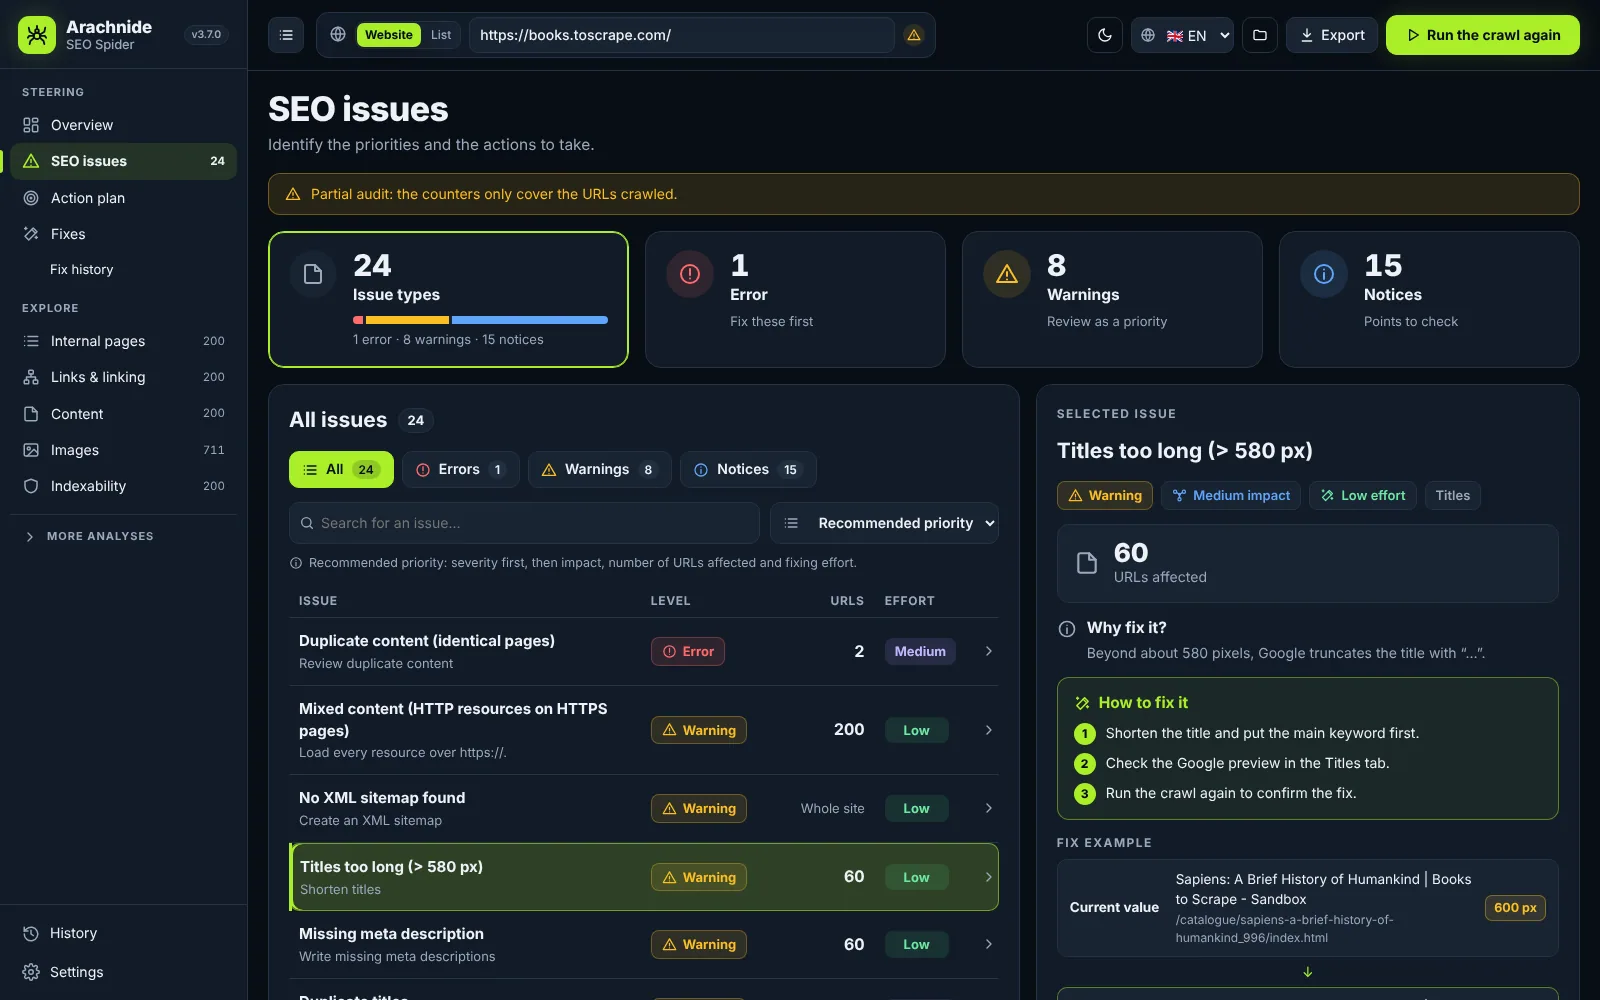
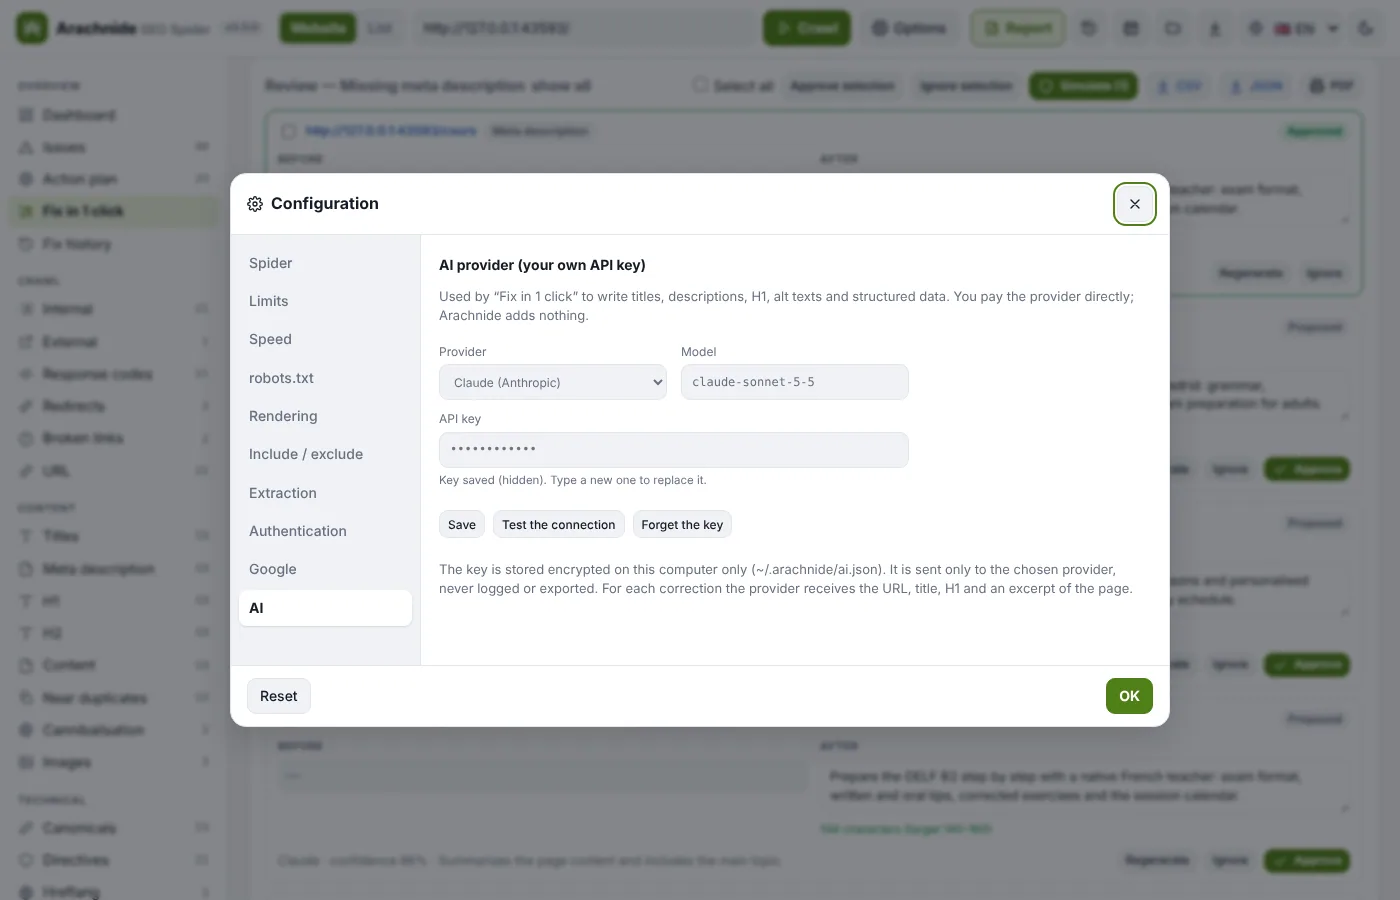
Desde la 3.5, Claude (Anthropic) o ChatGPT (OpenAI) redactan titles, meta descriptions, H1, textos alternativos de imágenes y JSON-LD a partir del contenido real de cada página, con tu propia clave API. Las redirecciones 301, las canonicals, los noindex accidentales y los enlaces a redirecciones se calculan sin IA. Revisas, validas, y un conector aplica el cambio.
- Conectores: WordPress (plugin complementario), Drupal, Joomla, PrestaShop, Shopify, Webflow, Wix, archivos (HTML estático más _redirects, .htaccess, nginx o vercel.json), Cloudflare Worker, pull request de GitHub y un modo manual con la ruta de clics exacta.
- Detección automática del CMS, modo simulación activado por defecto, política por sitio (campos permitidos, tamaño de lote, solo lectura), historial y deshacer de una corrección o de un lote entero, PDF de «correcciones aplicadas».
- Las claves y credenciales se guardan cifradas en tu ordenador y solo se envían al proveedor o al CMS correspondiente.
Cartografía en 2D y 3D
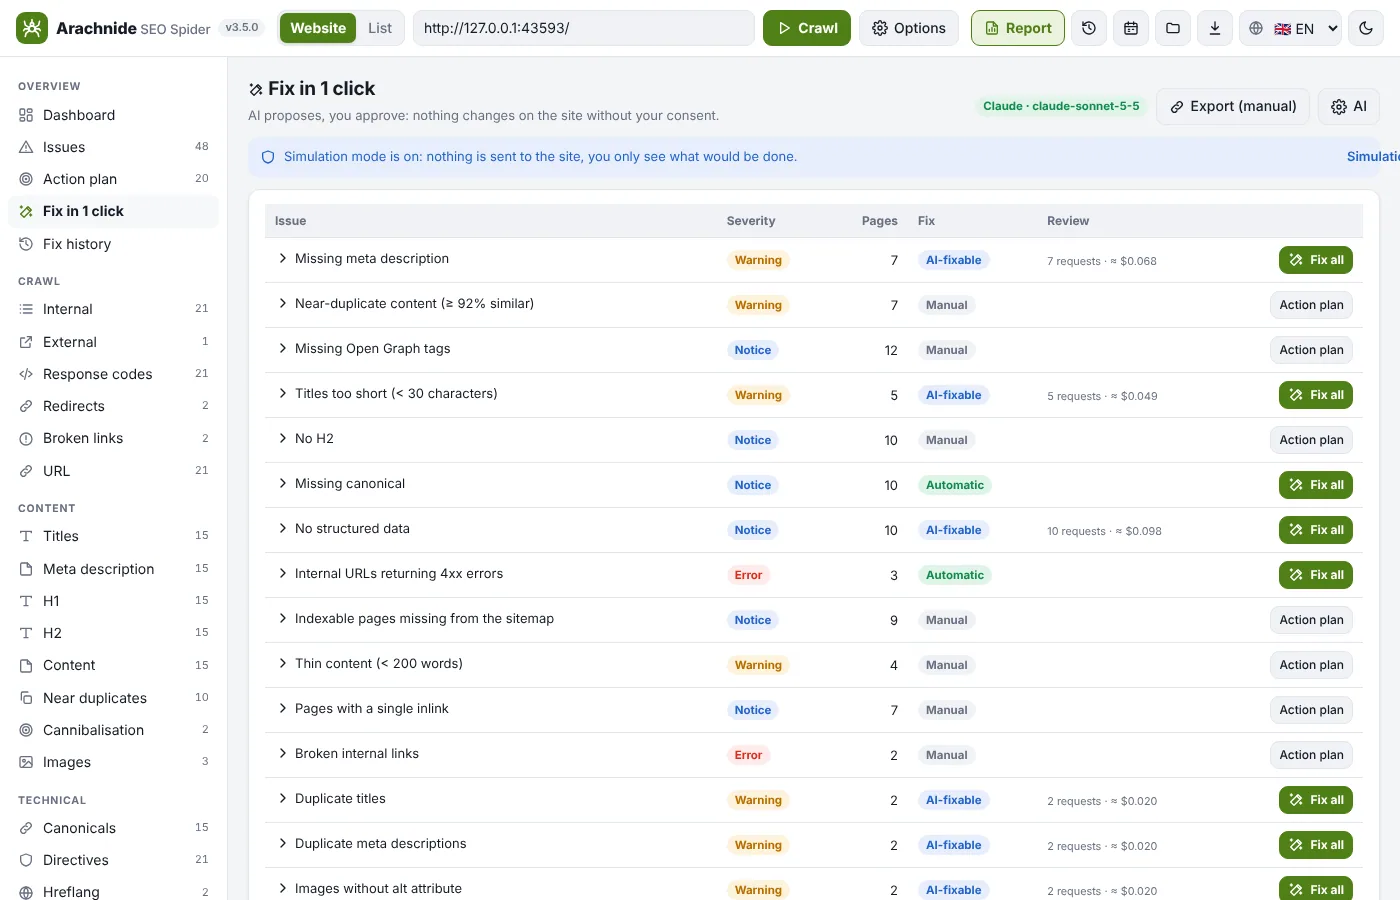
Dos vistas complementarias comparten los mismos datos, filtros, búsqueda e inspector de página. La cartografía es el árbol horizontal clásico al estilo Screaming Frog sobre fondo blanco, pensado para capturas e informes de clientes. La visualización 2D / 3D es la vista de exploración: estilo oscuro, disposición radial, coloreada por problemas SEO por defecto.
- Tres representaciones: árbol de rastreo (ruta de clics más corta desde la página de inicio), directorios (estructura de las URL) y enlazado interno (los enlaces dirigidos reales).
- Filtros por carpeta, patrones de URL (texto, comodín o regex), problemas, profundidad, estado, indexabilidad, enlazado entrante débil, rango de Link Score; resaltar o aislar.
- Inspector de página con estado, profundidad, Link Score, páginas fuente, ruta de descubrimiento y problemas; exportaciones PNG y PDF con encabezado, leyenda y contexto.
Segmentos
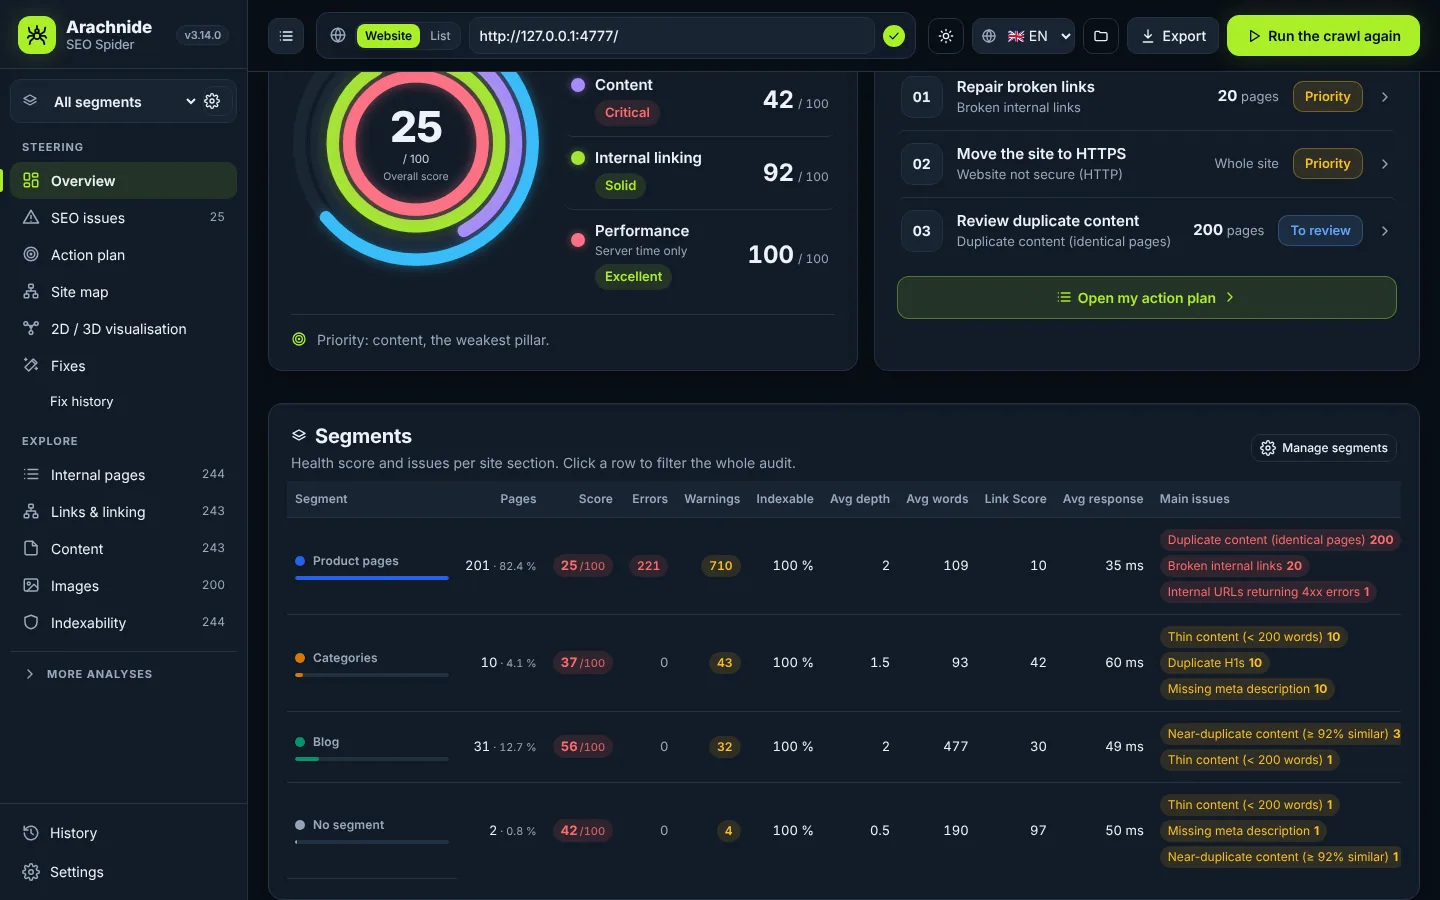
En un sitio grande, una puntuación global esconde dónde están realmente los problemas. Los segmentos (3.14) dividen la auditoría en secciones con nombre, igual que los segmentos de Screaming Frog: fichas de producto, categorías, blog, un idioma, páginas sin tráfico.
- Reglas sobre 20 campos (ruta, URL, title, H1, estado, indexabilidad, profundidad, palabras, enlaces entrantes, Link Score, tiempo de respuesta, tipo de datos estructurados, idioma, clics de Search Console, sesiones GA4, extracciones personalizadas) con operadores de texto, número y booleanos, combinados en Y / O.
- Gana el primer segmento que coincide; «Crear desde los directorios» construye un segmento por carpeta de primer nivel en un clic.
- Se aplican después del rastreo sin volver a rastrear; un filtro global recalcula el panel, la puntuación, los problemas, el plan de acción, las tablas, las exportaciones CSV y el informe PDF para esa sección.
Datos de Google
Conecta los datos de Google que un rastreador no puede ver: PageSpeed Insights y Core Web Vitals de usuarios reales de Chrome (CrUX), clics, impresiones, CTR y posición de Search Console por URL, y sesiones de Google Analytics 4.
- Search Console mediante una cuenta de servicio de solo lectura o importando un CSV; Google Analytics 4 por API o CSV (3.15).
- Encuentra las páginas que Google ve pero que tus enlaces no alcanzan, las páginas huérfanas que todavía reciben tráfico, las páginas con CTR bajo y las páginas no indexables con tráfico.
- Rastreos programados (diarios, semanales, mensuales) con alertas por correo electrónico cuando baja la puntuación o aparecen errores, comparados con el rastreo anterior, con el informe completo adjunto.
Informes para clientes
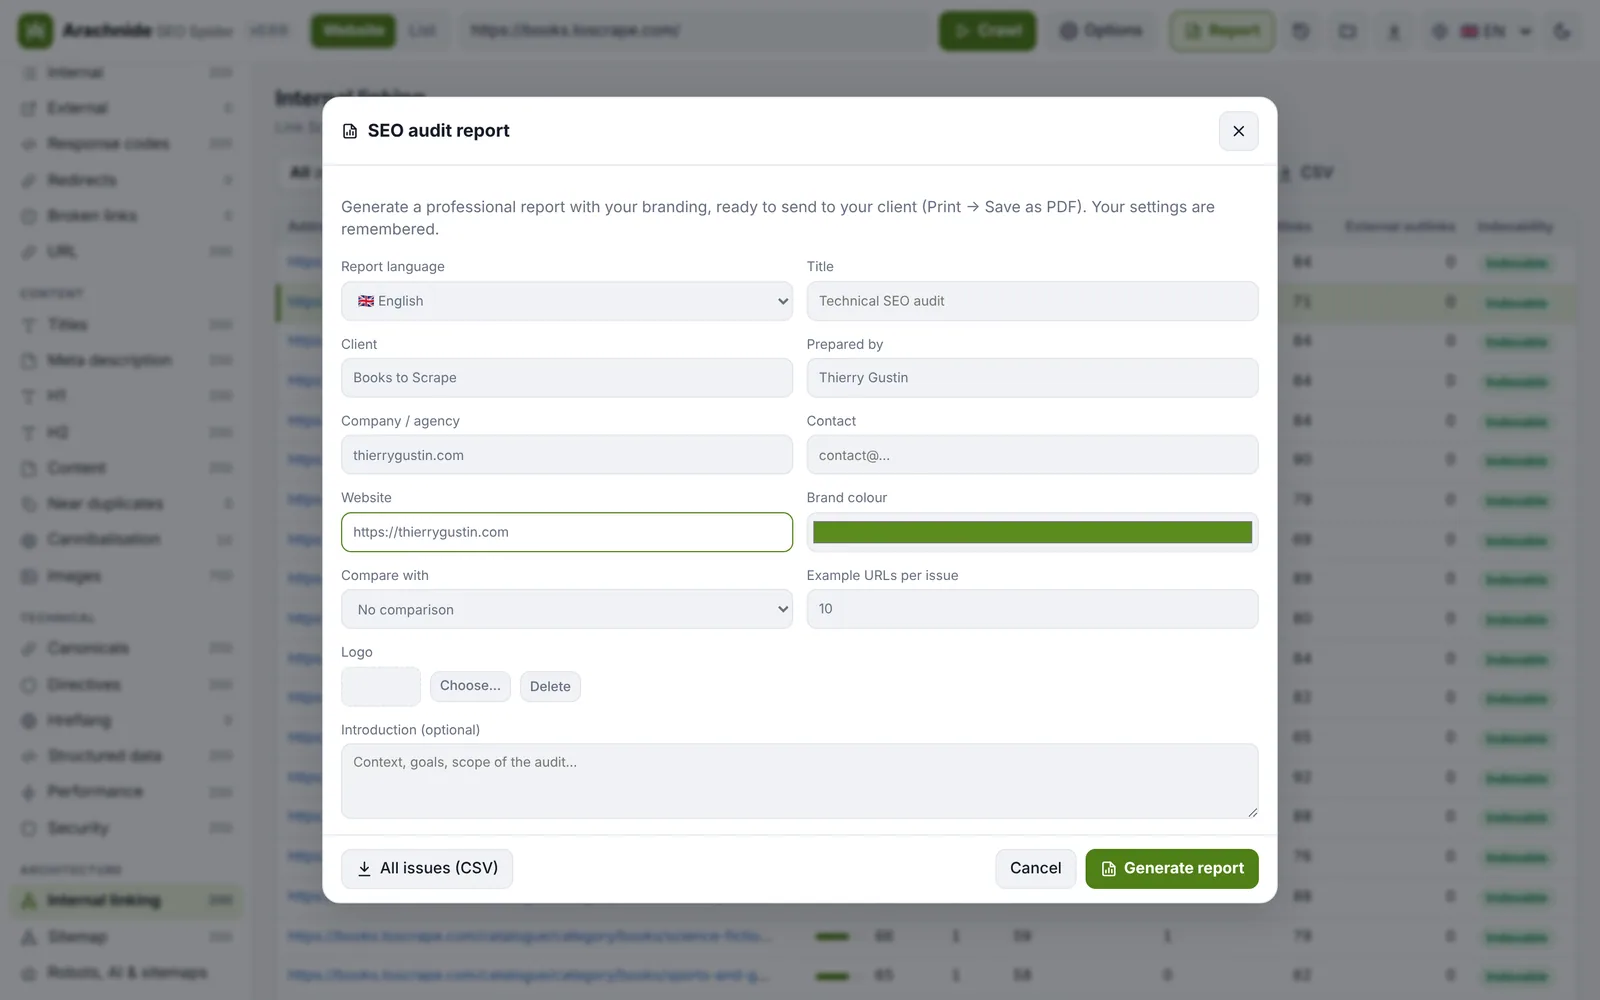
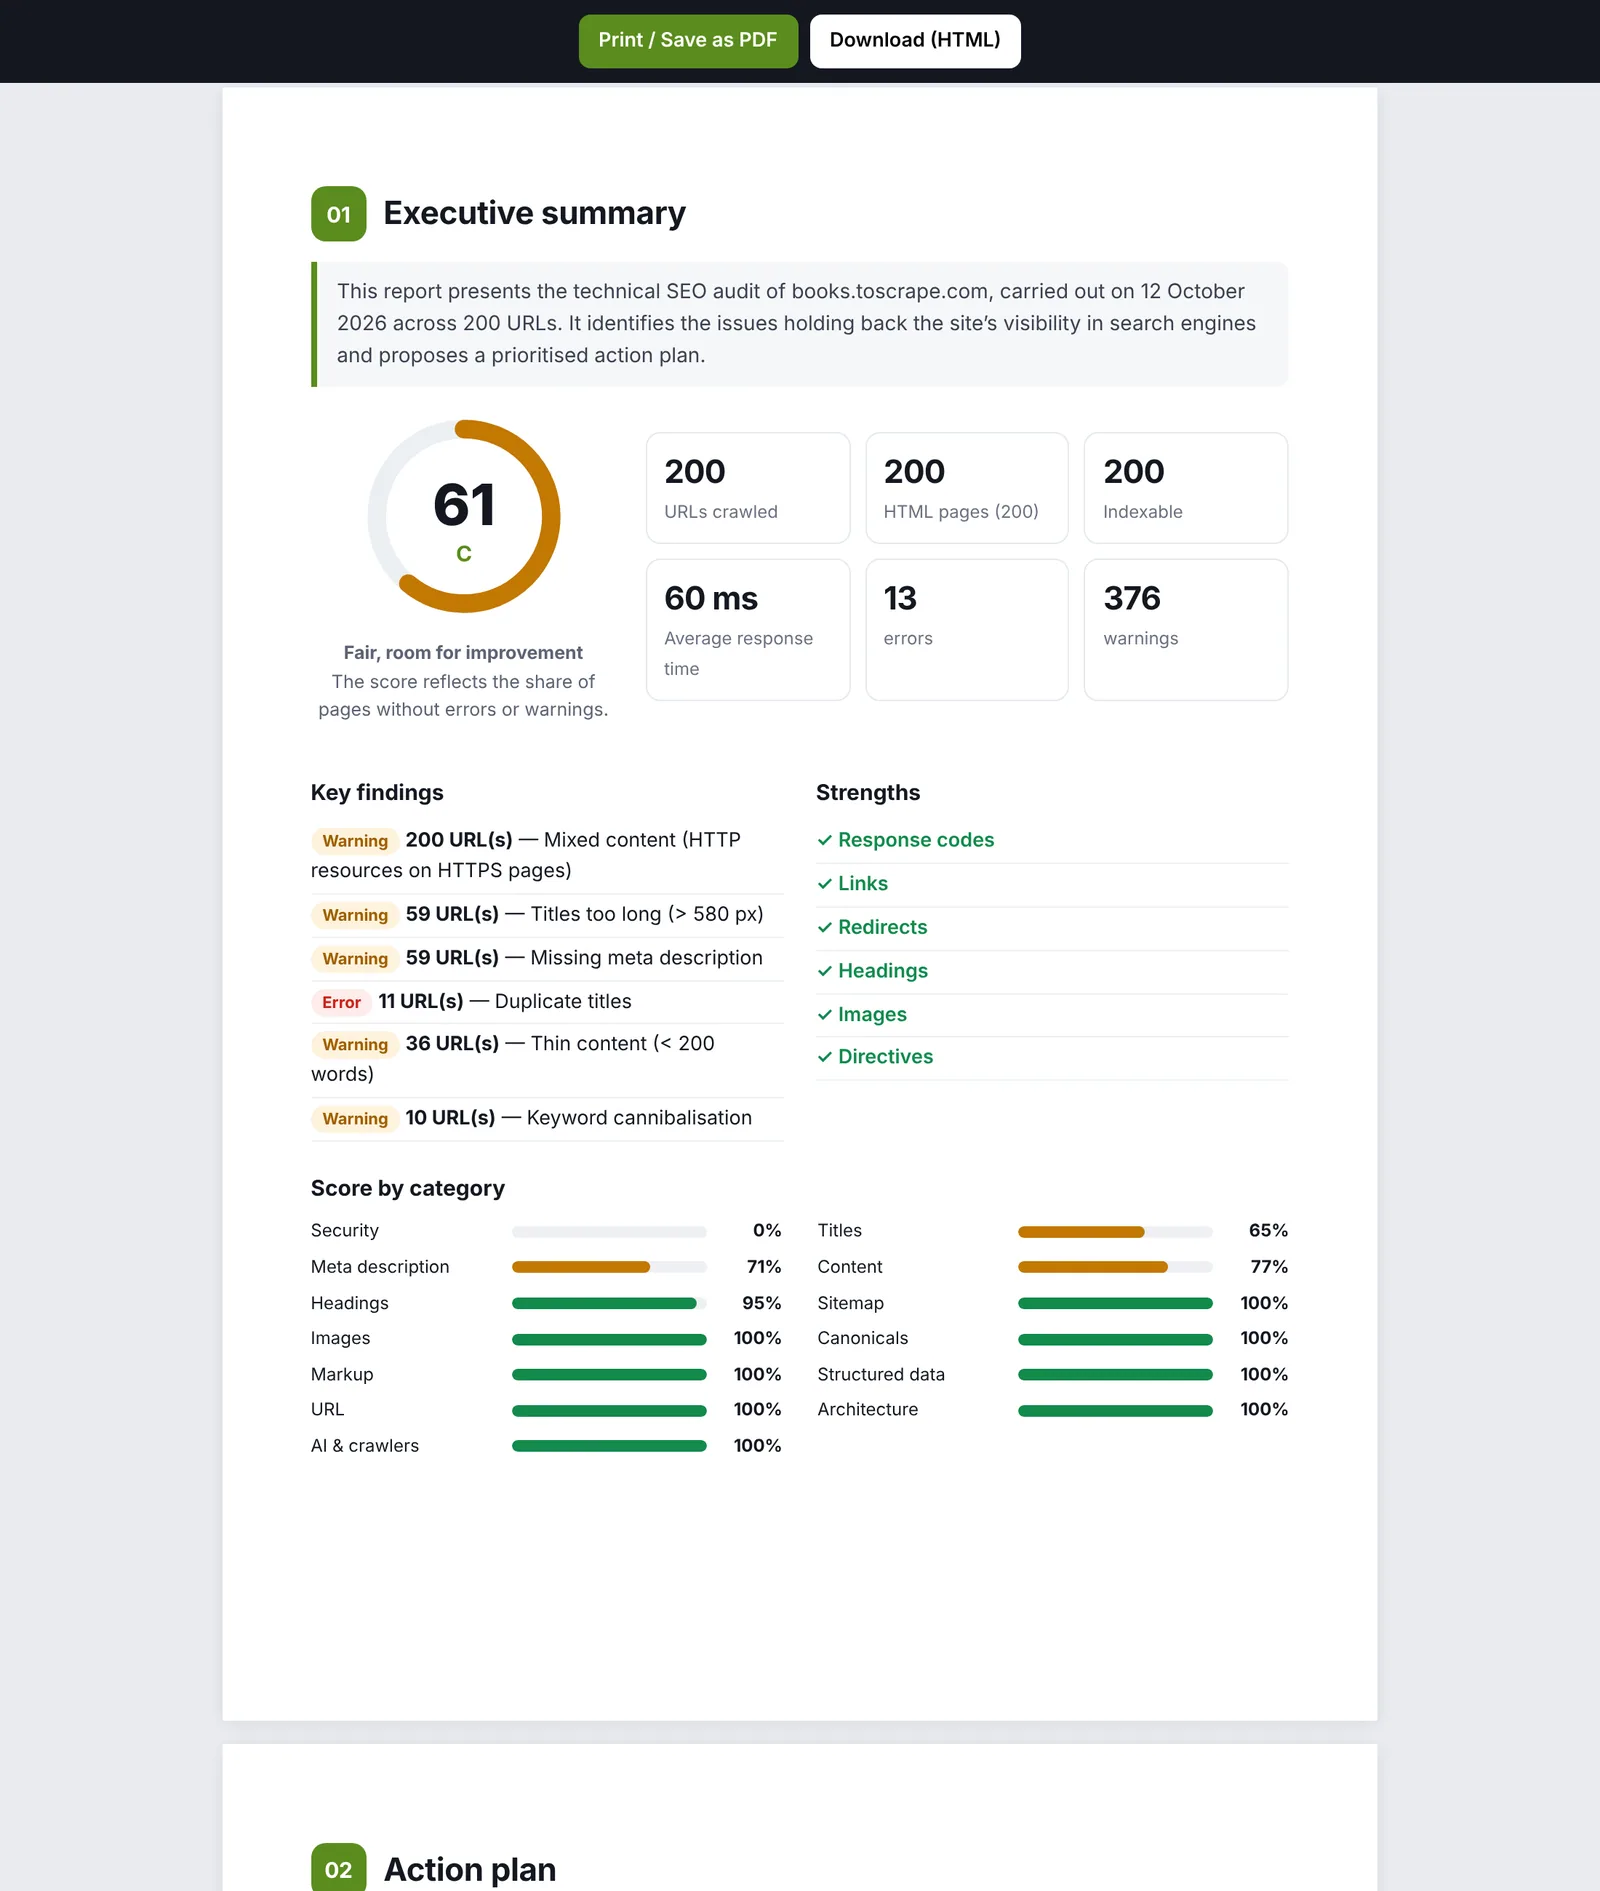
Un informe HTML de marca blanca que se imprime en PDF, en seis idiomas: tu logotipo, tu color, el nombre del cliente y tus datos de contacto, un resumen ejecutivo, las conclusiones clave, las puntuaciones por categoría, un plan de acción en tres niveles de prioridad, un análisis detallado con URL de ejemplo y la metodología.
- Comparación con un rastreo anterior del mismo sitio: evolución de la puntuación, problemas resueltos, nuevos o empeorados, URL por URL.
- Resultados por segmento cuando hay segmentos definidos; un informe de un solo segmento lo nombra en la portada.
- CSV de todos los problemas y de todas las páginas para tu cliente o tu desarrollador.
Agentes de IA y GEO
Desde la 3.13, Arachnide está diseñado para que lo dirija un agente de IA: el tuyo, o cualquier asistente que hable MCP (Claude) u OpenAPI (Actions de ChatGPT, LangChain, n8n, Make). Tres vías, un solo conjunto de 25 herramientas definidas una vez.
- MCP por stdio (Claude Desktop, Claude Code), MCP por HTTP (conectores personalizados de claude.ai, agentes alojados, Claude Agent SDK) y REST + OpenAPI 3.1 importable como Action de ChatGPT en un clic.
- Puntuación de preparación GEO sobre 100: acceso de los rastreadores de IA (GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended…), llms.txt, cobertura de datos estructurados, profundidad del contenido, higiene.
- Token de acceso creado en el primer arranque, 240 peticiones por minuto y por IP, registro de las últimas llamadas en la aplicación, herramientas de escritura marcadas como consecuentes.
Extracción personalizada y búsqueda
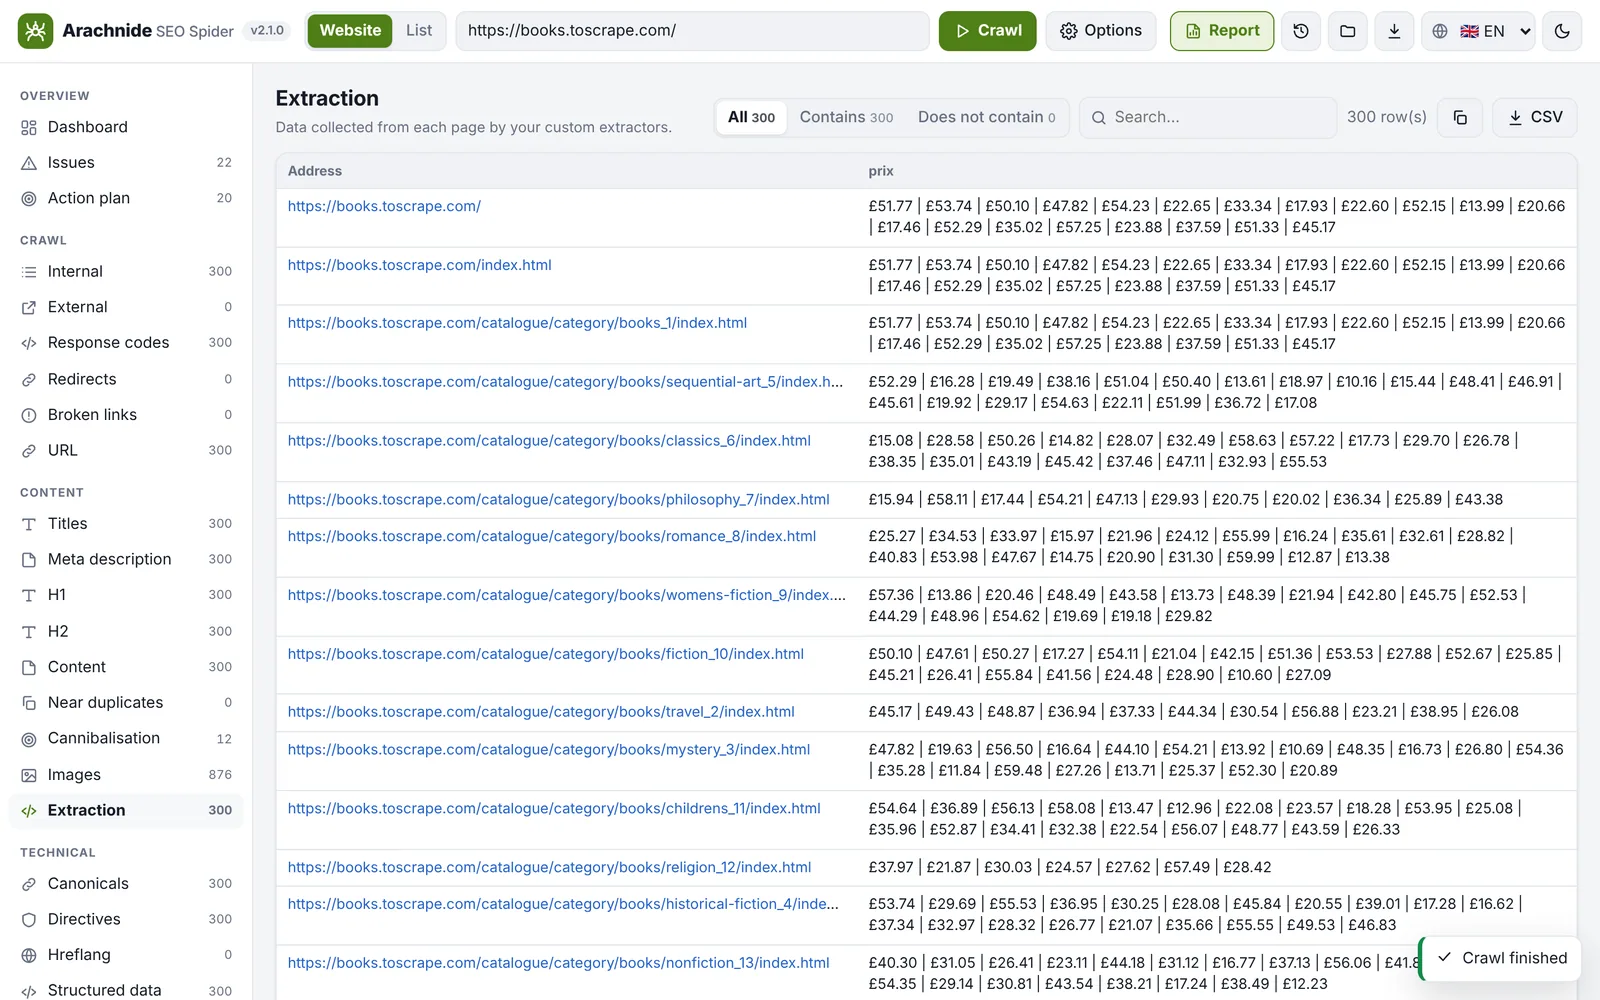
Recoge cualquier dato de cada página: precio, autor, fecha, SKU, código de seguimiento. Hasta 20 extractores por selector CSS (texto, atributo, HTML o número), XPath (3.21) o regex, con una pestaña Extracción y una columna por regla en la exportación CSV.
- Búsqueda personalizada: todas las páginas que contienen un texto o una regex, como un número de teléfono antiguo o un código de seguimiento.
- Las extracciones pueden alimentar segmentos (extract:Precio) y la CLI acepta las mismas reglas con --extract.
- Una regex desbocada se interrumpe en un worker al cabo de 2 s en lugar de bloquear el rastreo.
Línea de comandos
Todo lo que hace la interfaz, desde un terminal o una tarea cron: node src/cli.mjs <url> [options]. La CLI muestra la puntuación y los problemas en tu idioma, guarda el rastreo en NDJSON gzip que la interfaz puede abrir, y exporta el CSV y el informe HTML.
- JSON (NDJSON gzip), pages.csv e issues.csv, informe HTML con tu marca, comparación con un rastreo anterior, segmentos, alertas por correo electrónico para cron.
- --resume retoma un rastreo interrumpido desde su diario; --sitemap rastrea exactamente las URL de un sitemap; --extract añade una columna CSV por regla.
- Las mismas opciones que la interfaz: límites, velocidad, modos de robots.txt, user-agents, autenticación, incluir / excluir, datos de Google.
Escala y rendimiento
Las versiones 3.16 a 3.21 fueron un programa de escalado en seis pasos: grafo de enlaces compacto en columnas de arrays tipados (14 bytes por enlace), NDJSON gzip escrito en flujo, un diario de reanudación, un análisis que compara todas las páginas en busca de casi duplicados y un navegador que nunca recibe el rastreo entero.
- Probado en un sitio sintético local de 200.000 páginas y 19,9 millones de enlaces con npm run bench -- --pages 200000: rastreo y análisis en 2086 s (unas 96 páginas por segundo), guardado en 38 s en un archivo de 62,5 MB, memoria máxima 2,7 GB.
- Salvaguardas de rastreo: el presupuesto de páginas cuenta las páginas descargadas, los parámetros de seguimiento se eliminan, las trampas de facetas se señalan, un robots.txt inaccesible lo prohíbe todo como exige la RFC 9309.
- El presupuesto por defecto es de 500 páginas: auméntalo en Opciones → Límites para un sitio grande.