Configuración del rastreo
Todas las opciones de rastreo con su valor por defecto - límites, velocidad, robots.txt, renderizado, alcance, extracción, autenticación, modos lista y sitemap.
Haz clic en Opciones (el engranaje) para abrir la ventana Configuración, inspirada en la configuración del spider de un rastreador de escritorio. Tus ajustes se recuerdan, excepto la contraseña HTTP y las cabeceras personalizadas, que a menudo contienen una cookie de sesión o un token.
| Pestaña | Ajustes |
|---|---|
| Spider | Leer sitemaps XML, seguir canonicals, incluir subdominios, comprobar enlaces externos e imágenes |
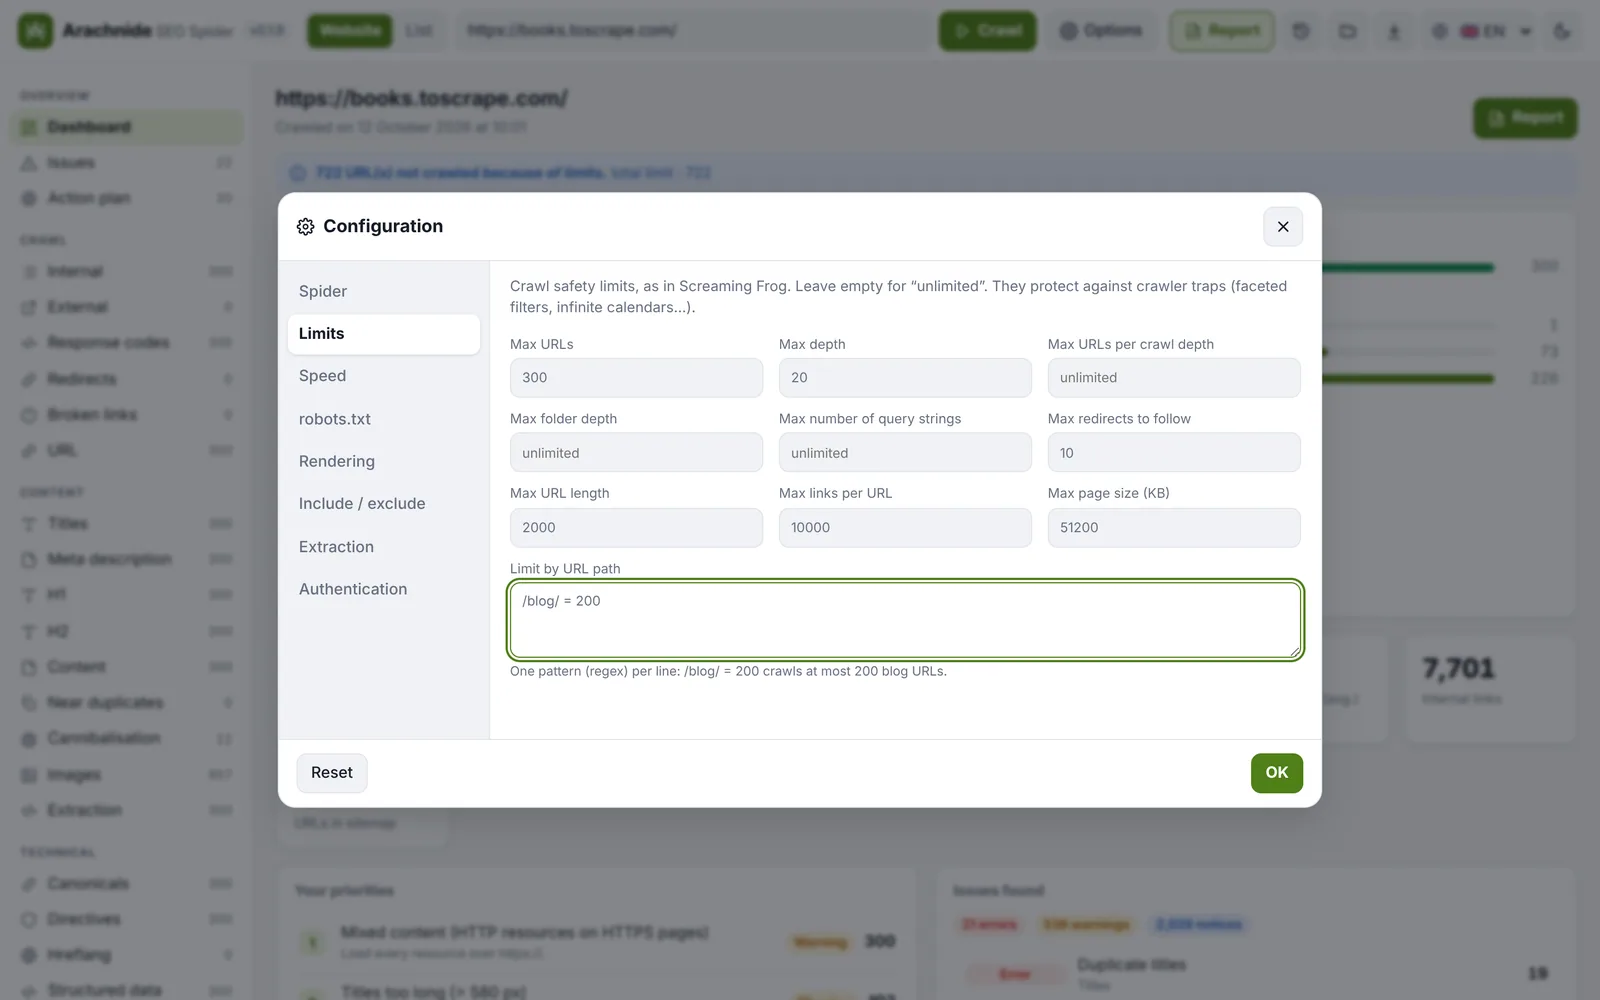
| Límites | Total del rastreo, profundidad de rastreo, URLs por nivel de profundidad, profundidad de carpetas, parámetros de consulta, redirecciones que seguir, longitud de URL, enlaces por página, tamaño de página, límites por ruta de URL (/blog/ = 200, uno por línea) |
| Velocidad | Número máximo de hilos, máximo de URLs por segundo, tiempo de espera |
| robots.txt | Respetar / ignorar pero informar del estado / ignorar, robots.txt personalizado, probador de URLs |
| Renderizado | Renderizado JavaScript, user-agent (Arachnide, Googlebot escritorio/smartphone, Chrome), Accept-Language |
| Incluir / excluir | Regex para incluir / excluir, eliminar parámetros de URL (utm_*, gclid), ignorar todos los parámetros, búsqueda personalizada |
| Extracción | Hasta 20 extractores: selector CSS (texto, atributo, HTML o número) o regex |
| Autenticación | Usuario y contraseña HTTP, cabeceras personalizadas (cookies, tokens) |
Spider
- Leer sitemaps XML (activado): se leen los sitemaps declarados en
robots.txto en/sitemap.xml, incluidos los índices de sitemaps y los archivos.gz, y sus URL se ponen en cola. Los sitemaps de imágenes y vídeos se omiten; se leen como máximo 500 archivos de sitemap. - Seguir canonicals (activado): una canonical que apunta a una URL no rastreada la pone en cola.
- Incluir subdominios (desactivado):
blog.example.comforma parte deexample.comsolo cuando esta opción está activada. Otro puerto nunca es el sitio auditado. - Comprobar enlaces externos y comprobar imágenes (peso, estado, formato) están desactivados por defecto para mantener ligeros los rastreos de sitios de clientes.
Límites
| Ajuste | Por defecto | Notas |
|---|---|---|
Total del rastreo (maxPages) | 500 | Cuenta las páginas realmente descargadas; las URL bloqueadas por robots.txt no lo consumen. Hasta 10 000 000. |
Profundidad de rastreo (maxDepth) | 20 | Las redirecciones no añaden profundidad. |
URL por nivel de profundidad, profundidad de carpetas, parámetros de consulta, redirecciones que seguir (10), longitud de URL, enlaces por página, tamaño de página (maxPageSizeKb) | — | Las URL omitidas se cuentan por motivo en el panel. Los cuerpos de respuesta se leen en flujo y se abandonan más allá del límite de tamaño. |
| Límites por ruta de URL | — | Uno por línea, p. ej. /blog/ = 200. |
Velocidad
- Hilos máximos (
concurrency): 5 por defecto, de 1 a 30. En un sitio de un cliente, quédate entre 2 y 5. - URL máximas por segundo (
maxUrlPerSec): un límite global, útil en alojamientos compartidos. - Pausa entre peticiones por worker, y tiempo de espera.
Las respuestas de limitación de velocidad (429 y 503 con Retry-After) se respetan y se reintentan; 500, 502, 504 y los errores de conexión reciben un reintento diferido al final de la cola.
robots.txt
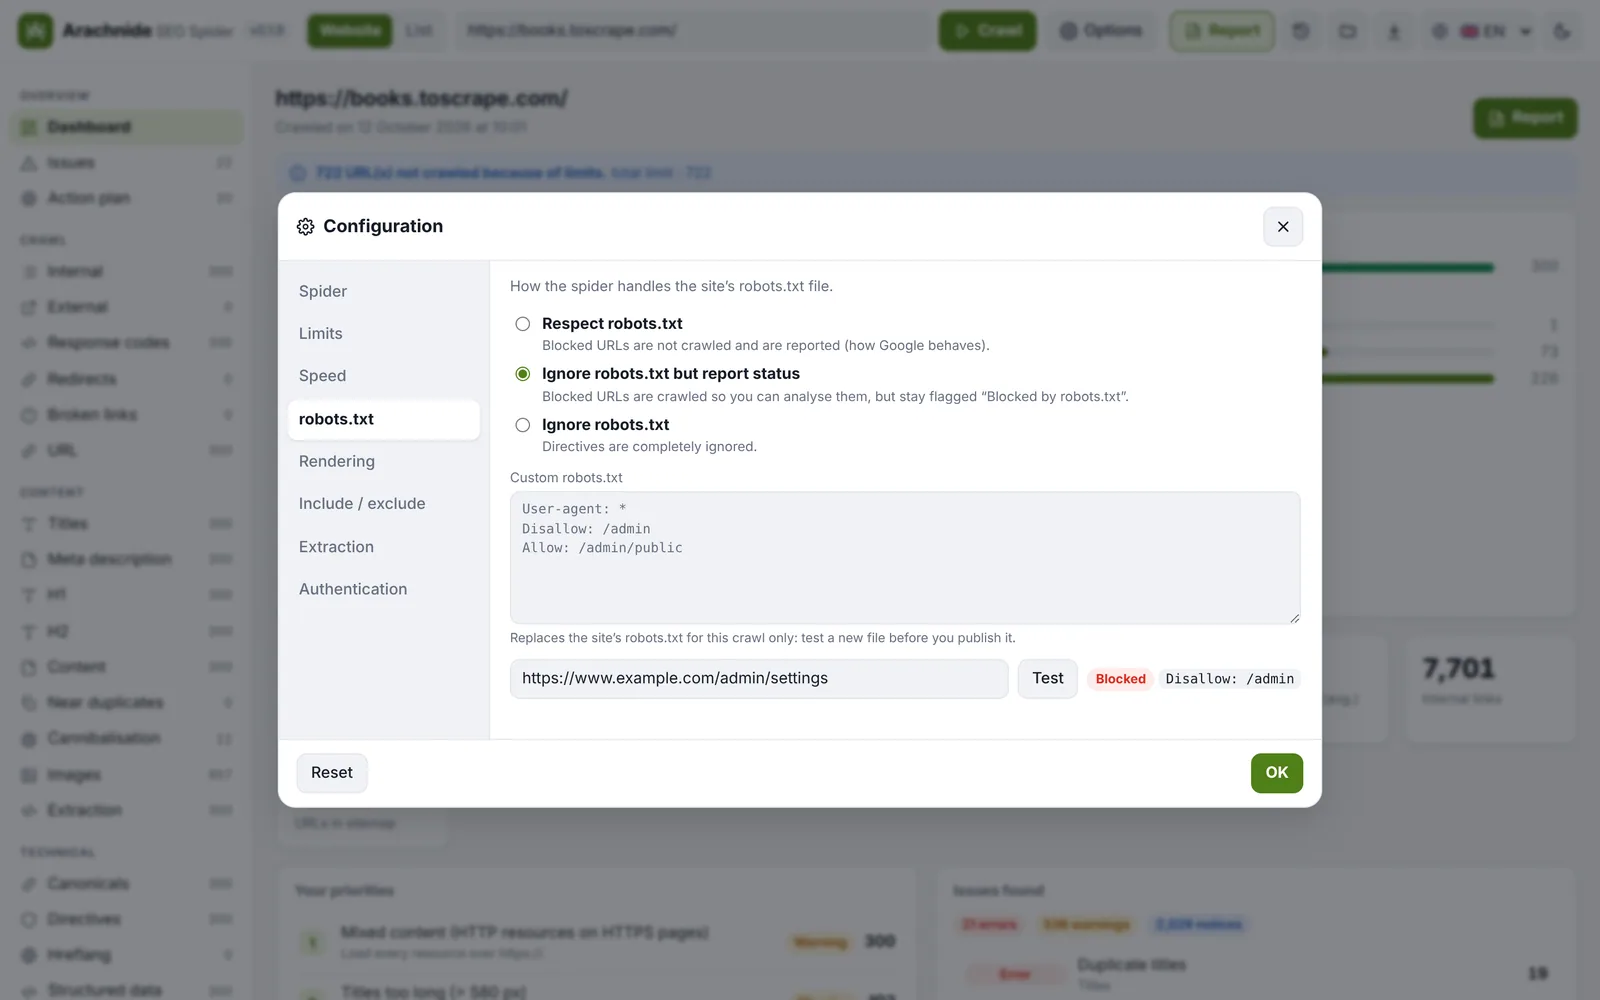
Tres modos: respetar (por defecto), ignorar pero informar (las URL bloqueadas se rastrean y siguen marcadas) e ignorar. Puedes pegar un robots.txt personalizado para probar un archivo antes de publicarlo, y el probador integrado indica si una URL está permitida y qué regla se aplica. Arachnide sigue las reglas de Google para robots.txt (RFC 9309):
- un robots.txt que responde 4xx significa que todo está permitido;
- un robots.txt en 5xx o inaccesible significa que todo está prohibido, con una advertencia explícita. Dos salidas: la opción robots.txt no disponible → permitir (
--robots-unavailable allow), o el modo informar / ignorar; - en modo lista y con subdominios, robots.txt se lee una vez por host.
Renderizado
El renderizado JavaScript usa el Chrome, Edge, Chromium o Brave ya instalado (mediante puppeteer-core; no se descarga nada). Arachnide compara el HTML bruto con la página renderizada (contenido, enlaces, title, H1, canonical, noindex), informa de los errores JS y de las redirecciones JavaScript, y mide LCP y CLS de laboratorio. Chrome se reinicia cada 500 páginas renderizadas para acotar su memoria, y se reinicia una vez si muere.
User-agent: Arachnide (por defecto), Googlebot escritorio, Googlebot smartphone, Chrome, o una cadena personalizada. Como Googlebot, no se envía ninguna cabecera Accept-Language por defecto; puedes definir una. Si un sitio responde 403 al agente de Arachnide, el rastreo cambia a Chrome automáticamente y lo indica.
Incluir / excluir
- Incluir y excluir: una expresión regular por línea. Una línea no válida se ignora y se señala. La URL de inicio siempre se rastrea.
- Permanecer en el directorio de inicio:
https://example.com/blog/rastrea solo/blog/…. - Eliminar parámetros de URL como
utm_*ogclid(se admiten comodines). Desde la 3.21, los parámetros se ordenan por clave y los parámetros de seguimiento conocidos (utm_*,gclid,fbclid,msclkid,mc_cid,srsltid,_ga…) se eliminan por defecto, de modo que?a=1&b=2y?b=2&a=1son una sola página; conservar los parámetros tal cual restablece el comportamiento bruto. - Ignorar todos los parámetros, y búsqueda personalizada (un texto o una
/regex/que buscar en el código fuente). - Una ruta que produce 200 variantes de parámetros se señala una vez como trampa de facetas, la firma de filtros combinables que se comen el presupuesto.
Extracción
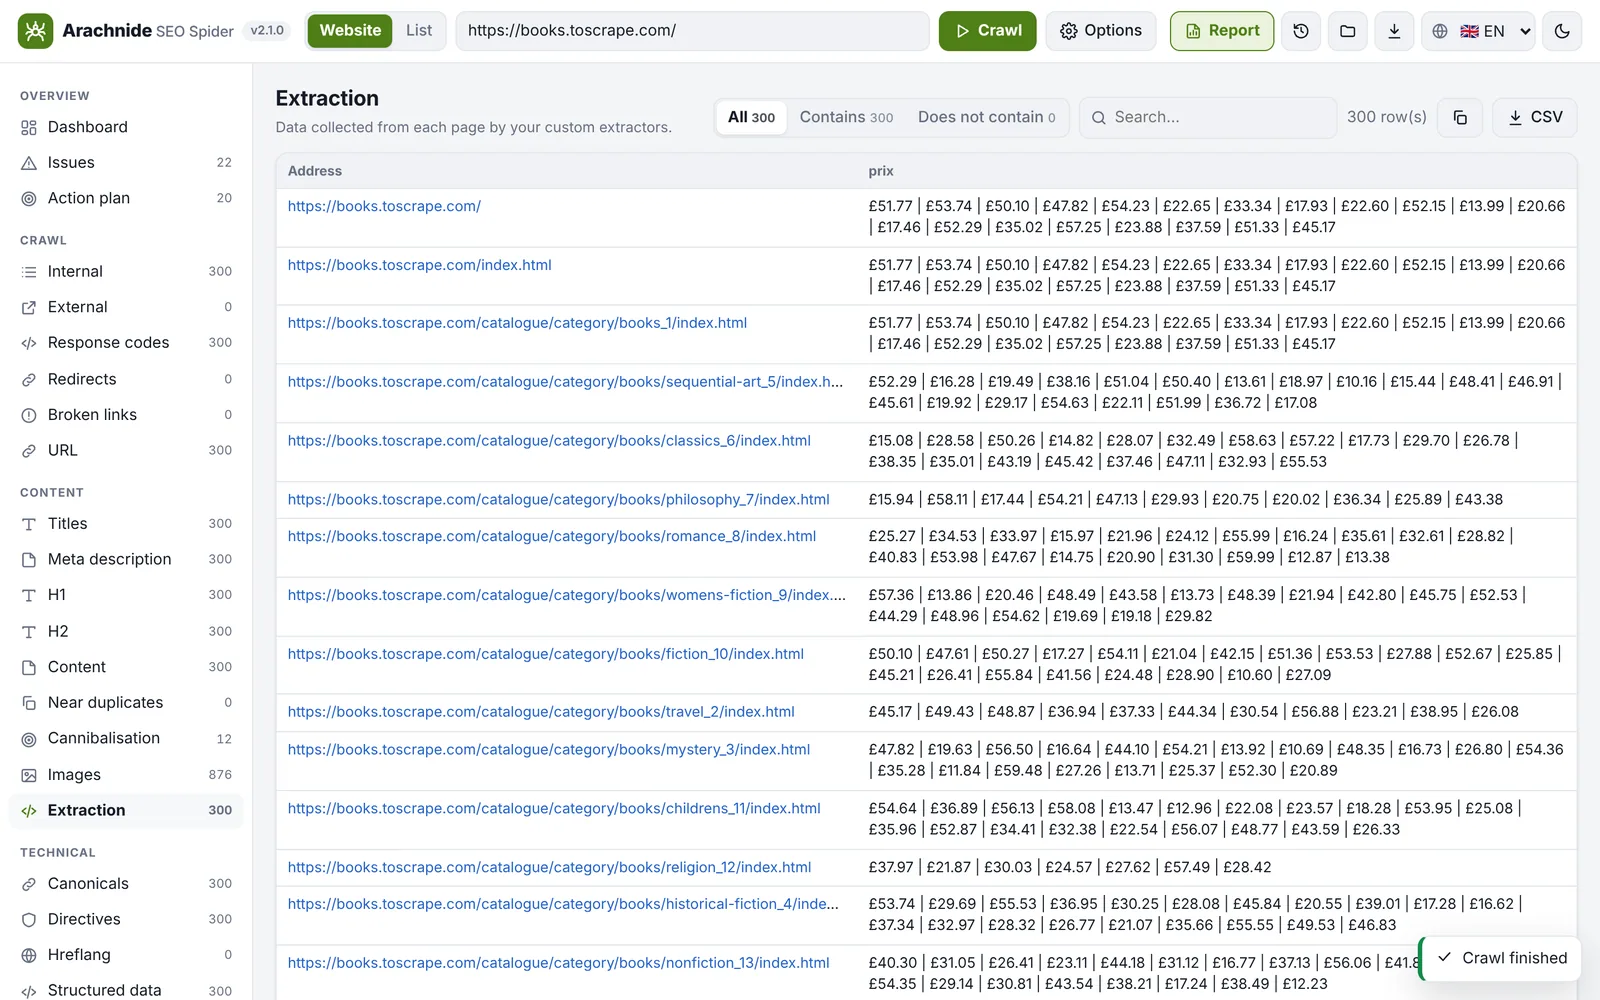
Hasta 20 extractores, cada uno con un nombre y una regla:
- Selector CSS con un objetivo: texto, atributo, HTML interno o número de coincidencias;
- XPath (3.21): evaluado en Chrome en modo renderizado, o sobre el HTML bruto mediante
jsdom, una dependencia opcional que solo se carga cuando existe una regla XPath (npm install jsdomsi ves la advertencia); - Regex, ejecutada en un worker con un tiempo límite de 2 segundos: un patrón catastrófico se interrumpe para esa página y el rastreo continúa.
Los valores aparecen en la pestaña Extracción, en una columna por regla en pages.csv, y pueden alimentar segmentos con el campo extract:<nombre>. La CLI acepta las mismas reglas con --extract (consulta Línea de comandos).
Autenticación
Autenticación HTTP (usuario y contraseña) y cabeceras personalizadas (cookies, tokens) para sitios de preproducción. Solo se envían al sitio auditado, también en modo renderizado, y nunca se guardan.
Modos sitio, lista y sitemap
El selector junto al campo de dirección elige entre rastrear un sitio web (siguiendo los enlaces) y una lista de URL que pegas (hasta 500 000 URL desde la 3.21; los enlaces no se siguen y el enlazado interno queda no medido). La CLI añade --list urls.txt y --sitemap URL, que rastrea exactamente las URL de un sitemap o de un índice de sitemaps, deduplicadas y normalizadas. Los agentes de IA tienen los mismos modos mediante mode, urls y sitemap_url en las herramientas de rastreo.
Reanudar un rastreo interrumpido
Durante un rastreo, Arachnide escribe un diario de reanudación (crawls/.en-cours/<id>.ndjson): cada URL puesta en cola, cada página procesada. Tras un fallo o una parada, el diario aparece en la pantalla de inicio y el rastreo puede reanudarse donde se detuvo, perdiendo solo los últimos segundos. El diario se elimina cuando el rastreo termina. En la CLI: --resume ARCHIVO, o --no-journal para no escribir nada.